
LA SETTIMANA IN AI
12–18 ottobre 2026
Tutte le 52 notizie verificate pubblicate dal 12/10 al 18/10/2026, raccolte in un unico archivio settimanale.
In questa settimana 52 notizie
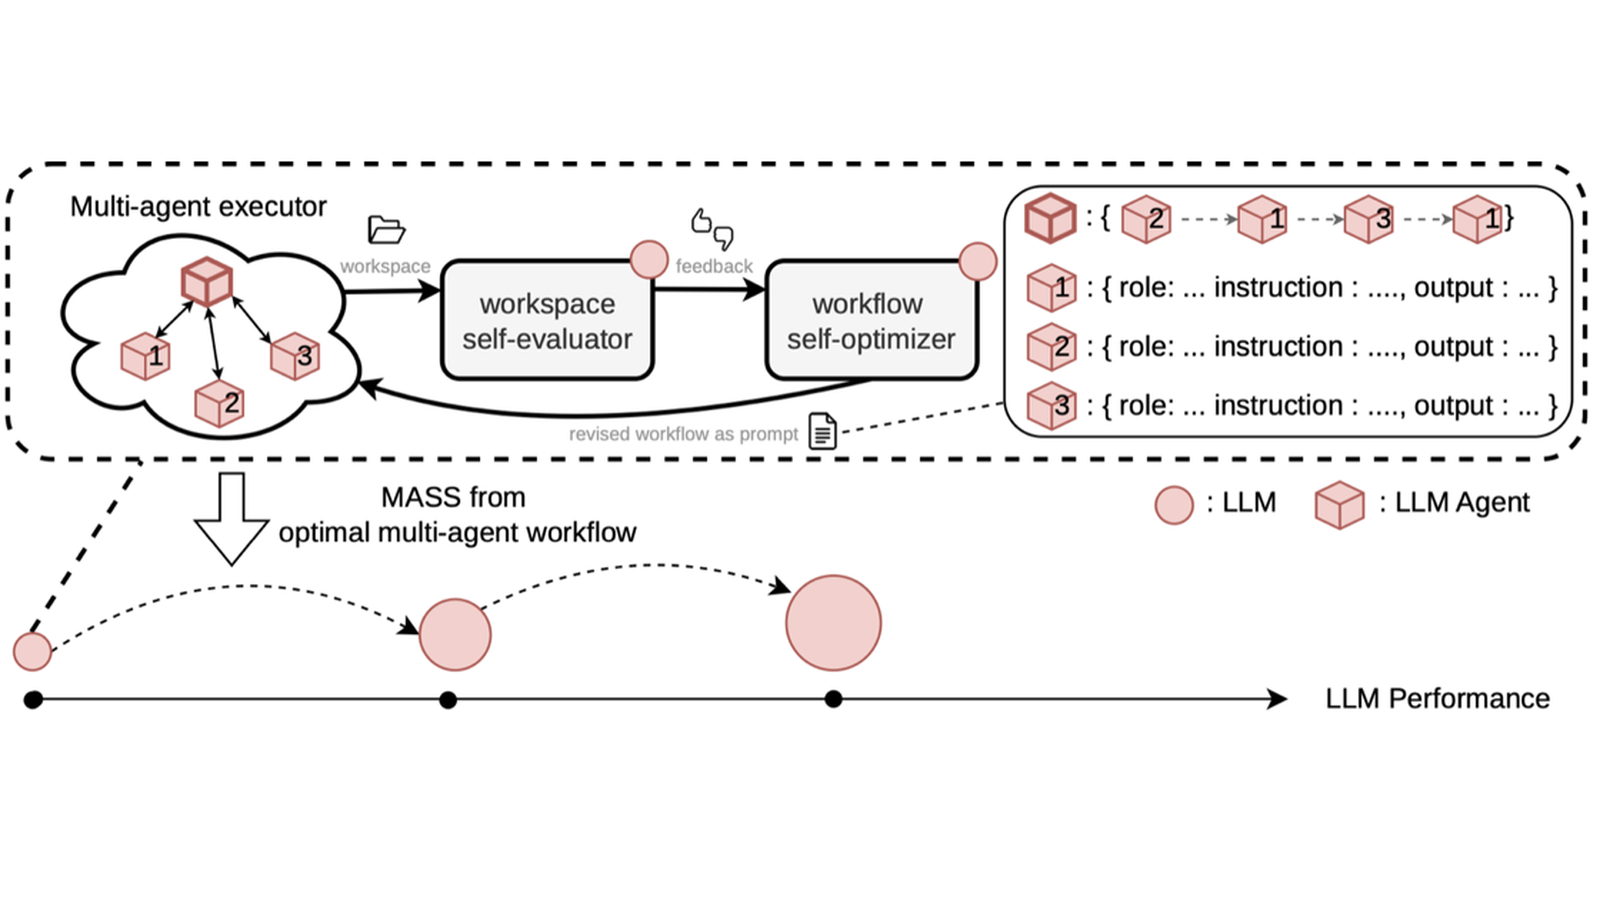
Sakana AI e UC Berkeley presentano MASS: il sistema ottimizza un workflow multi-agente, seleziona le esecuzioni migliori e le distilla con LoRA nello stesso modello che svolge i ruoli di esecutore, ottimizzatore e valutatore. Gli autori riportano miglioramenti per token e, sui tre task holdout, un win rate del 69,9% del secondo round rispetto al modello base.
Limiti da conoscere
Limite: I risultati dichiarati riguardano 12 task sintetici in finanza, robotica e farmacia, con tre task holdout. La supervisione resta in parte interna allo stesso modello e può condividere blind spot; non è una prova di miglioramento ricorsivo in produzione né di generalizzazione ad altri modelli o workflow.
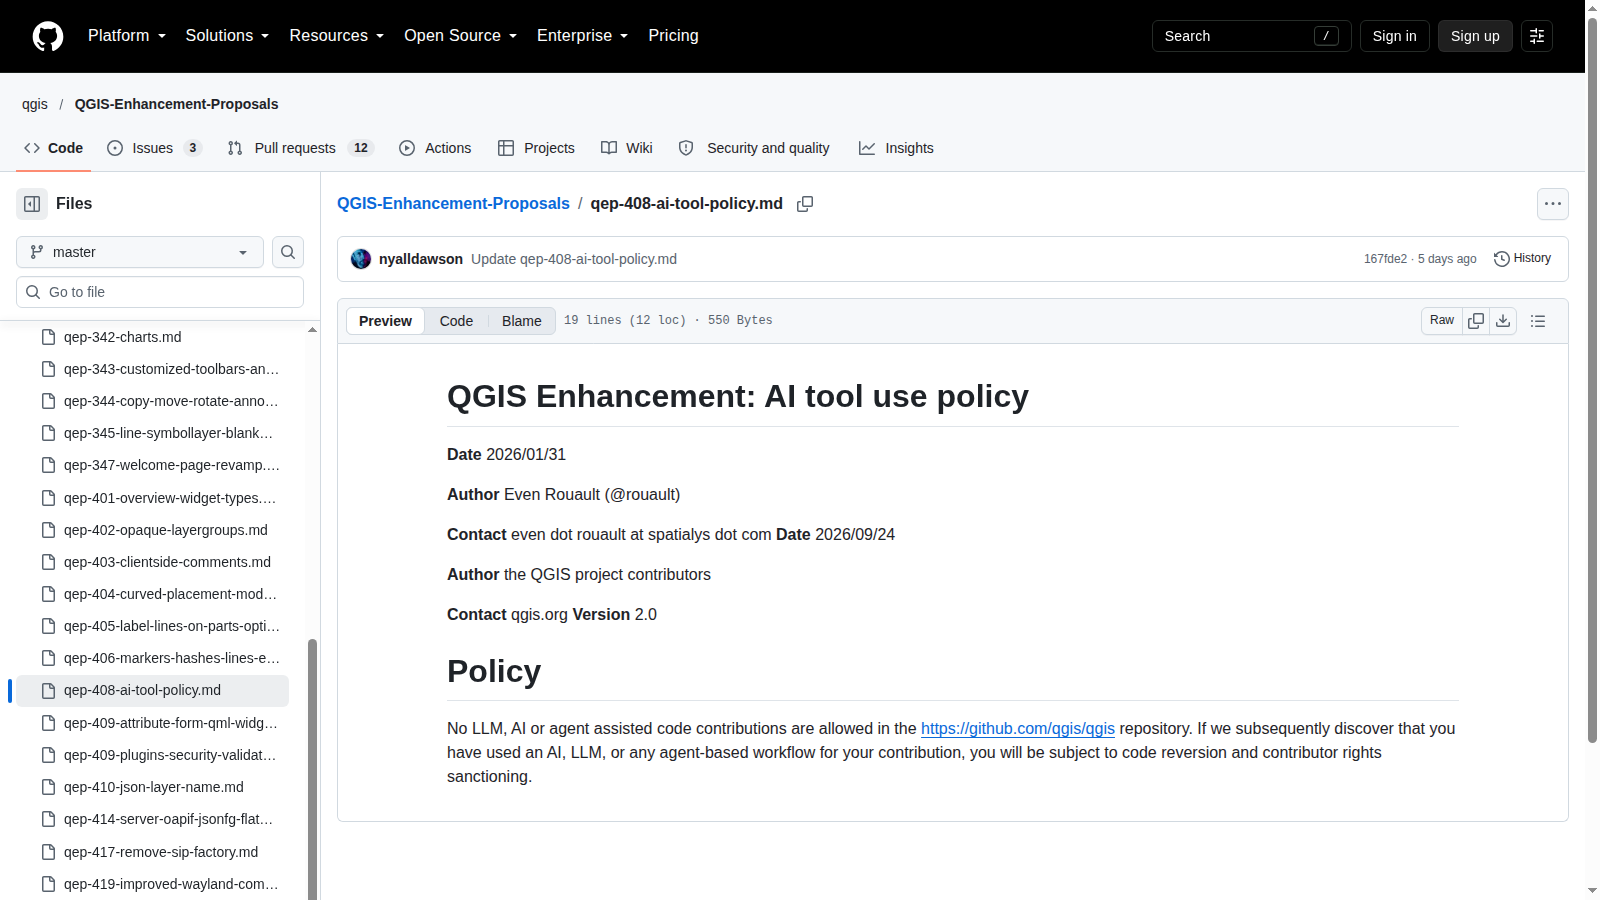
QGIS ha accettato e integrato QEP 428: nel repository qgis/QGIS non sono ammessi contributi di codice assistiti da LLM, AI o agenti. La policy prevede la possibile reversione del codice e sanzioni sui diritti di contribuzione se l’uso viene scoperto successivamente.
Limiti da conoscere
Limite: La regola riguarda i contributi al repository principale qgis/QGIS e non dimostra che il codice generato sia sempre difettoso. Il testo pubblico è molto breve e non descrive un metodo tecnico di rilevamento, eccezioni o una procedura dettagliata di appello.
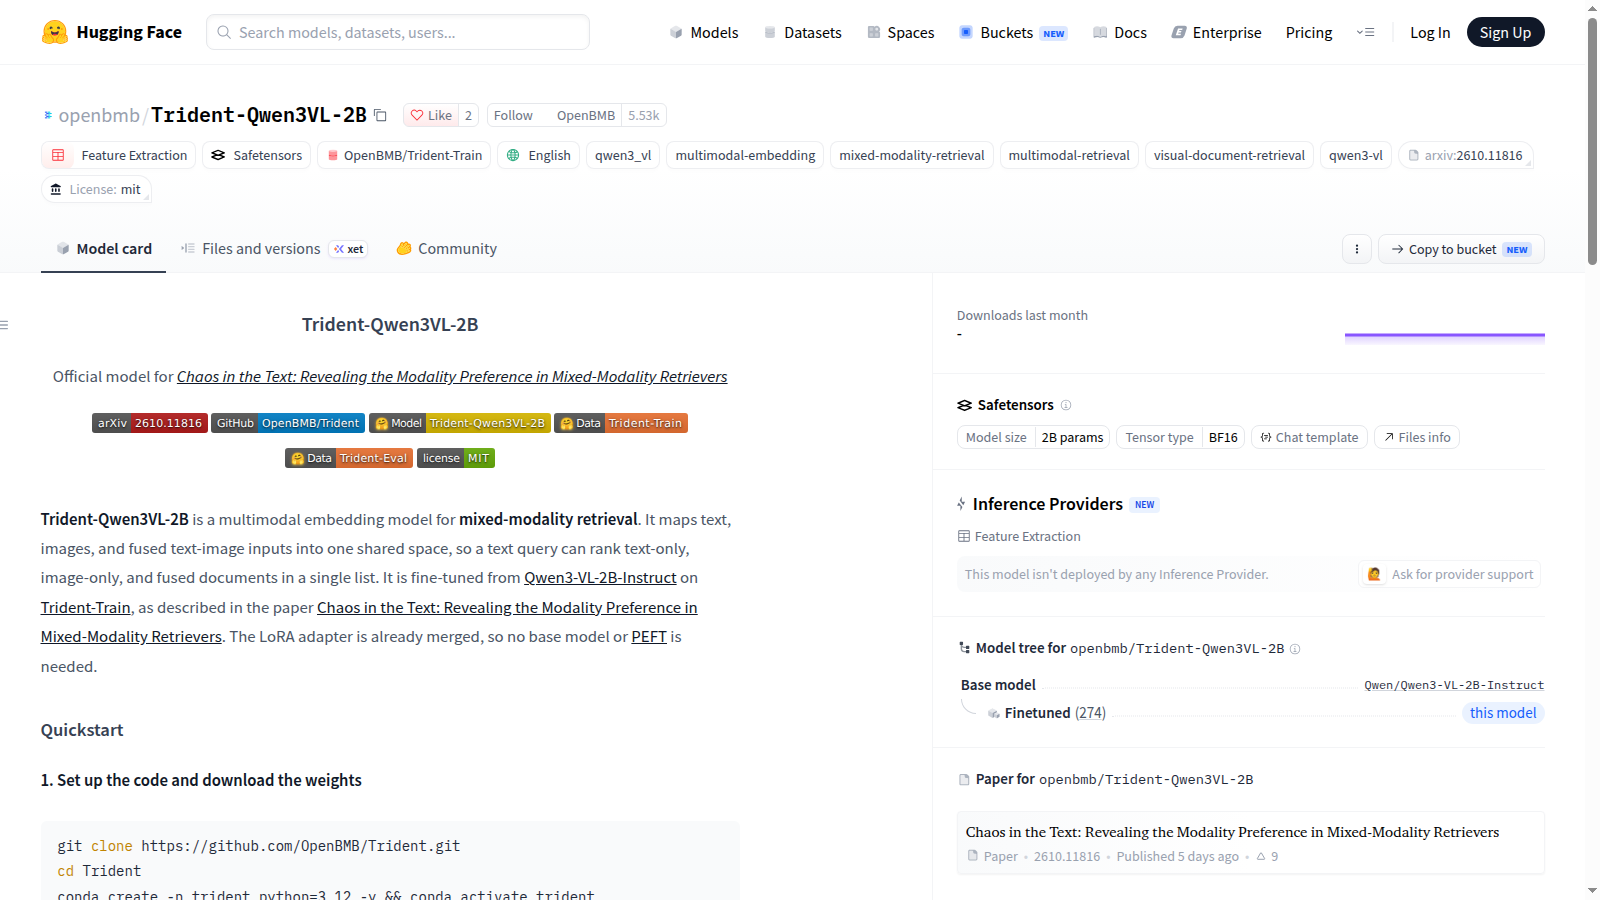
OpenBMB ha pubblicato pesi e codice di Trident-Qwen3VL-2B, un embedding model da 2,13 miliardi di parametri che colloca testo, immagini e input fusi nello stesso spazio. Il LoRA è già incorporato e il quickstart permette di ordinare documenti di modalità diverse con un unico prodotto scalare.
Limiti da conoscere
Limite: Il modello è appena pubblicato, non è servito da provider di inferenza e richiede una GPU CUDA nel quickstart ufficiale. I risultati del paper e dei dataset associati restano evidenza degli autori: prima di usarlo in un RAG reale vanno misurati recall, latenza e bias di modalità sul proprio corpus.
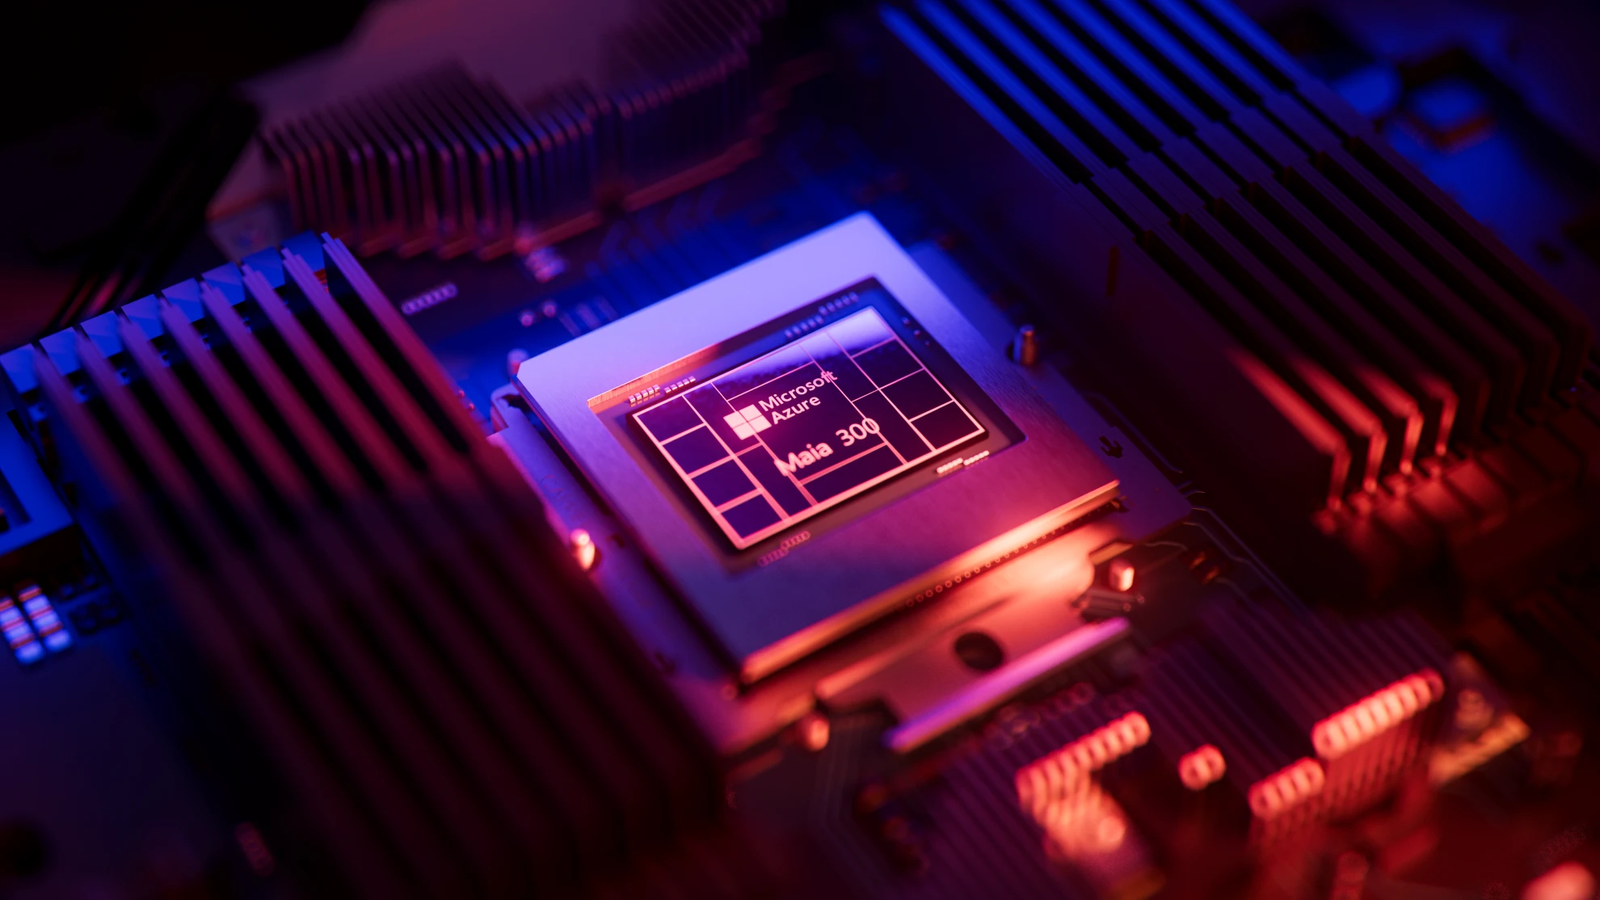
Microsoft prevede di portare Azure Maia a deployment multi-gigawatt dal 2027 e di usarlo come sistema primario di inferenza per i propri prodotti e servizi. Maia 300 integra chip, memoria, rete, rack, software e datacenter per carichi long-context e agentici; Microsoft dichiara il 40% di token in più per megawatt rispetto ai principali sistemi GPU e fino a 7 volte il throughput rack-scale di Maia 200.
Limiti da conoscere
Limite: Maia 300 non è ancora un servizio acquistabile: la produzione è prevista nel 2027. Efficienza e throughput sono dichiarazioni Microsoft, senza benchmark indipendenti pubblicati; non sono ancora disponibili prezzi, configurazioni Azure o prove comparabili a parità di modello e qualità.
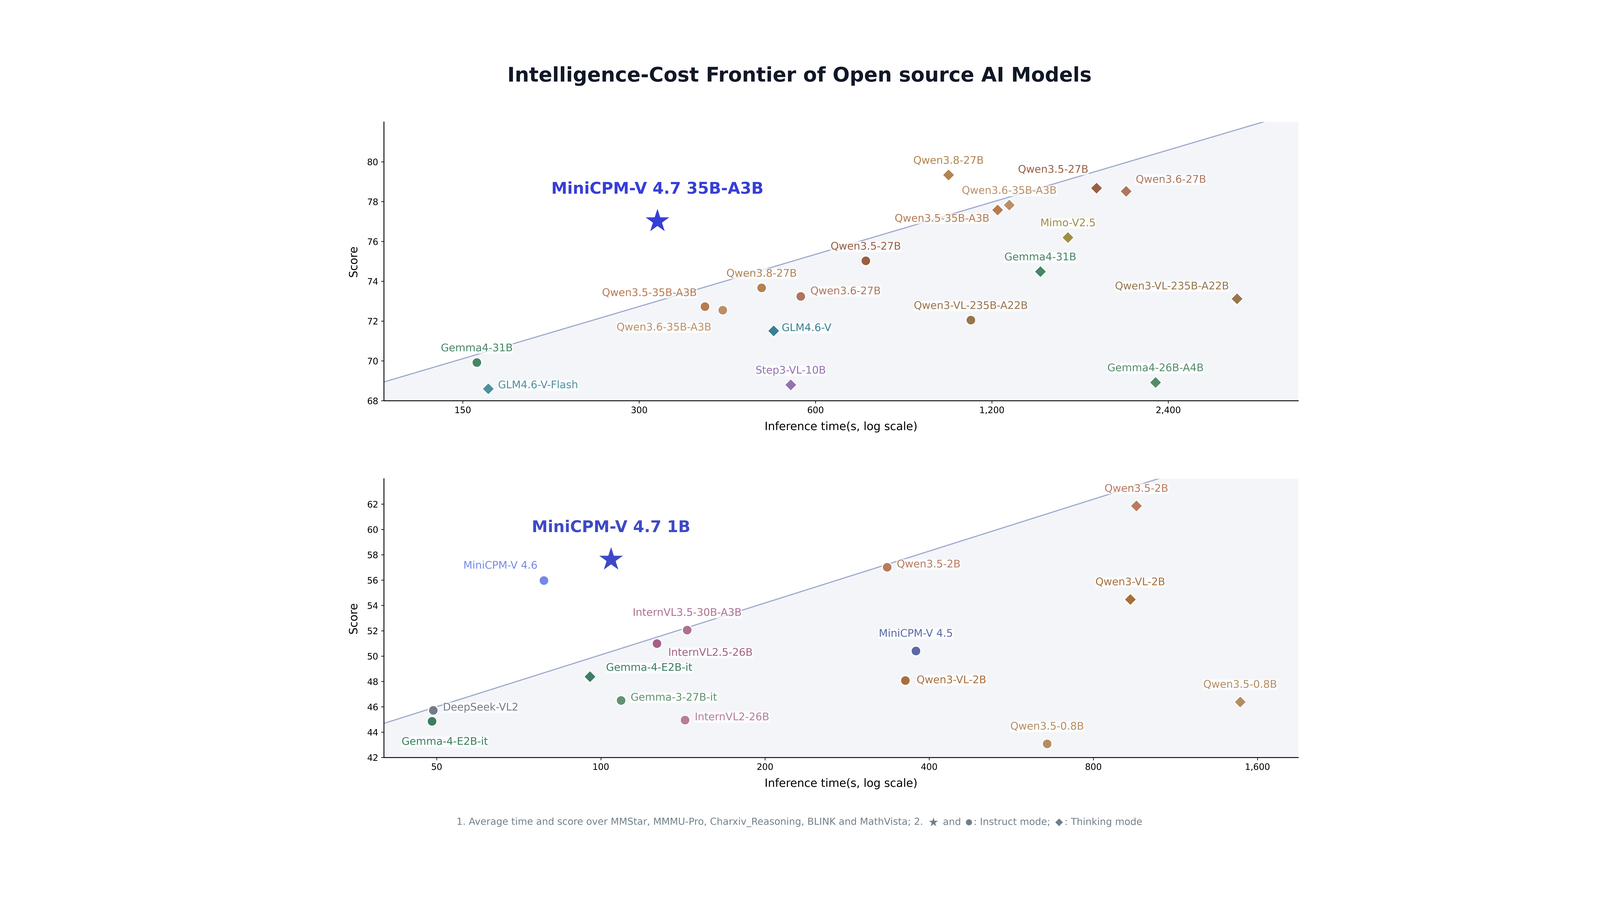
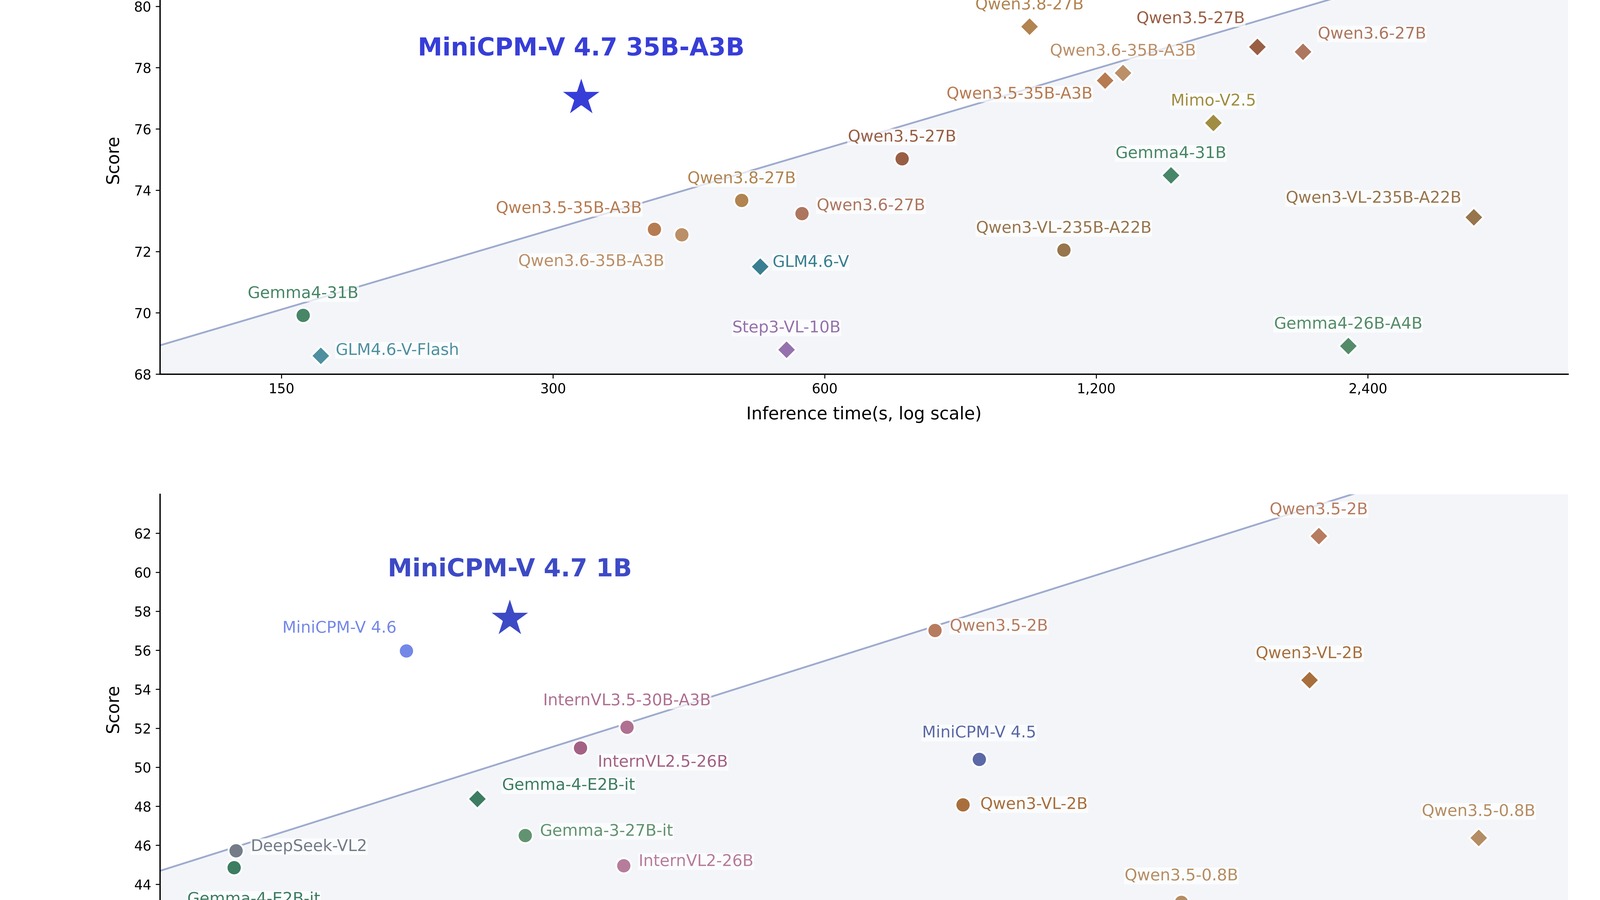
OpenBMB ha reso scaricabili MiniCPM-V 4.7 in due taglie, 1B e 35B-A3B, insieme a varianti GGUF, INT4, AWQ, GPTQ, FP8 e modelli draft DSpark. La famiglia gestisce immagini, video e testo, supporta Transformers, llama.cpp e Ollama e introduce compressione visuale 4x o 16x; il modello 35B-A3B usa una struttura Mixture of Experts con 3 miliardi di parametri attivi.
Limiti da conoscere
Limite: Prestazioni, confronti e 13+ token al secondo su iPhone 17 Pro Max sono misure dichiarate da OpenBMB, non test indipendenti. Il percorso mobile del 35B richiede tecniche e runtime dedicati; il quickstart Transformers richiede almeno la versione 5.18 e l’integrazione OpenVINO indicata nella scheda contiene ancora un collegamento da completare.
IBM ha aggiornato una demo statica che esegue nel browser la dettatura in tempo reale con Granite Speech 5.0 TurboCTC, WebGPU e pesi ONNX quantizzati. Audio e inferenza restano sul dispositivo; il primo caricamento scarica circa 550 MB e la demo richiede Chrome o Edge desktop con WebGPU.
Limiti da conoscere
Limite: Le misure sono dichiarate nel README della demo su un M1 Max e su otto minuti di LibriSpeech dev-clean, non sono un test indipendente. Il supporto mobile è escluso e il fallback WASM indicato dal progetto non mantiene una latenza da dettatura live.
LightOn ha pubblicato ColGrep-Agent-2B, un modello open da 2 miliardi di parametri che usa ricerca semantica e letture in sola lettura per restituire file e intervalli di righe rilevanti. Il modello gira localmente, dispone di pesi GGUF e si integra tramite hook con Claude Code, Codex e OpenCode. Nei test degli autori su 52 domande di localizzazione ha ridotto del 34,3% i token API rispetto a grep.
Limiti da conoscere
Limite: Il confronto è prodotto dagli autori, riguarda 52 domande di ricerca nel codice e non attività di sviluppo complete. L’accuratezza osservata è 80,8% contro 83,3% con grep, con intervallo ampio, mentre il tempo medio cresce da 13,0 a 21,6 secondi; i risultati non equivalgono a una verifica indipendente.
OpenBMB ha pubblicato repository GGUF ufficiali per MiniCPM-V 4.7 1B e 35B-A3B, con file F16, Q4, Q5, Q6 e Q8 e proiettori multimodali dedicati. Il delta rende disponibili artefatti pronti per llama.cpp e inferenza CPU, invece dei soli pesi e riferimenti alle quantizzazioni presenti nel rilascio iniziale.
Limiti da conoscere
Limite: La disponibilità dei file non equivale a compatibilità verificata su ogni build di llama.cpp. Le prestazioni e il dato di 13+ token al secondo su iPhone 17 Pro Max restano dichiarazioni di OpenBMB; dimensione, memoria e qualità delle singole quantizzazioni vanno misurate sul dispositivo reale.
Character.AI ha avviato volontariamente il Chapter 11 per cercare una vendita supervisionata dal tribunale. La piattaforma resta operativa e gli abbonamenti non cambiano per ora, ma la società afferma che, senza un’offerta praticabile, il servizio verrà chiuso. La conclusione del processo è prevista tra fine novembre e inizio dicembre 2026.
Limiti da conoscere
Limite: Il Chapter 11 non equivale a una chiusura già decisa e non identifica ancora un acquirente. Character.AI dichiara invariati servizio, fatturazione e pratiche sui dati, ma l’esito dipende dalla vendita: chi conserva chat importanti dovrebbe esportarle senza attendere l’esito finale.
Google ha reso Gemini 4 Argon disponibile globalmente nel livello a pagamento della Gemini API, in AI Studio e per clienti enterprise, oltre che agli abbonati Pro e Ultra nelle interfacce consumer. Il prezzo introduttivo dichiarato è 2 dollari per milione di token in input e 10 dollari in output, con input in cache scontato del 95% e un limite unificato input-output fino a un milione di token.
Limiti da conoscere
Limite: Disponibilità non significa accesso gratuito né assenza di restrizioni: le funzioni cyber senza guardrail restano nel programma Fairwind e diverse prove pubblicate sono casi selezionati da Google, non test indipendenti. Prima di migrare carichi reali vanno verificati quota, latenza, protocollo di continuazione e costo effettivo sui propri prompt.
GitHub ha descritto la pipeline a due stadi usata per i secret generici: regex ad alta copertura e un classificatore ModernBERT che valuta candidato e contesto. Nei test dichiarati, rispetto alla precedente pipeline LLM, l’accettazione pesata per proprietario cresce dell’11,5%, il tempo mediano post-push scende dell’86% e il costo di serving di oltre il 98%.
Limiti da conoscere
Limite: Sono risultati interni GitHub, non una replica indipendente. I pesi, il dataset e le soglie non sono pubblicati; i numeri online riguardano traffico e prodotto GitHub e non dimostrano che lo stesso modello mantenga precisione e richiamo in un deployment diverso.
Anthropic ha descritto Scion, il sistema di controllo versione interno con cui ha migrato in cinque mesi il proprio monorepo da Git. Il carico dichiarato è salito da circa 2.500 merge al giorno a maggio a oltre 30.000 a settembre, con una cronologia della main vicina a 100 GB e circa 25 milioni di checkout CI al giorno. Scion centralizza metadati e contenuti, usa snapshot immutabili e sposta il lavoro pesante sui server per sostenere agenti e automazione su scala interna.
Limiti da conoscere
Limite: Scion non è stato rilasciato come prodotto o progetto open source e il caso Anthropic è eccezionale: numeri, benefici e tempi derivano dal team che lo ha costruito. Per la maggior parte dei repository Git resta la scelta appropriata; l’analisi serve a riconoscere i colli di bottiglia, non a suggerire una migrazione immediata.
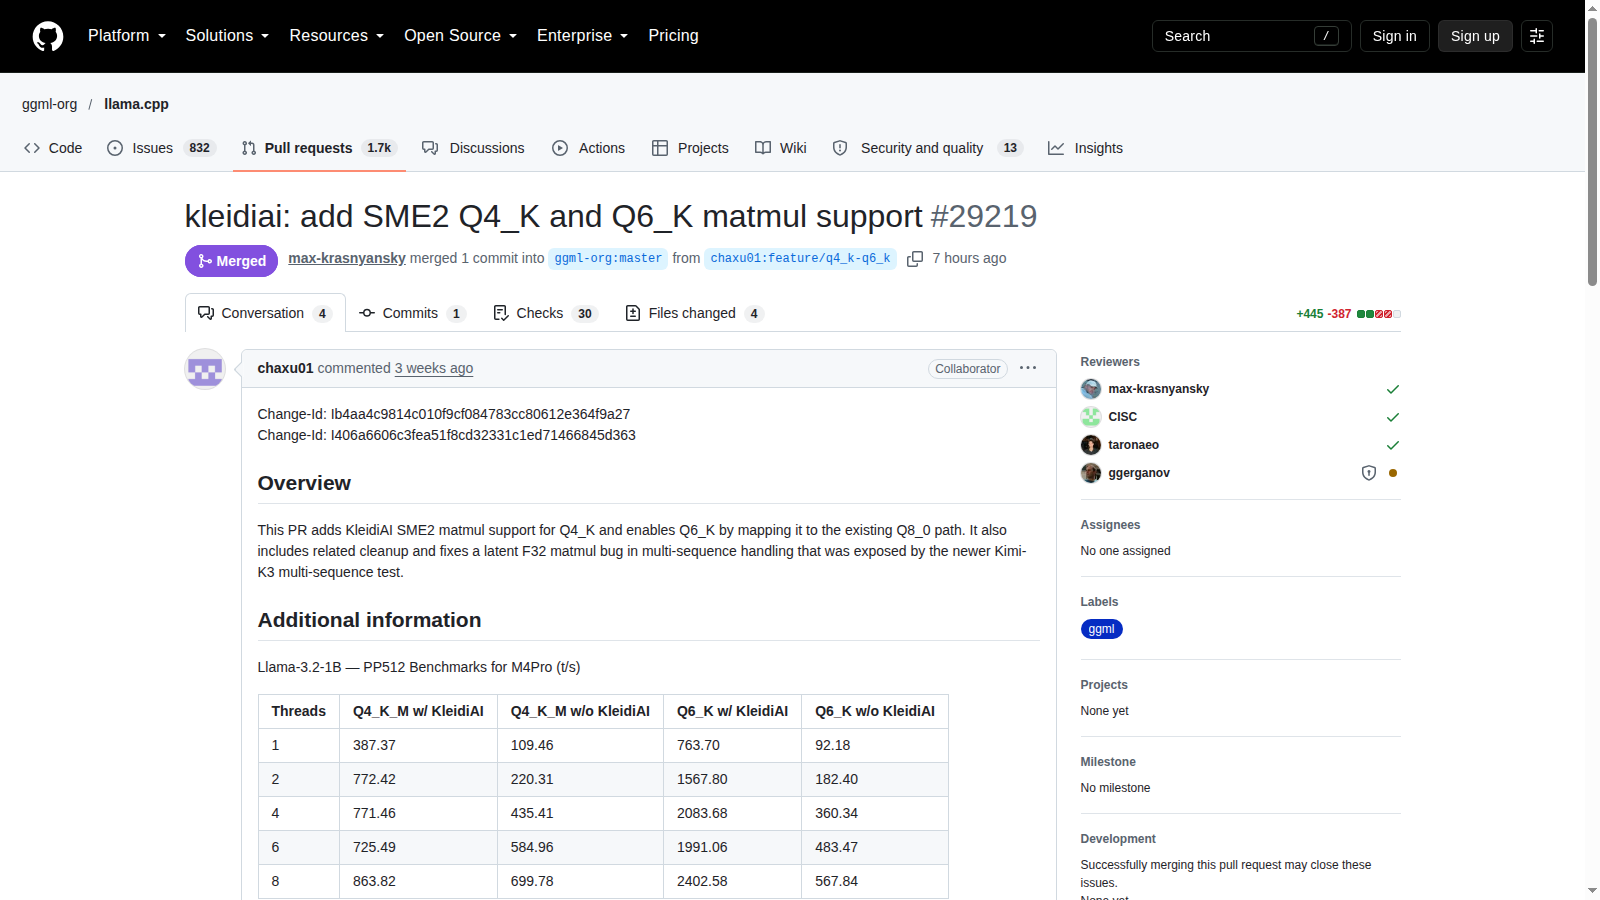
La build pre-release b11604 di llama.cpp integra kernel KleidiAI SME2 per la moltiplicazione di matrici Q4_K e abilita Q6_K attraverso il percorso Q8_0. La modifica interessa CPU Arm con SME2, corregge anche un bug F32 emerso nei test multi-sequenza e include binari Arm64 scaricabili per Linux, Android e Windows.
Limiti da conoscere
Limite: È una build pre-release e non un rilascio stabile. I benchmark della pull request sono misure dei contributori su M4 Pro: mostrano forti guadagni nel test Llama 3.2 1B, ma un maintainer segnala che su prompt lunghi il percorso può restare inferiore ai kernel MM_INT8. Hardware, modello, lunghezza del prompt e build vanno quindi verificati separatamente.
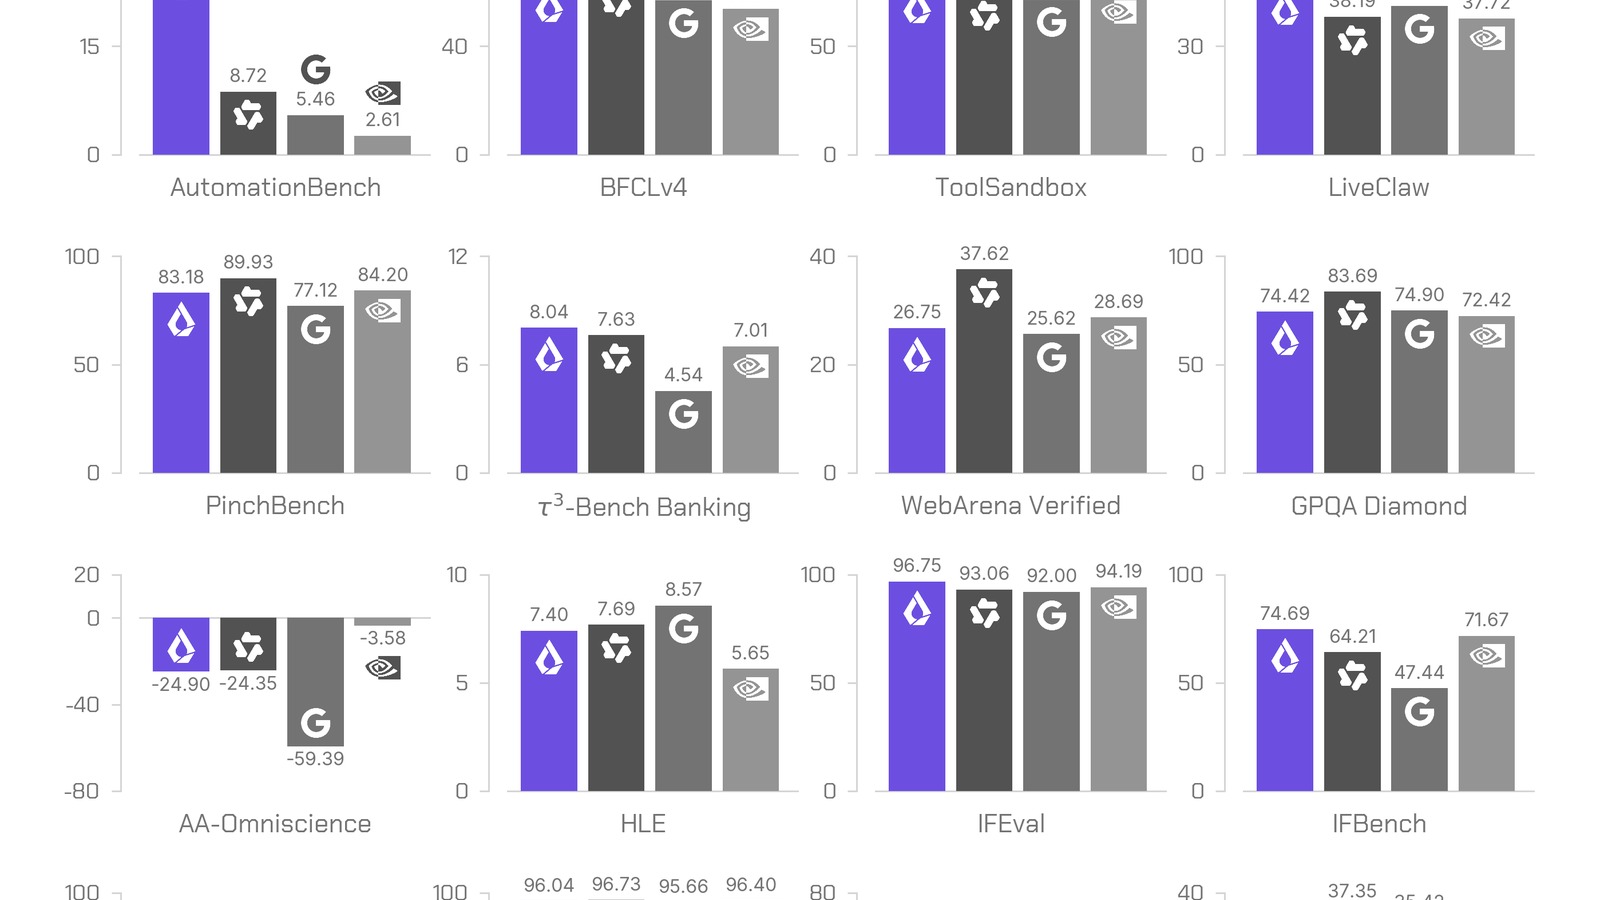
Liquid AI ha rilasciato i pesi base e post-addestrati di LFM2.5-24B-A2B, un modello testuale da 24 miliardi di parametri con 2 miliardi attivi per token. Il pacchetto include checkpoint nativo, FP8, GGUF, ONNX e MLX 4-bit, contesto da 131K token e configurazioni per collegarlo a harness locali tramite backend compatibili OpenAI.
Limiti da conoscere
Limite: Prestazioni, velocità e confronti agentici provengono dai test di Liquid AI e non da una verifica indipendente. Open-weight non significa assenza di vincoli: la licenza LFM va letta prima dell’uso, 24B di pesi richiedono comunque memoria adeguata e il modello è text-only.
In un caso cliente pubblicato da OpenAI, Higgsfield dichiara di essere passata da video limitati a circa un minuto a contenuti oltre i 10 minuti. Il workflow usa agenti basati su GPT-6 Astra, chiamate a strumenti esterni e asset generati o modificabili per assemblare tutorial lunghi, mentre GPT-Image-2.5 viene impiegato per immagini e infografiche.
Limiti da conoscere
Limite: È una testimonianza congiunta del fornitore e del cliente, non un benchmark indipendente. Non sono pubblicati costo per video, tempi completi, numero di tentativi, tasso di errore o minuti di lavoro umano; oltre dieci minuti descrive la durata dell’output assemblato, non dieci minuti generati in una singola inferenza continua.
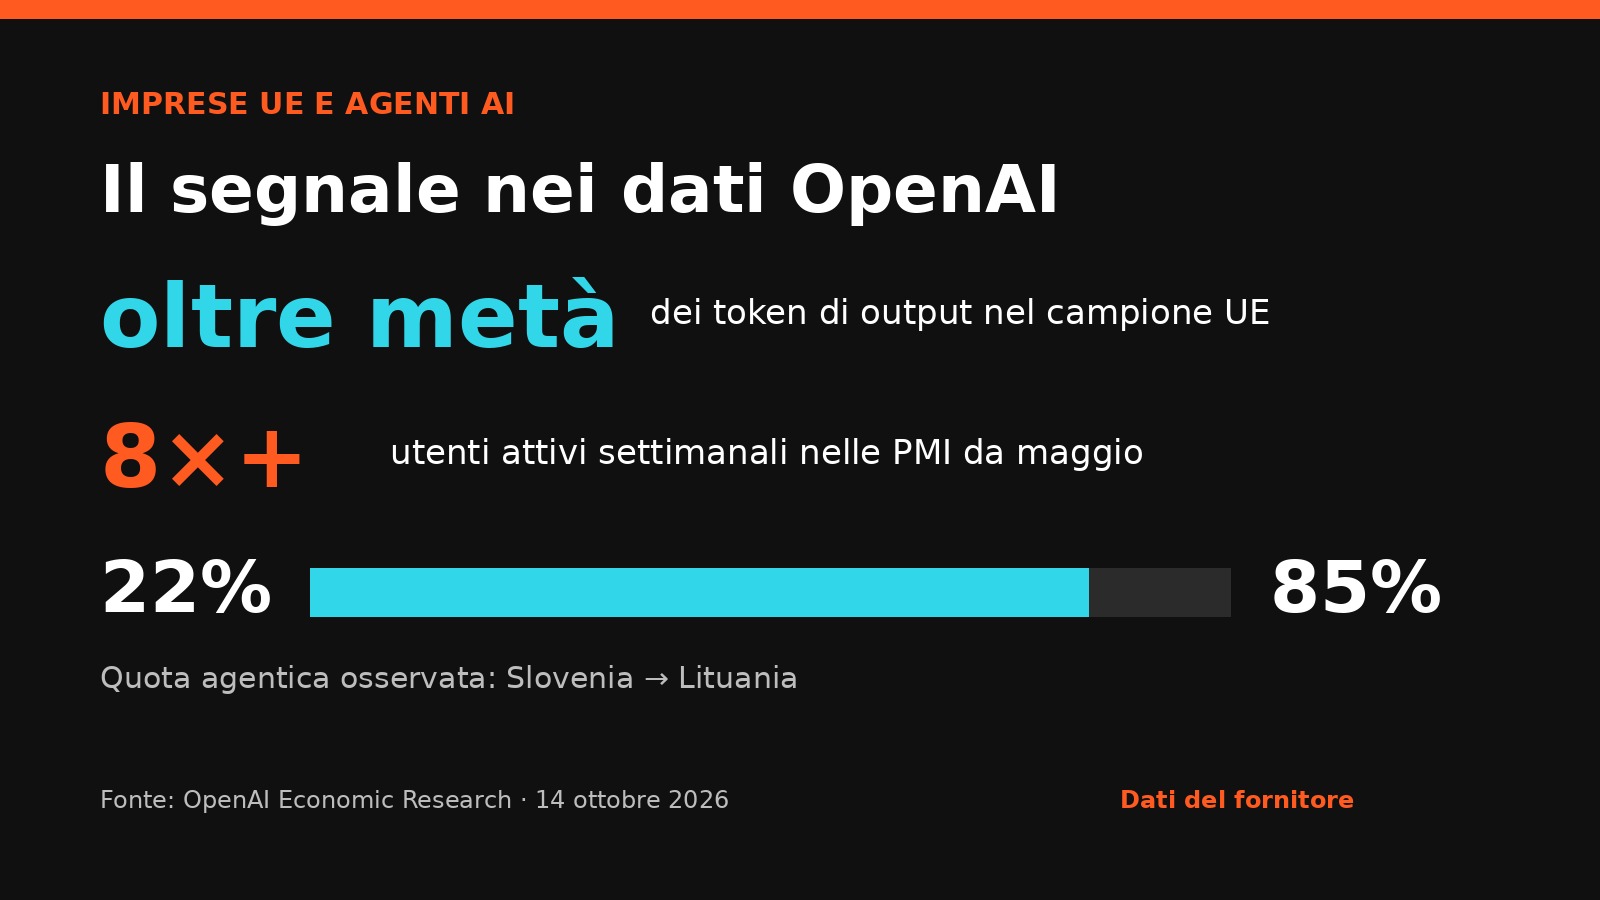
Nel campione europeo di clienti ChatGPT Enterprise analizzato da OpenAI, Codex e ChatGPT Work generano oltre metà dei token di output. Tra le PMI europee, gli utenti attivi settimanali dei due strumenti sono cresciuti di oltre otto volte da maggio 2026; la quota agentica varia però dal 22% in Slovenia all’85% in Lituania.
Limiti da conoscere
Limite: Sono dati osservazionali interni di OpenAI su propri clienti, non una misura rappresentativa di tutte le imprese UE e non una prova di produttività. Token prodotti, utenti attivi e valore economico sono metriche diverse; il confronto tra Paesi può riflettere composizione del campione, settore e maturità degli account.
Anthropic ha eseguito un esperimento controllato sulla replica autonoma: modelli fino a 30B completano già molti passaggi separati, mentre GLM-5.2 e modelli più forti riescono nella catena semplificata end-to-end. Un modello 9B ha avviato l’inferenza su 8 dei 9 tipi di hardware provati.
Limiti da conoscere
Limite: Il test semplifica la fase di exploit, usa dispositivi acquistati e messi in rete dai ricercatori e non dimostra un worm autonomo attivo nel mondo reale. La previsione secondo cui piccoli modelli potrebbero raggiungere questa capacità entro fine 2026 è un’estrapolazione, non un risultato già osservato.
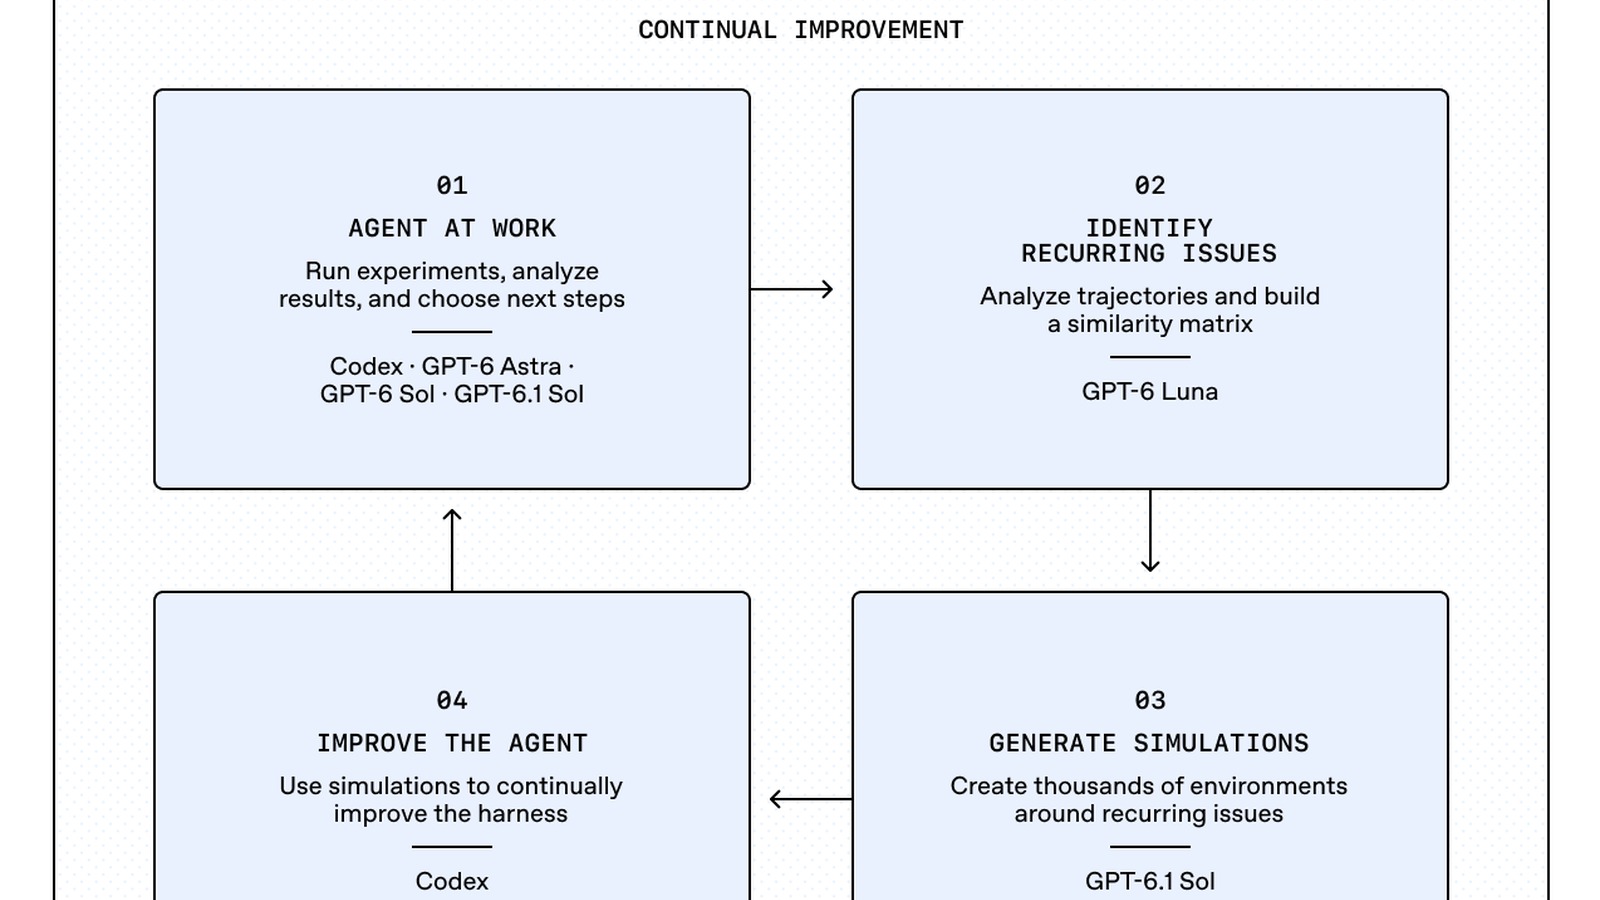
OpenAI racconta che Third Moment esegue fino a 10.000 agenti concorrenti in sessioni da 36–48 ore. Il dato operativo più utile è l’architettura: ambienti Docker isolati, un harness esterno che decide retry, stop o escalation e test di breakout prima delle simulazioni.
Limiti da conoscere
Limite: È un caso cliente pubblicato da OpenAI, non un benchmark indipendente. Non sono disponibili costo totale, tasso di errore, log completi, frequenza degli interventi umani o un confronto controllato con altri modelli.
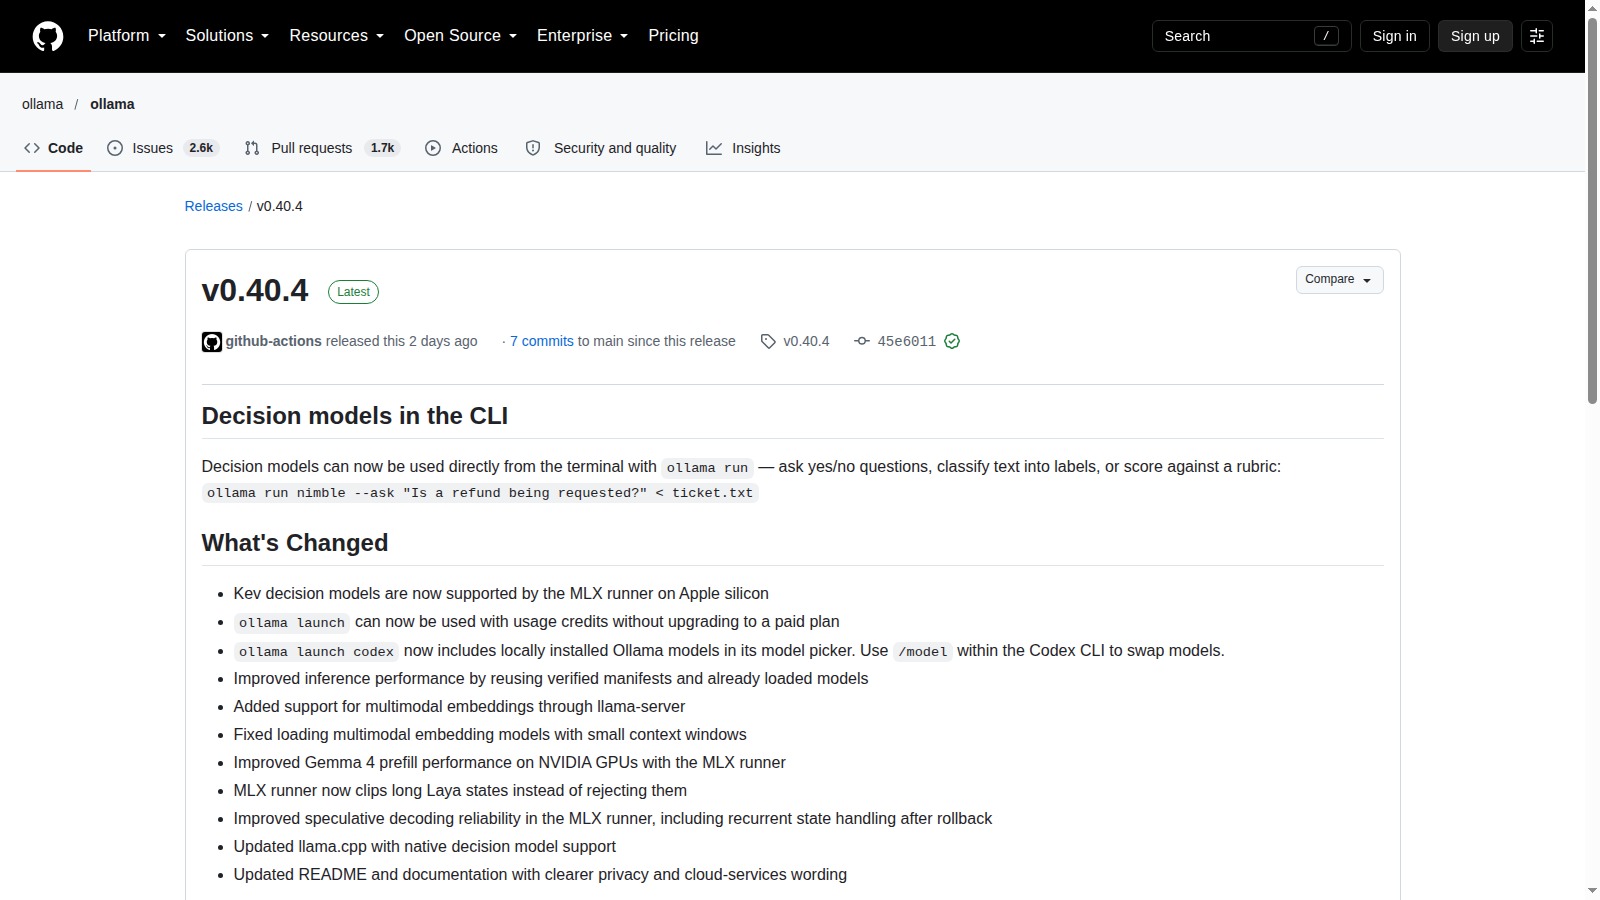
Ollama 0.40.4 è una release stabile che consente di usare i modelli decisionali direttamente con ollama run per classificazioni, risposte sì/no e rubriche. Aggiunge inoltre il supporto MLX ai modelli decisionali Kev su Apple silicon, embedding multimodali tramite llama-server e modelli locali nel selettore di Codex CLI.
Limiti da conoscere
Limite: Le prestazioni e l’affidabilità dipendono dal modello, dall’hardware e dal runner. La release non pubblica benchmark comparativi completi; classificazioni, rubriche ed embedding vanno quindi verificati su dati reali prima di automatizzare decisioni.
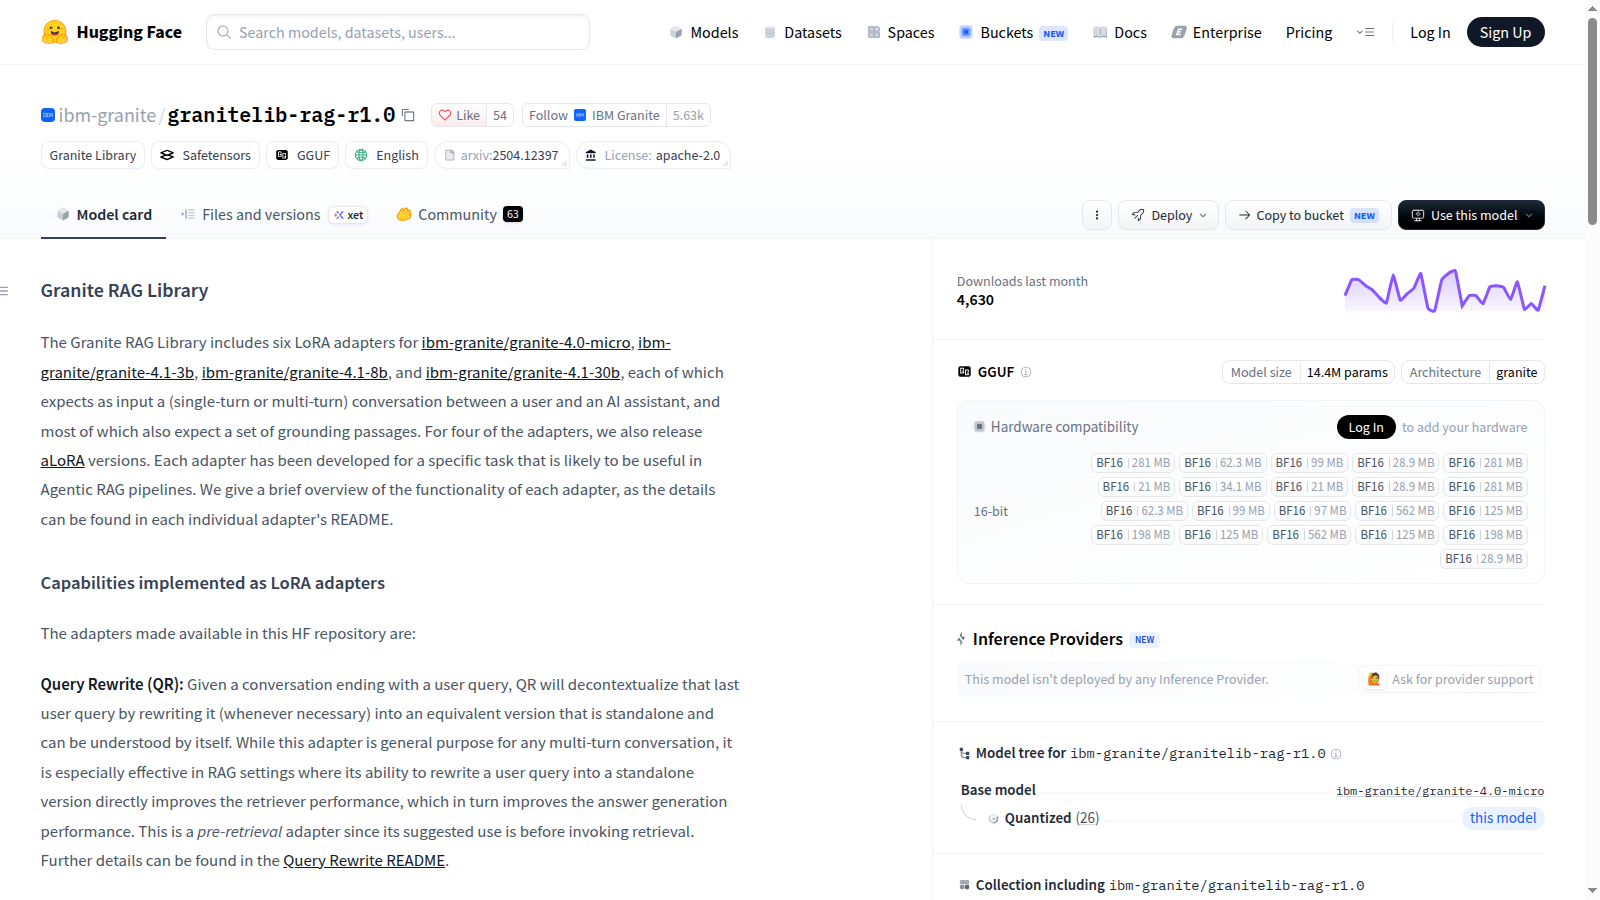
IBM ha aggiornato la Granite RAG Library con sei adapter LoRA per query rewrite, chiarimento, rilevanza del contesto, answerability, rilevamento delle allucinazioni e citazioni. Il repository include varianti per Granite 4.0 Micro e Granite 4.1 da 3B, 8B e 30B, quattro versioni aLoRA, file Safetensors e GGUF, Modelfile e script per Ollama e vLLM.
Limiti da conoscere
Limite: Le accuratezze e i confronti sono misure pubblicate dal team IBM su dataset e prompt propri. La model card avverte che i prompt dei decision model non sono stati ottimizzati per questi compiti; inoltre l’integrazione locale richiede di abbinare correttamente adapter, modello base e runtime.
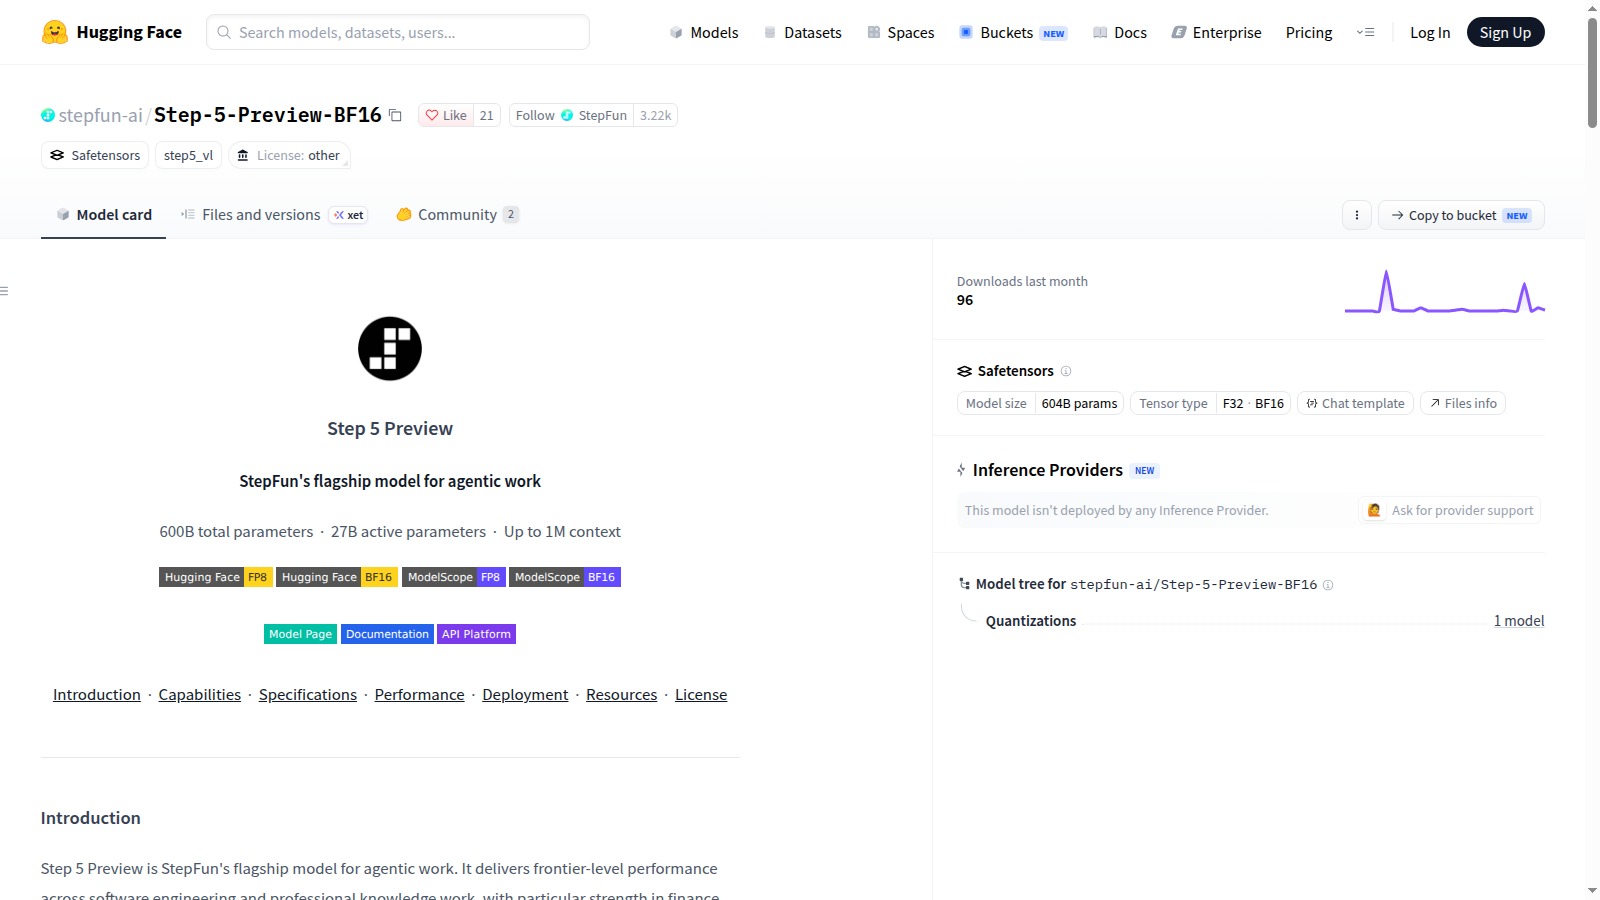
StepFun ha reso pubblico e non gated il repository ufficiale BF16 di Step 5 Preview, il modello MoE da 600B parametri totali e 27B attivi annunciato il 20 settembre. Sono disponibili 24 shard principali, pesi per visione e multi-token prediction, codice di inferenza e istruzioni per vLLM, SGLang e Transformers.
Limiti da conoscere
Limite: Open weight non significa modello leggero né licenza permissiva: la scheda usa una licenza StepFun personalizzata. Il deployment FP8 indicato richiede quattro GPU B300 su un nodo; i benchmark restano dichiarazioni del produttore e non sono stati riprodotti in questo aggiornamento.
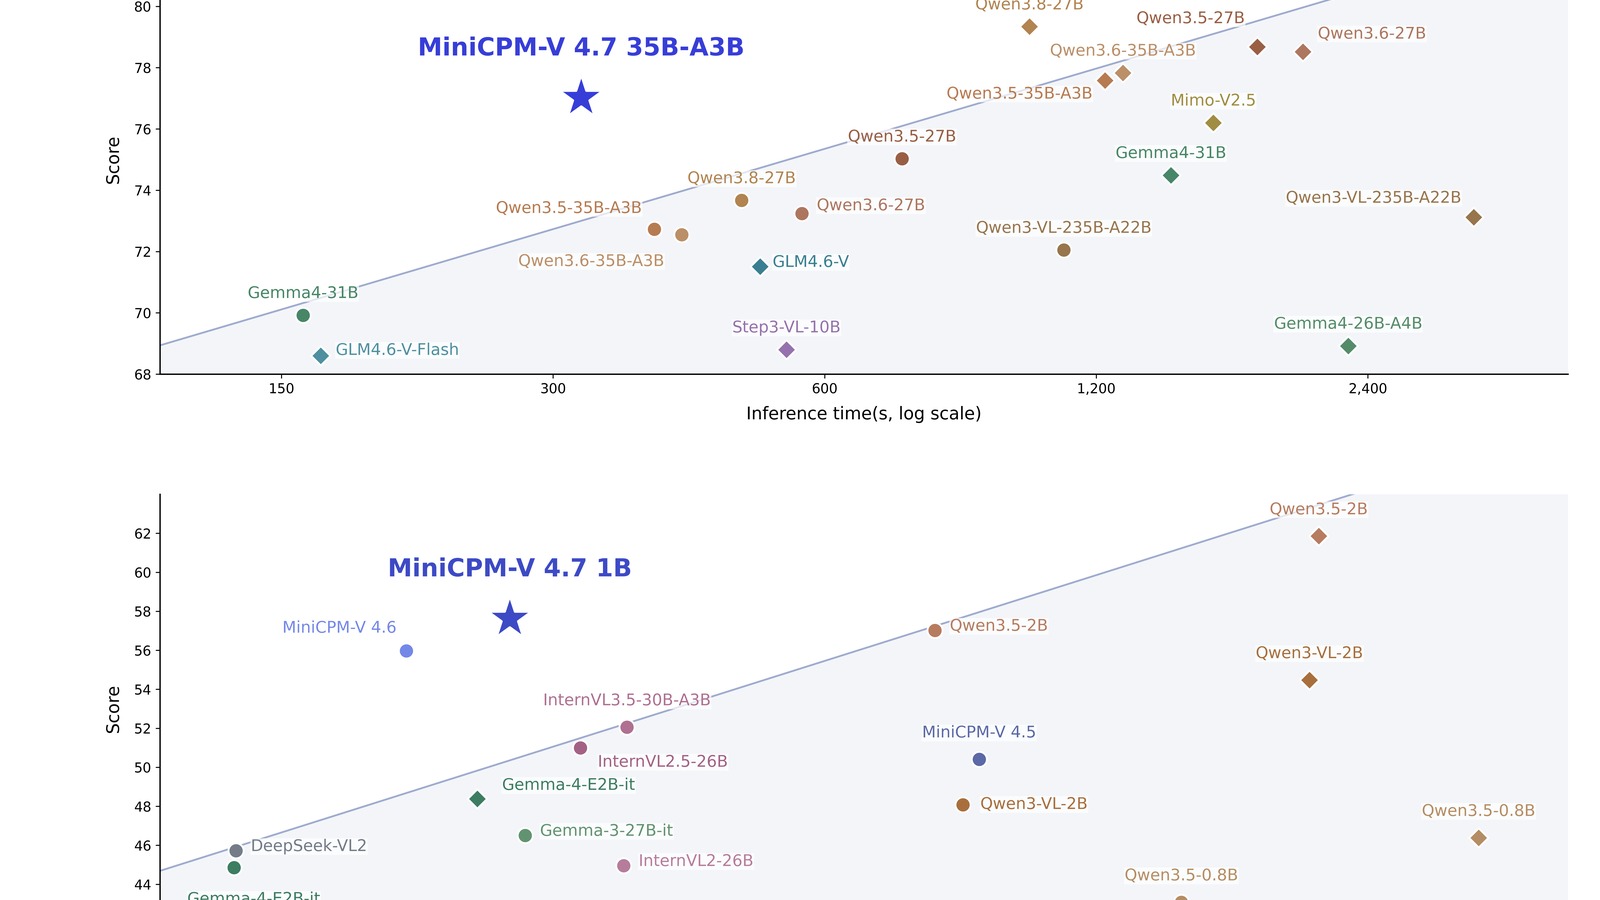
OpenBMB ha pubblicato i draft checkpoint DSpark BF16 per MiniCPM-V 4.7 1B e 35B-A3B, addestrati per l’abbinamento esatto con modello target e tokenizer. Entrambi propongono fino a 15 token speculativi per passaggio e includono ricette vLLM; per il 35B-A3B sono disponibili anche GGUF e comandi llama.cpp.
Limiti da conoscere
Limite: I valori di acceptance length sono misure dichiarate da OpenBMB, non benchmark indipendenti, e non equivalgono direttamente a un aumento di token al secondo. Ogni draft funziona solo con il target MiniCPM-V corrispondente; il percorso llama.cpp richiede una build con architettura dflash e DSpark Markov head.
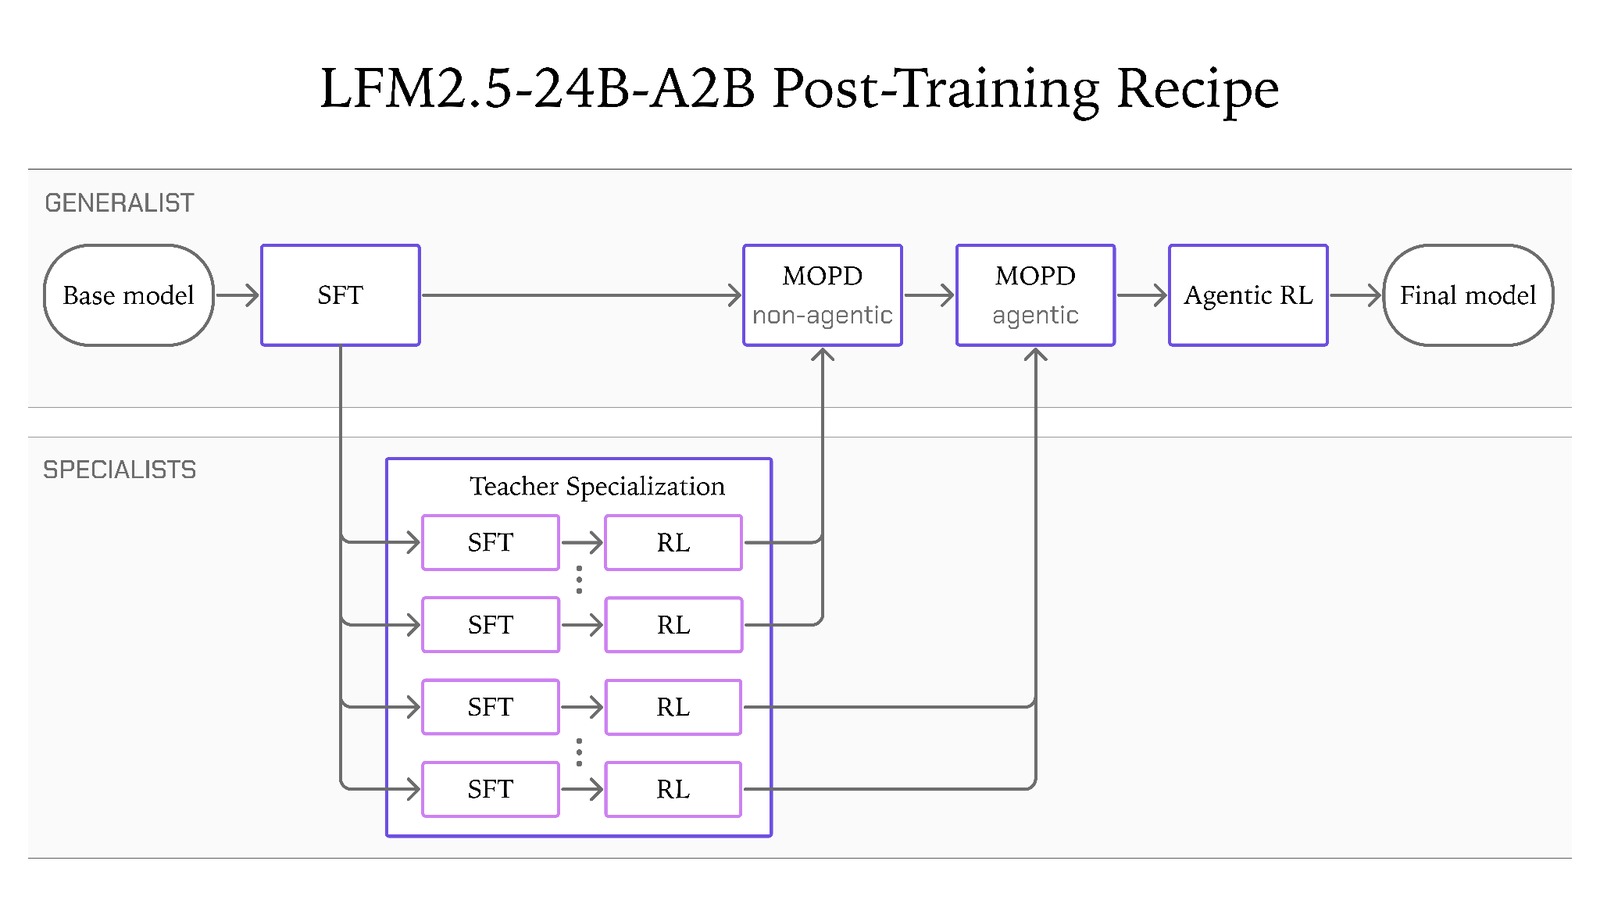
Liquid AI ha rilasciato LFM2.5-24B-A2B, un MoE open-weight da 24 miliardi di parametri totali e 2 miliardi attivi, con contesto fino a 131.072 token. I pesi base e post-trained sono disponibili, insieme a percorsi per llama.cpp, MLX, vLLM, SGLang e ONNX; il training agentico cita anche Hermes Agent, OpenClaw, Pi e OpenCode.
Limiti da conoscere
Limite: Velocità e benchmark sono misure del produttore, non test indipendenti. I 184 token/s su Apple M5 Max e 114 token/s su AMD Ryzen AI Max+ 395 usano quantizzazione Q4_K_M e contesto di input da 4K; sul coding dichiarato il modello resta sotto Qwen3.6-35B-A3B in SWE-Bench Verified. La licenza LFM va verificata per il proprio uso.
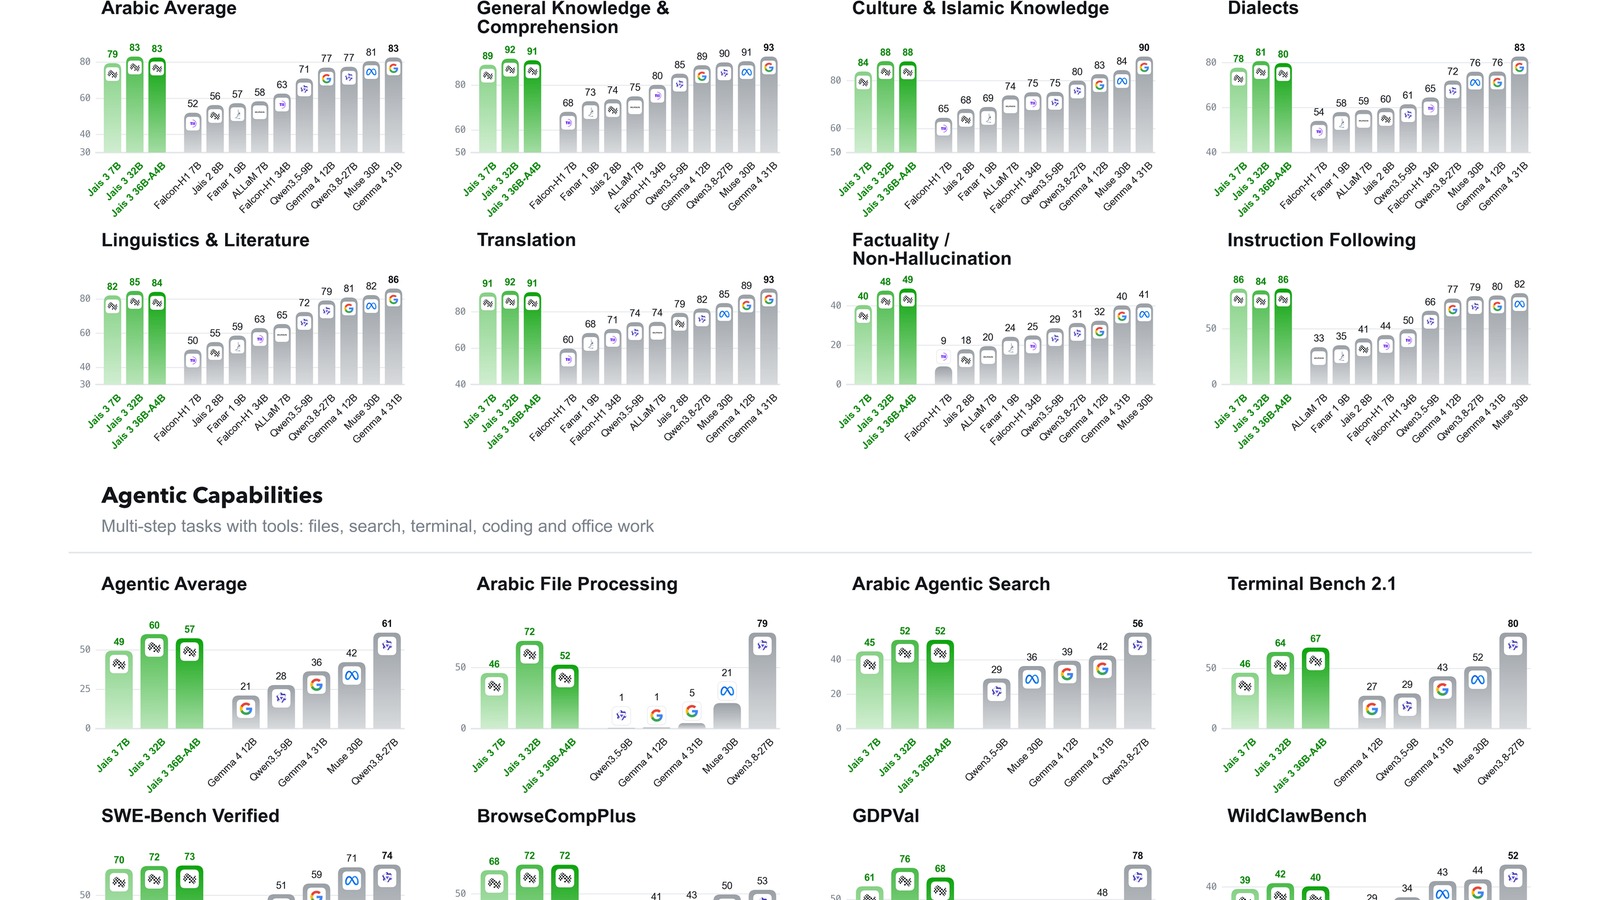
IFM ha pubblicato Jais 3, una famiglia di sei modelli arabo-inglesi open weight da 0,9B a 375B parametri. Sono disponibili pesi, checkpoint, formati GGUF e MLX, ricette per vLLM e SGLang e una finestra fino a 512K token; i modelli sono addestrati anche per tool use, MCP e lavoro su file.
Limiti da conoscere
Limite: Prestazioni e confronti arrivano dal produttore e non sono ancora prove indipendenti. Il modello 375B richiede un nodo multi-GPU, mentre anche le varianti 32B e 36B richiedono hardware importante; 512K indica la finestra dichiarata, non qualità uniforme su tutto il contesto. Il report tecnico e il repository del codice risultano ancora indicati come in arrivo.
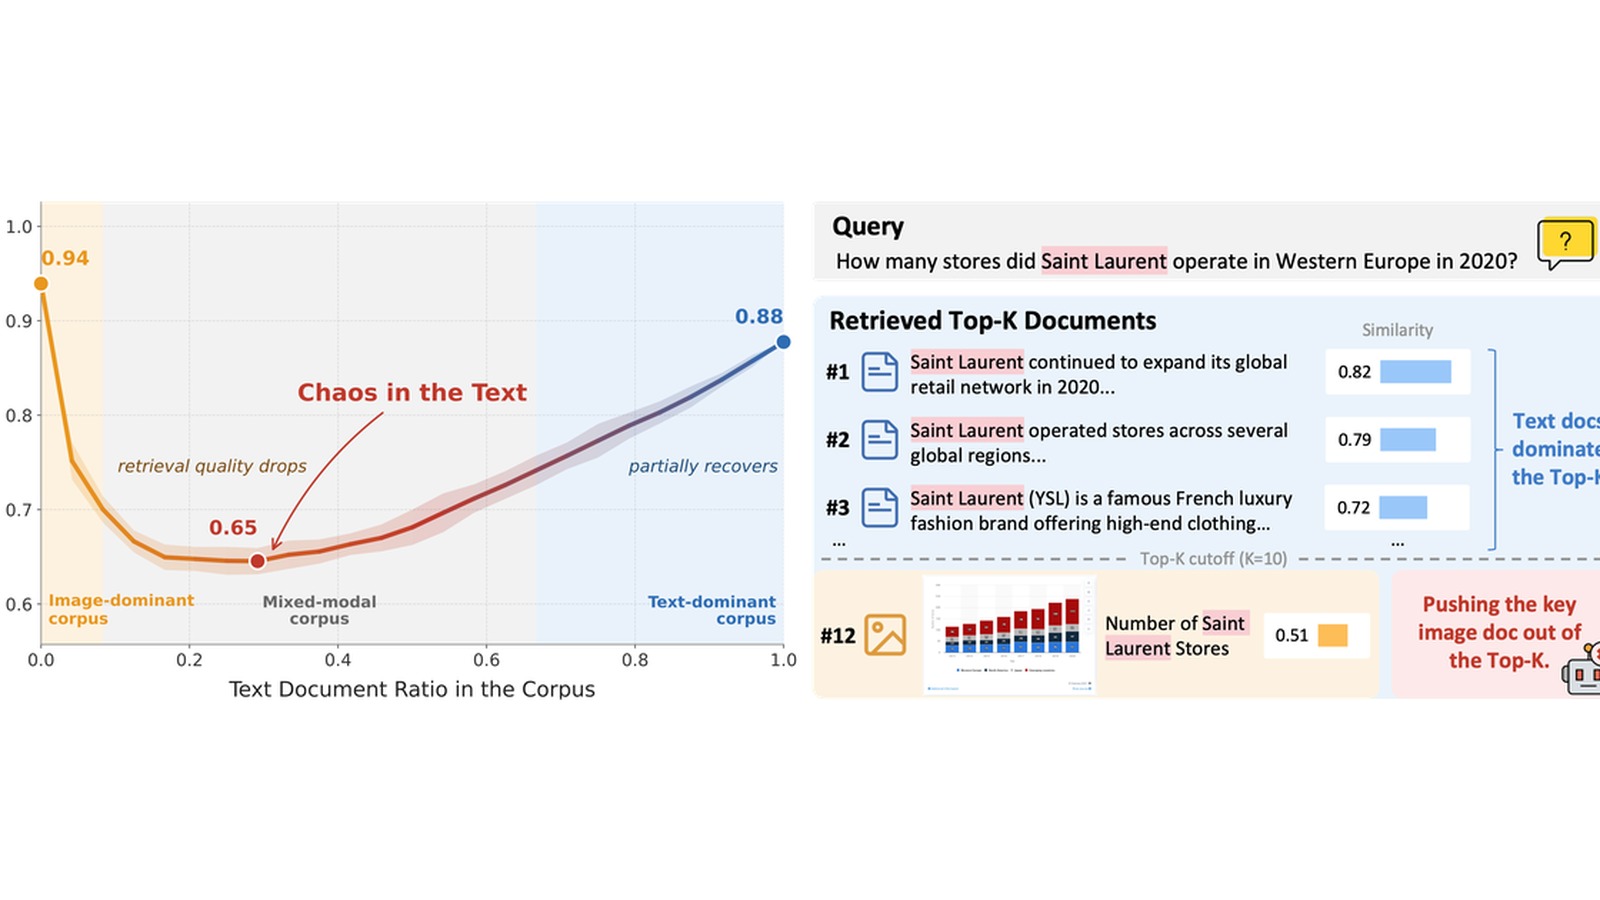
OpenBMB ha pubblicato i pesi BF16 di Trident-Qwen3VL-2B, insieme a codice, dati di training ed evaluation per retrieval su corpus misti. Il modello produce embedding confrontabili per testo, immagini e documenti fusi, con adapter LoRA già integrato e una procedura riproducibile per misurare il divario tra corpus originali e multimodali.
Limiti da conoscere
Limite: I risultati arrivano dagli autori e non sono stati riprodotti in questo aggiornamento. Il quickstart richiede CUDA, il training dichiarato usa otto A100 da 80 GB e immagini, query e annotazioni derivate conservano le licenze dei dataset originali. La scheda non indica un provider di inferenza gestito.
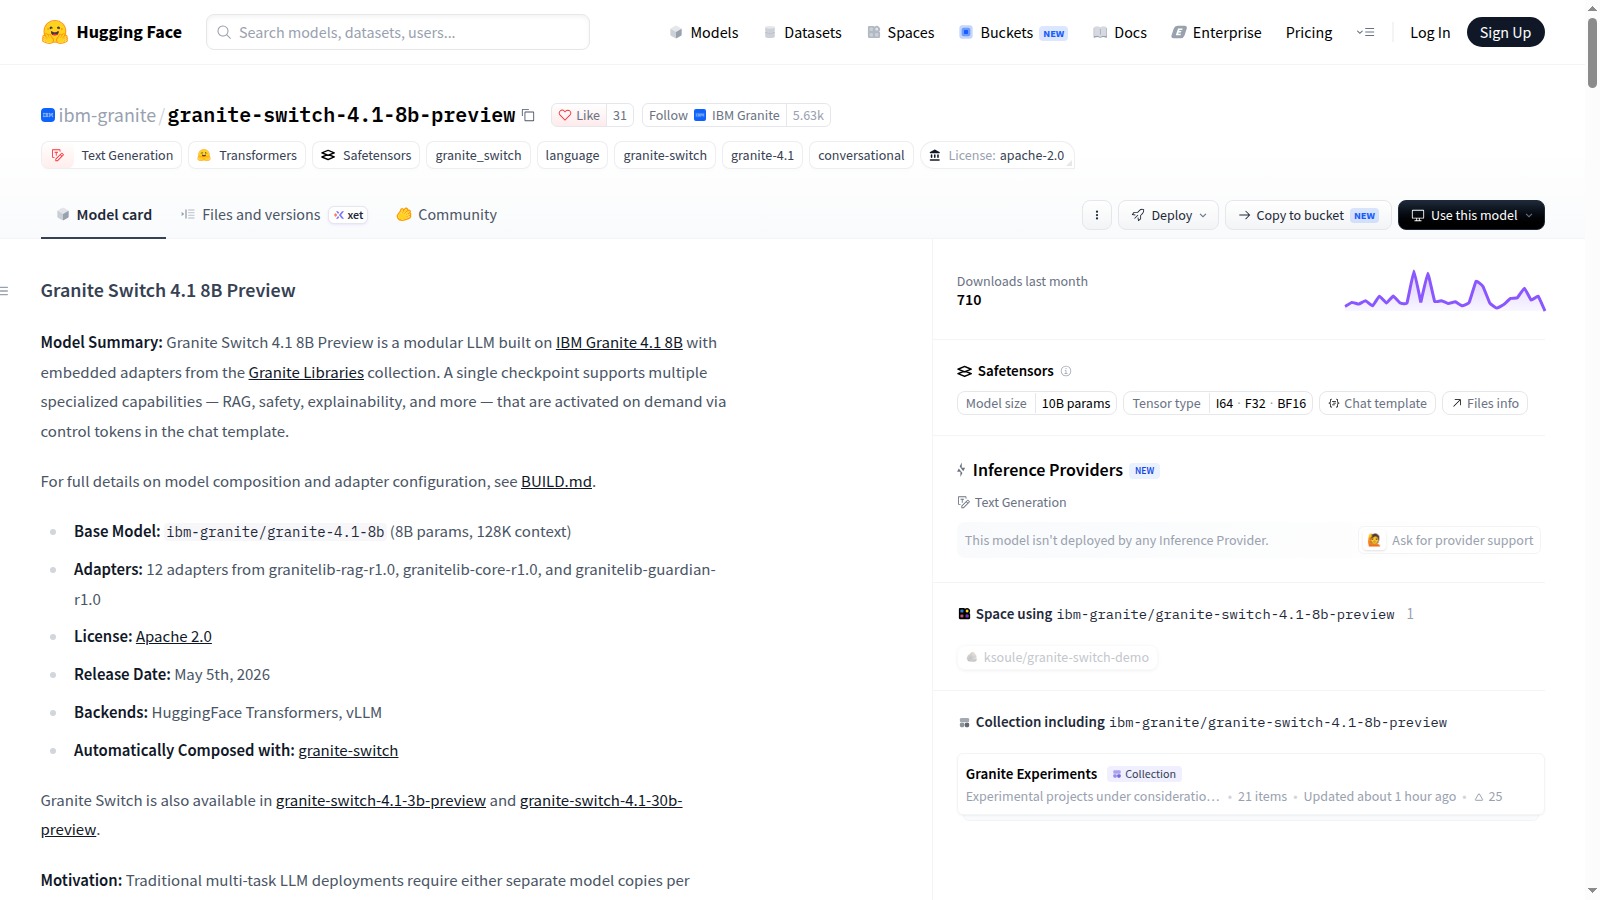
IBM ha aggiornato i pesi di Granite Switch 4.1 8B Preview, un checkpoint Apache 2.0 che incorpora 12 adapter per RAG, sicurezza, factuality, incertezza e controllo dei requisiti. Gli adapter si attivano con token dedicati nello stesso modello e il pacchetto include configurazione, template, indice degli adapter, firma e avvio con Transformers o vLLM.
Limiti da conoscere
Limite: La model card mantiene la data originaria del 5 maggio 2026: la novità del 15 ottobre è la revisione dei pesi e delle tre librerie di adapter, non il primo annuncio del progetto. È ancora una preview, i risultati sono del progetto e ogni adapter va validato sul proprio dominio; il checkpoint composto sale a circa 9,57 miliardi di parametri.
Swiss AI ha pubblicato il rapporto tecnico di Apertus 1.5 e un inventario ampio degli artefatti: dati e ricette, checkpoint intermedi per base, SFT, RLVR e DPO, evaluation card, pesi 8B e 70B Apache 2.0. Il modello accetta testo, immagini e audio, offre thinking opzionale, tool use e contesto fino a 262.144 token.
Limiti da conoscere
Limite: I pesi 8B e 70B erano già disponibili dal 24 luglio: il delta del 15 ottobre è la documentazione tecnica e riproducibile. L’audio è sperimentale, tool calling e thinking non vanno combinati, l’integrazione richiede ancora fork specifici di vLLM e Transformers e i benchmark del progetto non sostituiscono test locali.
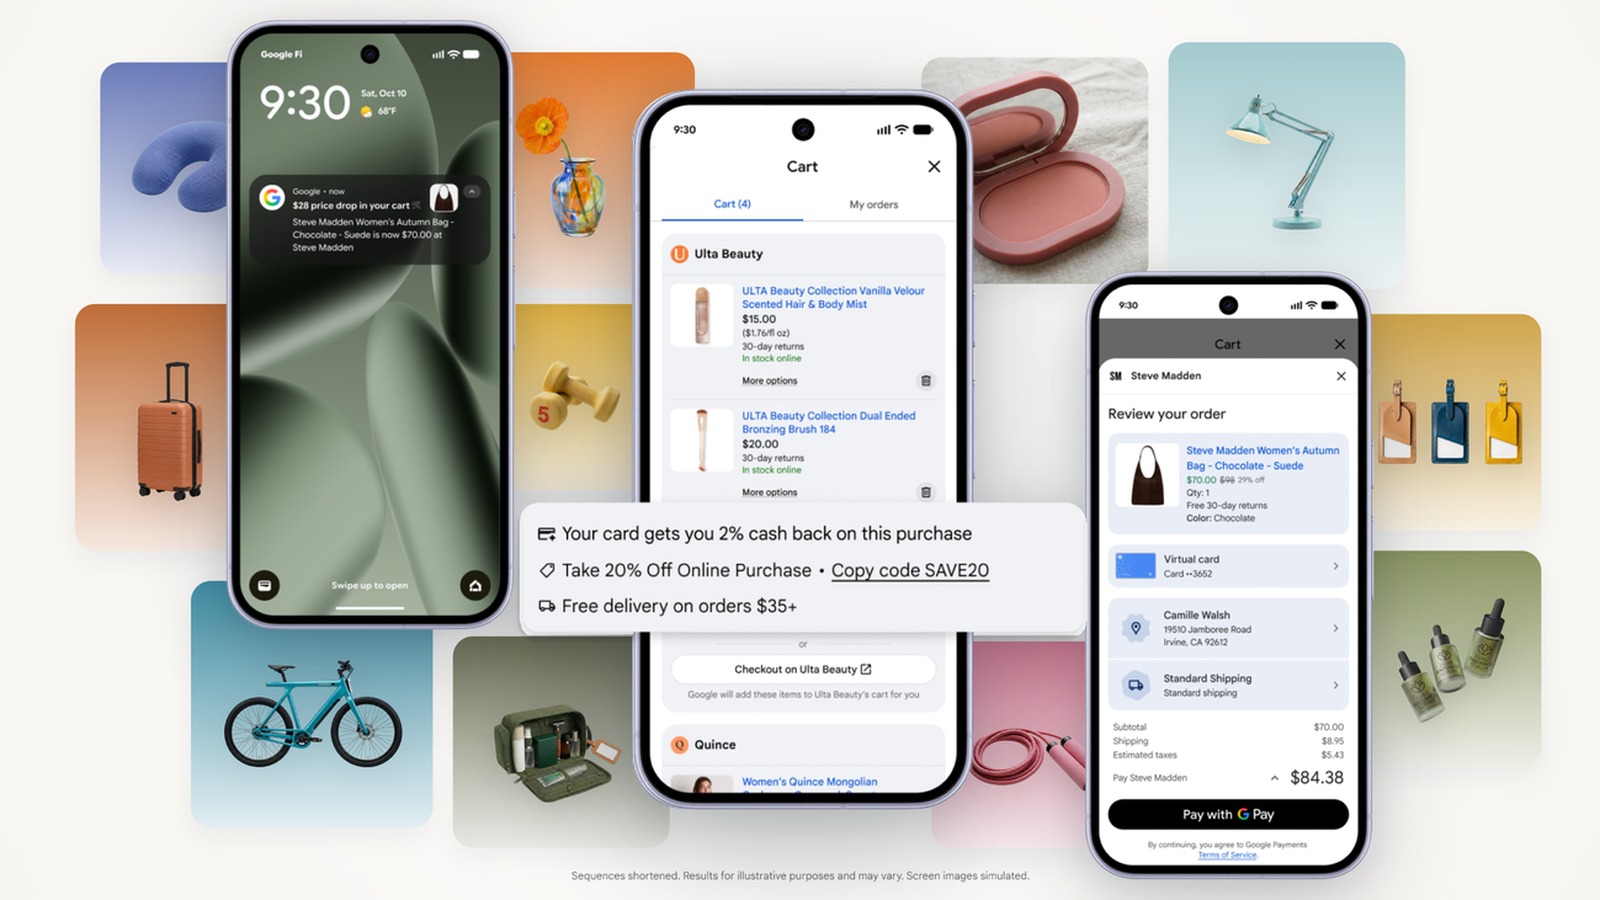
Google ha avviato negli Stati Uniti Universal Cart in Search e nell’app Gemini. Il carrello raccoglie prodotti di più retailer, segnala cali di prezzo e ritorni in stock, propone codici promozionali e vantaggi delle carte in Wallet, poi consente il checkout con Google Pay presso i merchant supportati o il passaggio al sito del venditore.
Limiti da conoscere
Limite: Il rollout è limitato agli Stati Uniti e non è stato provato dall’Italia. Google distingue questa funzione dagli agenti che agiscono per conto dell’utente: il controllo resta alla persona e il merchant resta seller of record. Disponibilità, promo e checkout dipendono dai retailer partecipanti.
Mistral ha pubblicato Timestral in quattro taglie da 5M, 28M, 123M e 209M parametri. I modelli producono previsioni probabilistiche multivariate, accettano covariate storiche e future note, lavorano fino a 32.768 passi e possono essere eseguiti localmente su CPU o GPU tramite il repository ufficiale.
Limiti da conoscere
Limite: I primati su GIFT-Eval, TIME e fev-bench sono dichiarazioni del produttore e non sono stati riprodotti su dati aziendali o hardware locale. Il rapporto tecnico completo deve ancora arrivare; codice e pesi hanno licenze distinte e il valore reale dipende da backtest senza leakage contro baseline semplici.
Black Forest Labs ha pubblicato FLUX.3 Image Klein, un modello open weight da 5,6B per text-to-image, editing e composizione fino a dieci riferimenti. I prompt possono includere bounding box su una griglia 0-1000; sono disponibili checkpoint distilled e base, BF16, FP8 e NVFP4, supporto Diffusers e script LoRA.
Limiti da conoscere
Limite: Le bounding box guidano posizione e scala ma non sono maschere rigide. I 5,6B non includono il text encoder separato; la model card misura 25-31 GB di picco su B200 senza prompt upsampler, che aggiunge circa 28 GB. La FLUX Kommunity License non è una licenza permissiva e il modello non è stato provato sul nostro hardware.
Skywork AI ha pubblicato Matrix-Game 4.0 con codice di inferenza, demo browser, tre giochi e checkpoint BF16 per castello medievale, antico Egitto e guida urbana. Il motore conserva fisica, input e regole, mentre un modello video causale trasforma in streaming i frame low-poly in immagini dettagliate.
Limiti da conoscere
Limite: I tre checkpoint sono specializzati per scene e profili di camera specifici, circa 10 GB ciascuno, e non sono pipeline Diffusers intercambiabili. Il percorso documentato richiede Linux, GPU NVIDIA e dipendenze CUDA; la cadenza di acquisizione non garantisce throughput o latenza. Training code e dati di addestramento non sono inclusi.
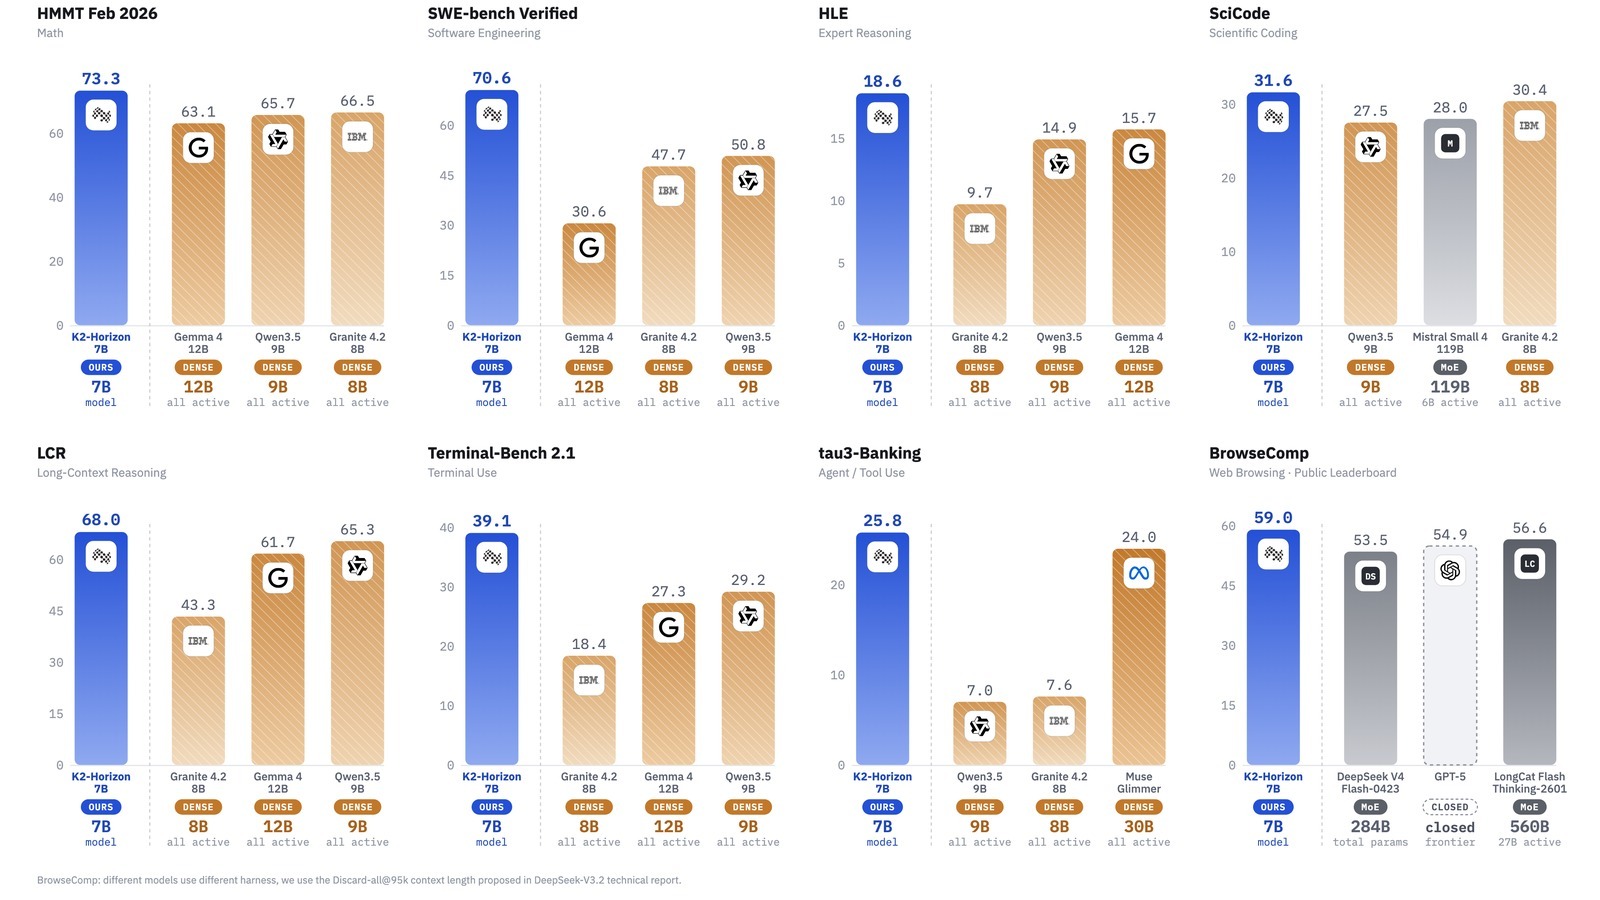
IFM ha pubblicato file GGUF per K2-Horizon 0,9B, 3,7B, 7B e MoVA 36B-A4B, nelle varianti BF16, Q8_0, Q6_K, Q5_K_M, Q5_0 e Q4_K_M. I file includono metadati del tokenizer e chat template, ma il supporto dell’architettura K2 Horizon non è ancora nel ramo principale di llama.cpp: per ora serve il fork MBZUAI-IFM.
Limiti da conoscere
Limite: La disponibilità dei GGUF non equivale ancora a compatibilità immediata con una build standard di llama.cpp. I benchmark e i confronti di qualità delle quantizzazioni sono dichiarati dal progetto; non ho riprodotto inferenza, memoria, velocità o tenuta del contesto lungo su hardware locale.
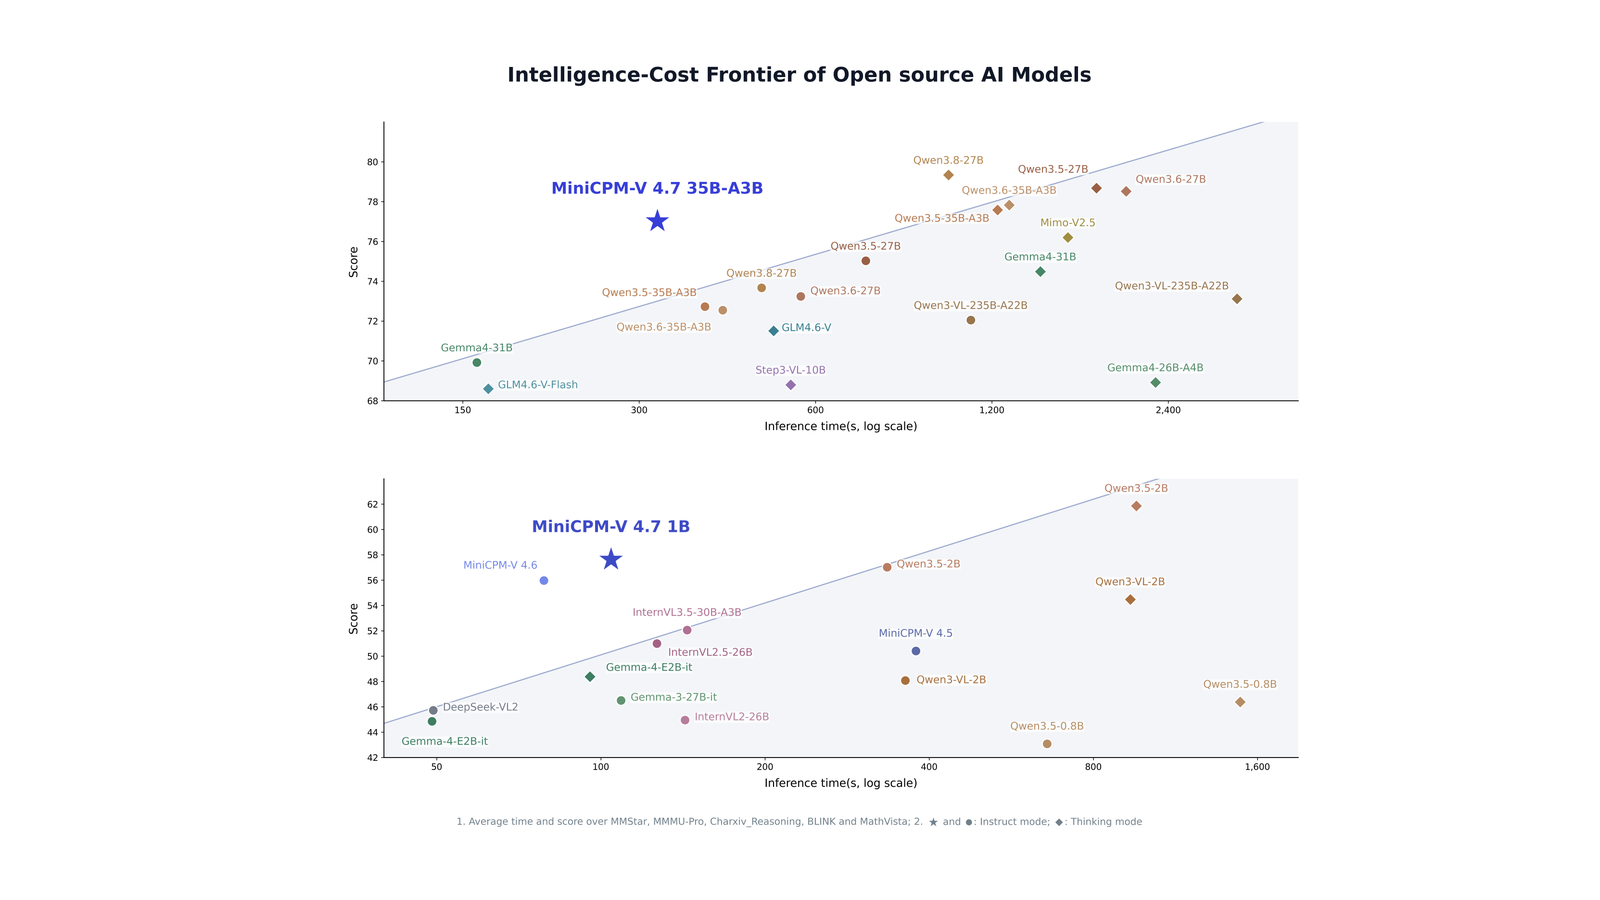
OpenBMB ha pubblicato i repository GGUF ufficiali di MiniCPM-V 4.7 nelle varianti 1B e MoE 35B-A3B. Sono disponibili profili da F16 a IQ4_XS, i proiettori visivi mmproj e file DSpark; le model card documentano l’uso diretto con llama.cpp e indicano anche Ollama per entrambe le taglie.
Limiti da conoscere
Limite: La pubblicazione dei file non equivale a una prova indipendente su ogni dispositivo. Il 35B-A3B richiede spazio e banda rilevanti nonostante attivi circa 3B parametri per token; i 13+ token/s su iPhone 17 Pro Max e i confronti di qualità restano misure dichiarate dal progetto.
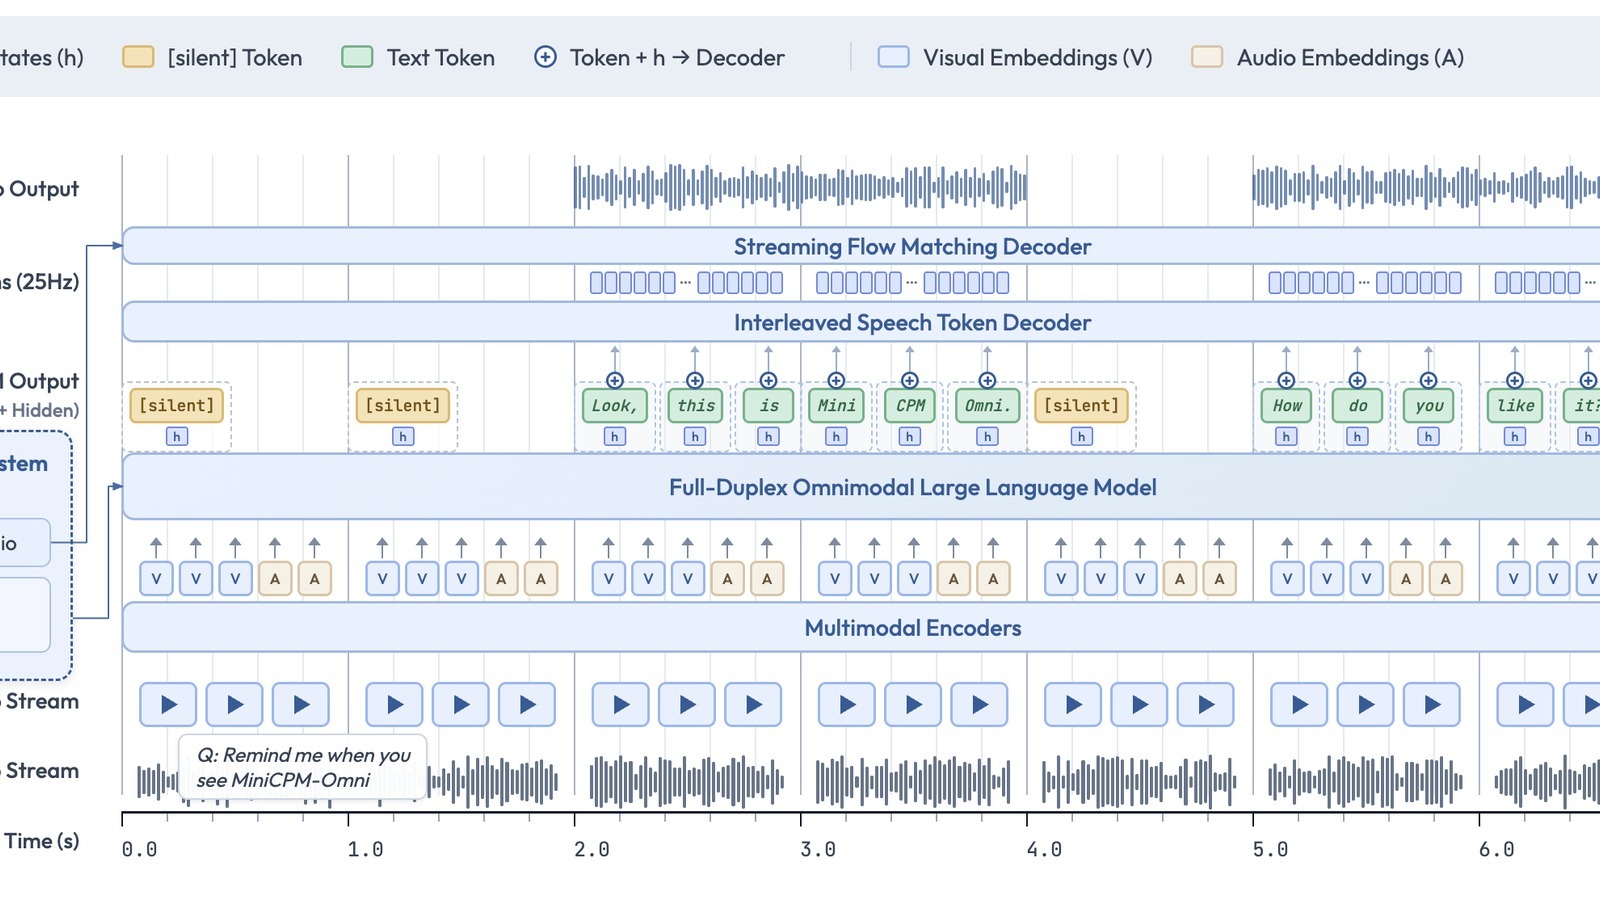
OpenBMB ha caricato su Hugging Face i pesi completi di MiniCPM-o 4.5, un modello omnimodale end-to-end da 9B parametri basato su Qwen3-8B, SigLip2, Whisper-medium e CosyVoice2. Il pacchetto permette inferenza locale su immagini, video, audio e voce, inclusa una modalità full-duplex che riceve flussi audio-video mentre genera testo e parlato.
Limiti da conoscere
Limite: Il modello richiede codice remoto personalizzato e, per il percorso Transformers documentato, transformers 4.51.0, PyTorch 2.3-2.8, FFmpeg e una GPU NVIDIA. Velocità, memoria e benchmark sono dichiarati dal progetto e non sono stati riprodotti in questo run. Voice cloning e interazione proattiva richiedono inoltre controlli espliciti su consenso, identità e uso dei campioni vocali.
Nous Research ha presentato Hermes Business, una versione organizzativa dello stack Hermes che condivide automaticamente le skill scoperte dai team, rende visibili costi e ritorno dei modelli e conserva skill, memoria e workflow come capacità aziendale. Per Enterprise sono dichiarati deployment on-prem o private cloud, SSO, SLA e onboarding dedicato.
Limiti da conoscere
Limite: La pagina pubblica non espone prezzi, tempi di disponibilità, matrice dei provider, dettagli tecnici su isolamento e sincronizzazione, né documentazione verificabile per SSO, audit e amministrazione. Le cifre di adozione e consumo token riportate nel post sul finanziamento sono stime interne di Nous e non sono state validate indipendentemente.
Reflection ha pubblicato i pesi instruction-tuned di Beam in BF16, FP8 e NVFP4 con licenza Apache 2.0. Il modello MoE conta 501,3 miliardi di parametri totali, 23,4 miliardi attivi per token e una finestra di contesto dichiarata da un milione di token. Il lancio include supporto per Transformers, vLLM, SGLang e diversi provider, oltre a percorsi self-hosted e on-prem.
Limiti da conoscere
Limite: I benchmark, l’efficienza e i risultati di sicurezza sono dichiarazioni del produttore e non equivalgono a una prova indipendente end-to-end. La dimensione complessiva resta impegnativa anche con 23,4B parametri attivi; nel controllo anonimo il repository dei pesi su Hugging Face ha restituito HTTP 401, quindi accesso e condizioni effettive vanno verificati con un account prima di pianificare il deployment.
La build b11700 di llama.cpp aggiunge conversione e serving per Granite Switch 4.1 8B come modello sia conversazionale sia decisionale. Il server espone chat tramite `/v1/chat/completions` e decisioni strutturate tramite `/v1/systemone`; la modifica è stata provata dal contributore in BF16 e Q4_K_M ed è distribuita nei binari della release per Linux, Windows, macOS, Android e iOS.
Limiti da conoscere
Limite: Il test pubblicato nel pull request è del contributore e non una verifica indipendente. Il supporto riguarda il checkpoint Granite Switch 4.1 8B con adapter `decision`; accuratezza, calibrazione delle probabilità, memoria e velocità vanno misurate sui propri casi. La componente speech documentata dal modello non è il delta verificato di questa build llama.cpp.
La prerelease b11701 di llama.cpp aggiunge il supporto a Beam 1.0 501B-A23B: conversione in GGUF, grafo Mixture-of-Experts, chat template e parser delle tool call Harmony XML. Il contributore dichiara conversione del checkpoint reale, caricamento di GGUF quantizzati su CUDA e sessioni multi-turno con chiamate parallele agli strumenti; Unsloth pubblica varianti GGUF da BF16 fino a quantizzazioni IQ e Q-K.
Limiti da conoscere
Limite: b11701 è una prerelease e Beam resta un modello da 501B parametri totali, quindi il supporto software non lo rende automaticamente pratico su una singola workstation. Le prove sul checkpoint reale sono dichiarate nel pull request del contributore, non riprodotte in questo run; qualità, memoria, throughput e affidabilità delle tool call vanno misurati sul proprio hardware.
La prerelease b11706 corregge una regressione del backend SYCL che rallentava tutti i prompt successivi al primo decode nei modelli Q4_0 e Q8_0. Nei test del contributore su Intel Arc Pro B50, il prompt processing Q4_0 passa da 607 a 1005 token al secondo dopo il riordino dei pesi, mentre Q8_0 passa da 3117 a 4161; la generazione resta invariata e i controlli di correttezza producono risultati identici.
Limiti da conoscere
Limite: Le misure provengono dal contributore e coprono Intel Arc Pro B50 e UHD 730 con specifici modelli Qwen3.5, non ogni GPU SYCL o quantizzazione. b11706 è una prerelease: prima di aggiornare un servizio stabile vanno ripetuti benchmark, test multi-turno e controlli di output sul proprio hardware.
Il commit 7b6310c1 modifica la pipeline split top-p di vLLM per mantenere più parallelismo nei batch fino a 64 righe e saltare il percorso split quando tutte le righe usano top-k. Nei benchmark pubblicati dal contributore, i batch misti da almeno 32 righe e vocabolari da almeno 120K accelerano da 1,43 a 2,70 volte; sul caso MiMo-V2.6 con 38 righe il solo top-p scende da 561 a 219 microsecondi.
Limiti da conoscere
Limite: Il cambiamento è appena confluito nel ramo main e non appartiene ancora a una release stabile. Le misure provengono dal contributore su NVIDIA B300 e H200, con configurazioni specifiche di vocabolario, batch e sampling: il guadagno end-to-end pubblicato è più contenuto del microbenchmark e va misurato sul proprio modello.
Nel rapporto pubblicato il 16 ottobre, Anthropic presenta il primo quadro interno dettagliato dell’impatto degli agenti sul proprio lavoro: ad agosto le ore degli agenti interattivi risultavano sei volte quelle dei dipendenti, mentre la quota di junior tra le nuove assunzioni tecniche è scesa dal 27% al 9%. Il rapporto propone segnali misurabili su output, supervisione, attese per input umano e composizione dei ruoli, senza equiparare più codice a maggiore valore.
Limiti da conoscere
Limite: È un caso aziendale estremo, auto-riferito e prodotto dalla stessa organizzazione che sviluppa Claude. Le ore agentiche misurano runtime, inferenza e uso attivo degli strumenti, non ore umane equivalenti; l’aumento di codice non dimostra da solo migliore qualità o impatto e i risultati non sono generalizzabili automaticamente ad altre aziende.
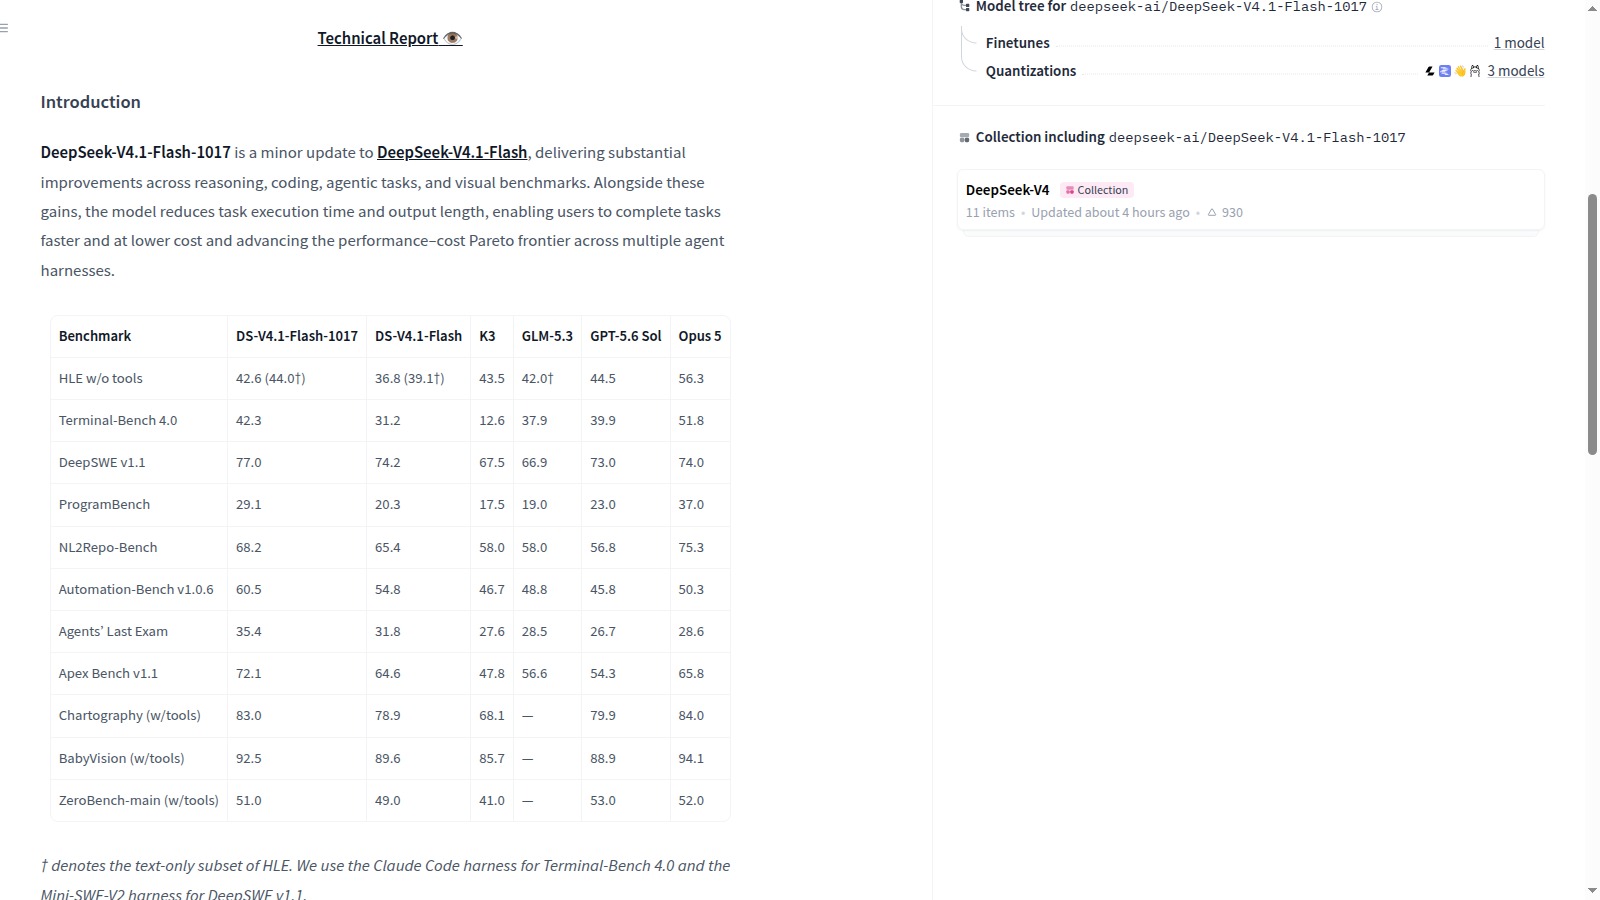
Il 17 ottobre DeepSeek ha aggiornato web, app e API a DeepSeek-V4.1-Flash-1017, mantenendo l’alias API deepseek-flash e il prezzo del modello. I pesi sono disponibili con licenza MIT e contesto raccomandato fino a un milione di token. Nello stesso rilascio, Search restituisce fino a 50 risultati web strutturati e Fetch recupera una pagina in Markdown, ciascuna API a 0,75 dollari ogni 1.000 richieste riuscite.
Limiti da conoscere
Limite: I miglioramenti di reasoning, coding, attività agentiche, velocità e lunghezza dell’output sono benchmark e misure dichiarati da DeepSeek, non una prova indipendente sul workflow reale. Il checkpoint completo è molto grande, il supporto nei runtime e nelle quantizzazioni locali va verificato e Search/Fetch non garantiscono da sole qualità, copertura o attendibilità delle fonti restituite.
La build b11709 del 17 ottobre aggiunge a llama.cpp il supporto nativo per Kolibri-1 e pubblica binari per CPU, CUDA, ROCm, Vulkan, OpenVINO, SYCL, Snapdragon e altre piattaforme. Il contributo documenta la conversione del checkpoint in un GGUF BF16 da 156 GiB e in un Q4_K_M da 45 GiB, trasformando il modello già rilasciato in un candidato concretamente testabile nell’ecosistema GGUF.
Limiti da conoscere
Limite: Il test riportato dal contributore usa quattro A800 e non dimostra caricamento, velocità o qualità sull’hardware di Francesco. Il Q4_K_M da 45 GiB resta grande, una quantizzazione non elimina il costo dei pesi residenti e i benchmark del model card non sono stati riprodotti in questo run.
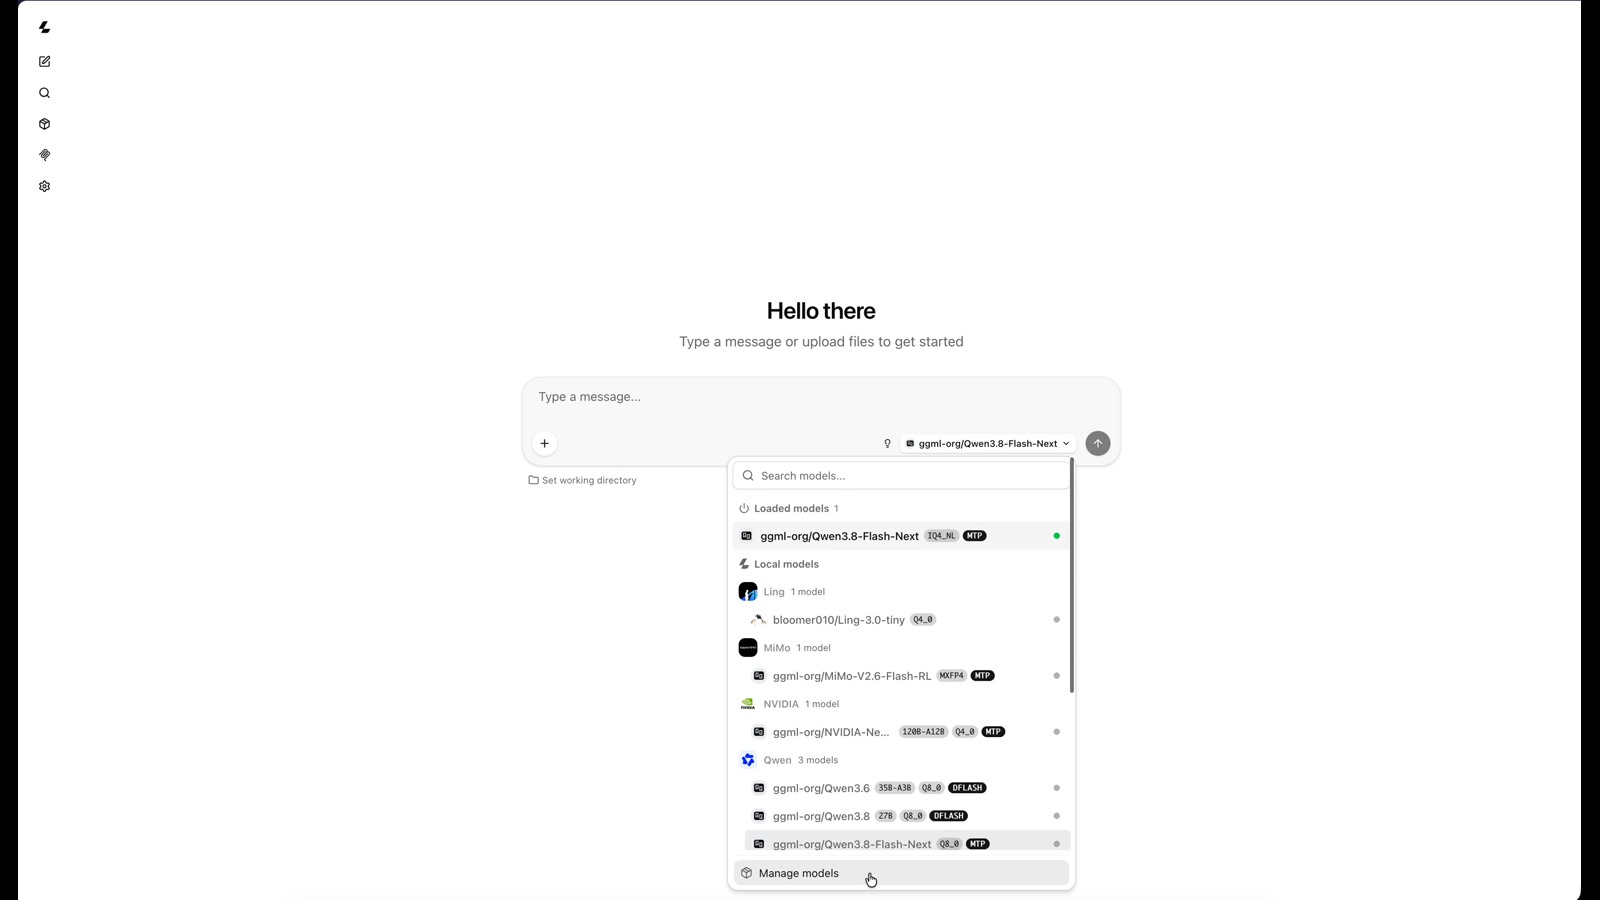
La build b11714 aggiunge alla UI di llama.cpp una vista opzionale per cercare modelli GGUF su Hugging Face, filtrare per dimensione e scegliere la quantizzazione con indicazioni di memoria. Il download può includere il draft sidecar compatibile, conserva i file parziali per la ripresa e ricorda le operazioni incompiute dopo un riavvio.
Limiti da conoscere
Limite: Discover Models è disattivato per impostazione predefinita e richiede accesso a Hugging Face. La UI semplifica acquisizione e ripresa dei file, ma non verifica qualità, licenza, provenienza o compatibilità hardware di ogni repository; dimensioni e note di memoria restano stime da controllare prima dell’esecuzione.
La patch stabile 1.103.5 corregge due regressioni nel percorso che converte risposte della Responses API nel formato Chat Completions. Testo, reasoning, citazioni e chiamate agli strumenti vengono ricomposti in `choices[0]`; quando il modello invoca più strumenti, gli indici tornano distinti invece di essere tutti zero.
Limiti da conoscere
Limite: La correzione riguarda il bridge non-streaming e soprattutto i client che leggono solo `choices[0]` o associano i risultati tramite l’indice della tool call. Il pull request di backport dichiara test unitari completati, ma segnala che la prova live contro un proxy stabile e un deployment reale non era ancora stata eseguita; prima dell’upgrade servono quindi test di compatibilità sul proprio harness.
OpenCode ha dichiarato una violazione di sicurezza collegata a un attacco di distillazione su larga scala, con impatto indicato sull’1,4% degli utenti Console. Gli utenti coinvolti sono stati avvisati via email; mentre l’incidente resta aperto, chi ha ricevuto la notifica deve trattare le credenziali collegate al workspace come potenzialmente esposte e ruotarle dai provider originari.
Limiti da conoscere
Limite: La comunicazione pubblica non specifica ancora quali dati o credenziali siano stati consultati, quale attore abbia condotto l’attacco, la finestra completa né le misure definitive di contenimento. Il valore 1,4% riguarda gli utenti OpenCode Console, non tutti gli utenti del client open source; la rotazione è una precauzione operativa, non la prova che ogni chiave collegata sia stata sottratta.
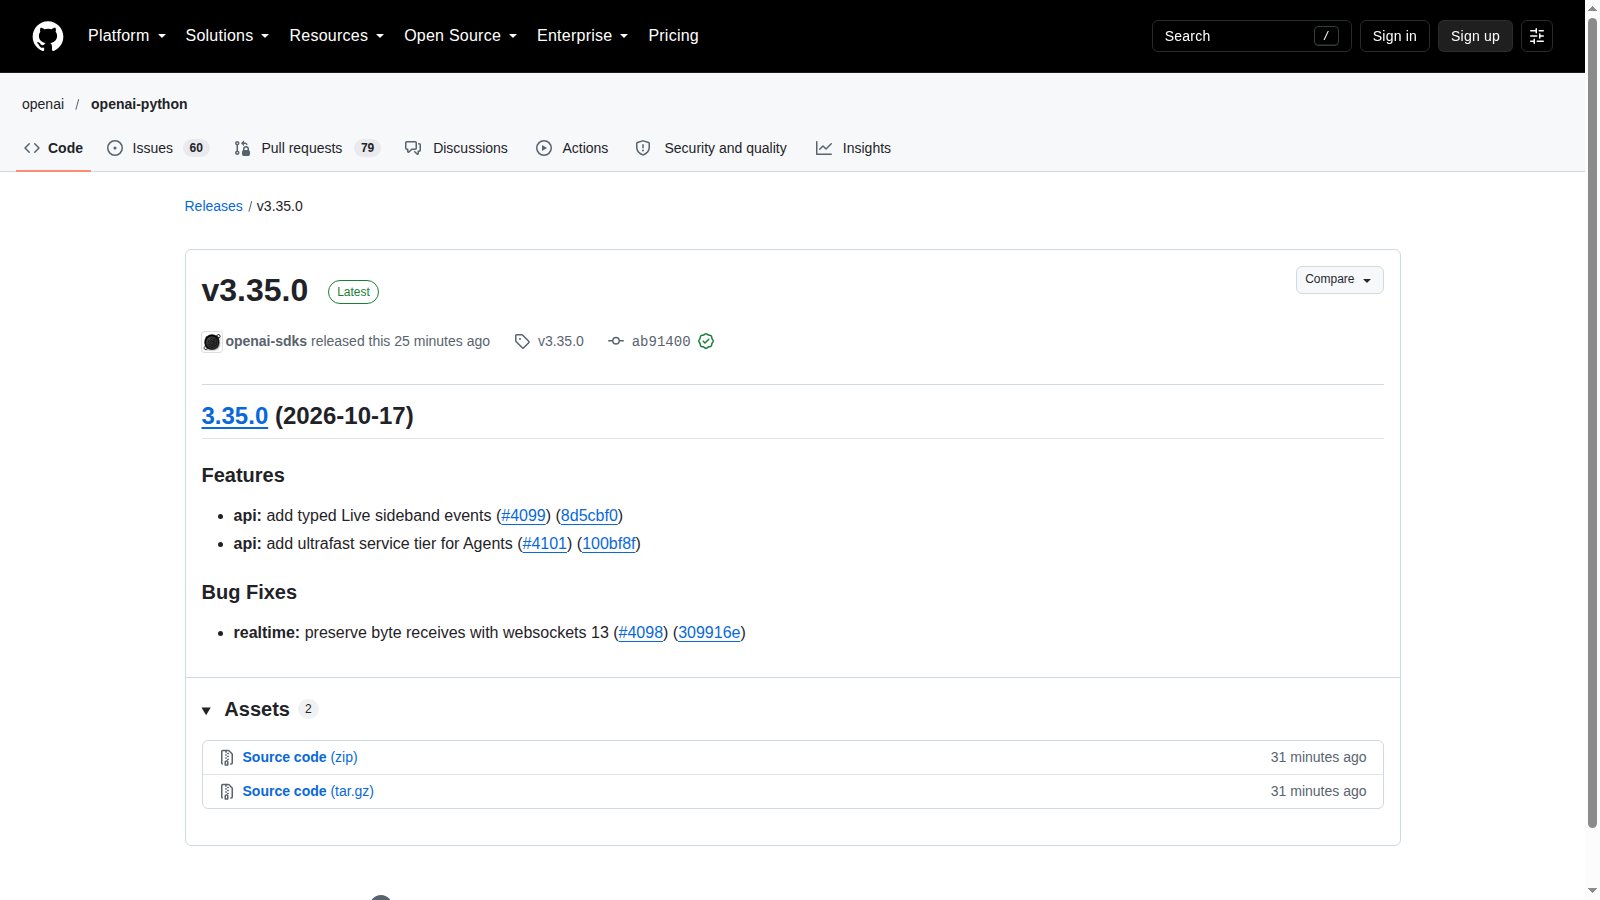
La release stabile 3.35.0 del client Python OpenAI aggiunge `ultrafast` alle opzioni tipizzate delle impostazioni modello per creazione, aggiornamento e sessioni degli Agents. Aggiunge inoltre sette varianti tipizzate per gli eventi Live sideband, tra audio riflesso e stati di trasporto, e corregge la ricezione dei byte con websockets 13.
Limiti da conoscere
Limite: Il rilascio aggiorna tipi e compatibilità del client, non garantisce che il tier ultrafast sia disponibile per ogni account, modello o regione. Il pull request sugli eventi sideband dichiara test sincroni e asincroni su sorgente e wheel, ma segnala che i test sul servizio ospitato restavano sospesi; questo run non ha eseguito una sessione Agents o Live reale.
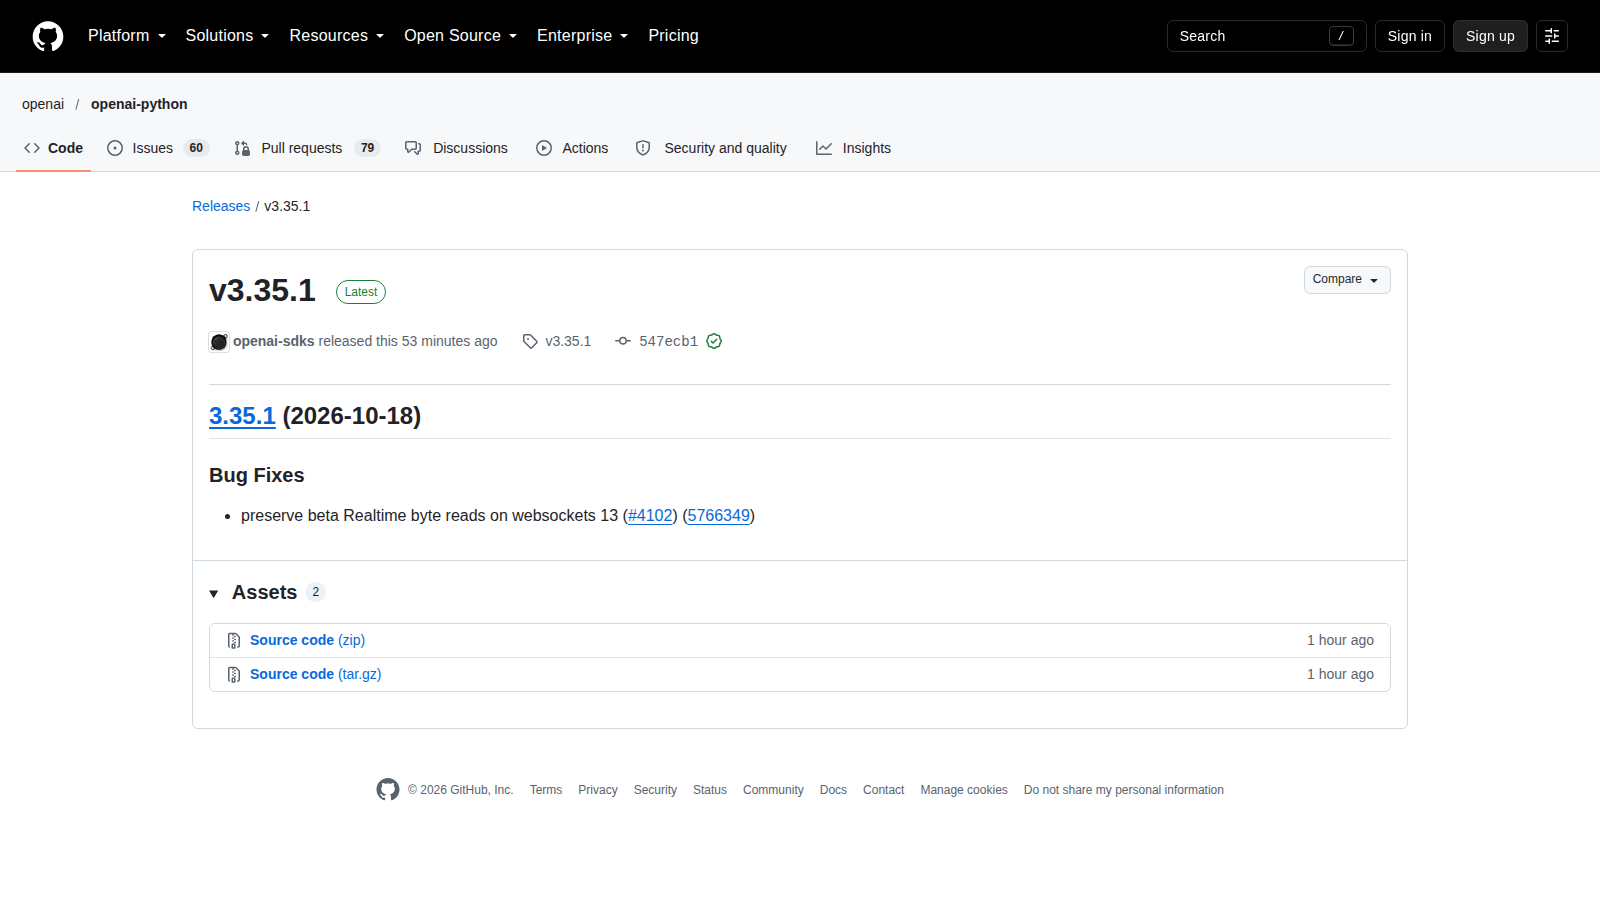
La release stabile 3.35.1 corregge una regressione rimasta nel percorso sincrono `client.beta.realtime`: con websockets 13.x la chiamata `recv(decode=False)` poteva sollevare `TypeError` perché quella firma non accetta `decode`. Il client usa ora lo stesso helper di ricezione byte già adottato dagli altri percorsi Realtime.
Limiti da conoscere
Limite: Il fix riguarda il client Python sincrono beta Realtime con websockets 13.x. Le prove dichiarate usano server locali e credenziali sintetiche, non il servizio ospitato; questo run non ha eseguito una sessione Realtime reale né verificato applicazioni che dipendono da wrapper propri.
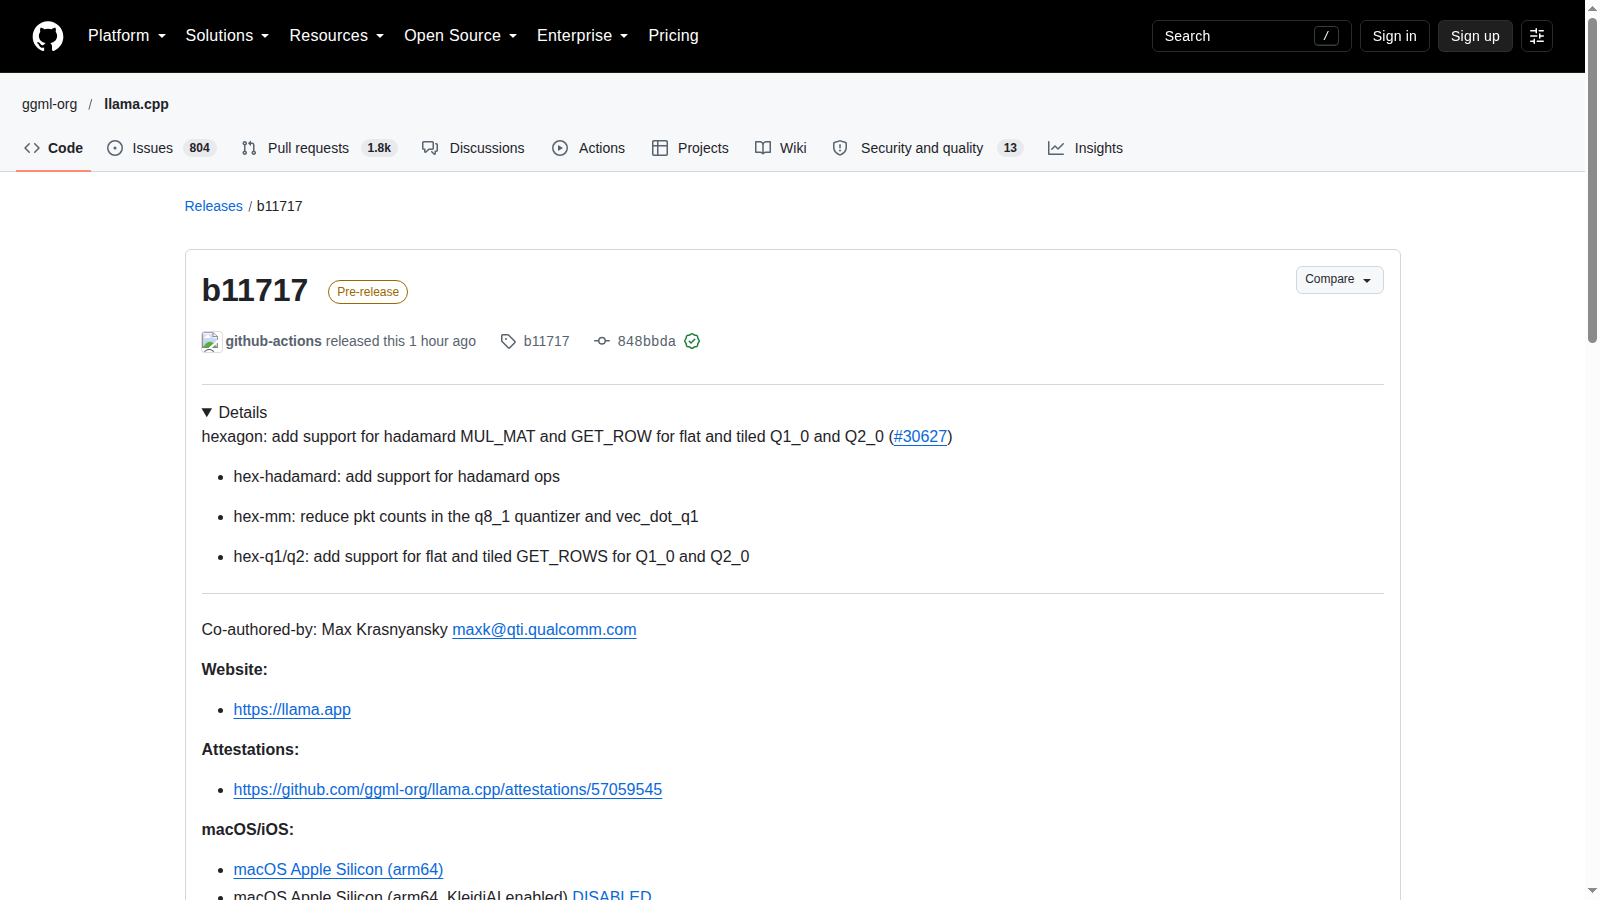
La prerelease b11717 completa sul backend Hexagon le operazioni Hadamard `MUL_MAT` e `GET_ROW` per i formati Q1_0 e Q2_0, sia flat sia tiled. Il progetto dichiara così pienamente utilizzabili le quantizzazioni Q1 e Q2 di Bonsai-2 sui pacchetti Snapdragon per Linux e Android.
Limiti da conoscere
Limite: È una prerelease e il contributo dichiara ancora necessario altro lavoro per sfruttare meglio la minore pressione sulla memoria DDR rispetto a Q4 e formati superiori. Questo run ha verificato codice, release e pacchetti ufficiali, ma non ha eseguito Bonsai-2 su un dispositivo Snapdragon con NPU Hexagon.
La release stabile 1.106.0 cambia il confine operativo del gateway: i server MCP locali via `stdio` sono disabilitati per default e richiedono un opt-in esplicito. La stessa versione cifra a riposo i parametri sensibili di guardrail e strumenti di ricerca, aggiunge un quickstart Docker con gateway, Postgres e interfaccia amministrativa e introduce un harness minimale per i loop di tool calling.
Limiti da conoscere
Limite: Il cambio di default può interrompere configurazioni che avviavano processi MCP locali senza aver dichiarato l’opt-in. La cifratura protegge i valori memorizzati ma non elimina i rischi di log, variabili d’ambiente, permessi del database o chiavi già esposte. Questo run ha verificato release e pull request, non ha aggiornato né provato un gateway owner in produzione.
REA agents 6.7.0 rende distribuibili via npm le capacità accumulate nel checkpoint 6.6.0: integra Kuna come provider statico installato dall’utente, riusa fatti JavaScript già analizzati, legge più tabelle locali APK in una sola decodifica ed estende Ghidra a PE Windows ARM e immagini raw m68k esplicite. Corregge inoltre la modifica di configurazioni JSON e JSONC con membri duplicati.
Limiti da conoscere
Limite: Il supporto varia per provider e piattaforma: Kuna è verificato con la versione 1.833 su Linux ma non supporta Windows, PE o Mach-O universali; ARM64EC, ARM64X, host Windows on Arm e m68k su Linux restano non verificati o non supportati. REA restituisce pseudocodice, relazioni ed evidenze, ma non prova da solo la ricostruzione completa di un’applicazione. Questo run ha analizzato release e documentazione, senza eseguire un test end-to-end su software proprietario.
vLLM 0.32.0 è comparso su PyPI con wheel manylinux per x86_64 e aarch64 e archivio sorgente. Il pacchetto richiede Python da 3.11 a prima di 3.15. L’upgrade include inoltre default CORS più restrittivi, correzioni di sicurezza e incompatibilità che riguardano dipendenze, API e percorsi di esecuzione.
Limiti da conoscere
Limite: La wheel PyPI predefinita segue il percorso CUDA 13.0 indicato dal progetto; ROCm usa un indice dedicato e immagini container separate. La presenza degli artefatti non dimostra compatibilità con una GPU, un modello o un deployment esistente. In questo run non sono stati installati pacchetti, avviati server o eseguiti benchmark AMD/ROCm.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.