
L’ANALISI
llama.cpp: nuovi kernel SME2 per Q4_K e Q6_K con KleidiAI
Analisi della build llama.cpp b11604: kernel KleidiAI SME2 per Q4_K e Q6_K, piattaforme Arm64, benchmark dichiarati, limiti e protocollo di prova.
In breve: Il delta è nel runtime: llama.cpp ora può usare KleidiAI SME2 per le quantizzazioni Q4_K e Q6_K sulle CPU Arm compatibili. Non significa accelerazione automatica su ogni macchina Arm né superiorità costante sul percorso predefinito; la build, il supporto SME2 e il carico reale devono essere verificati.
Che cosa è entrato nella build
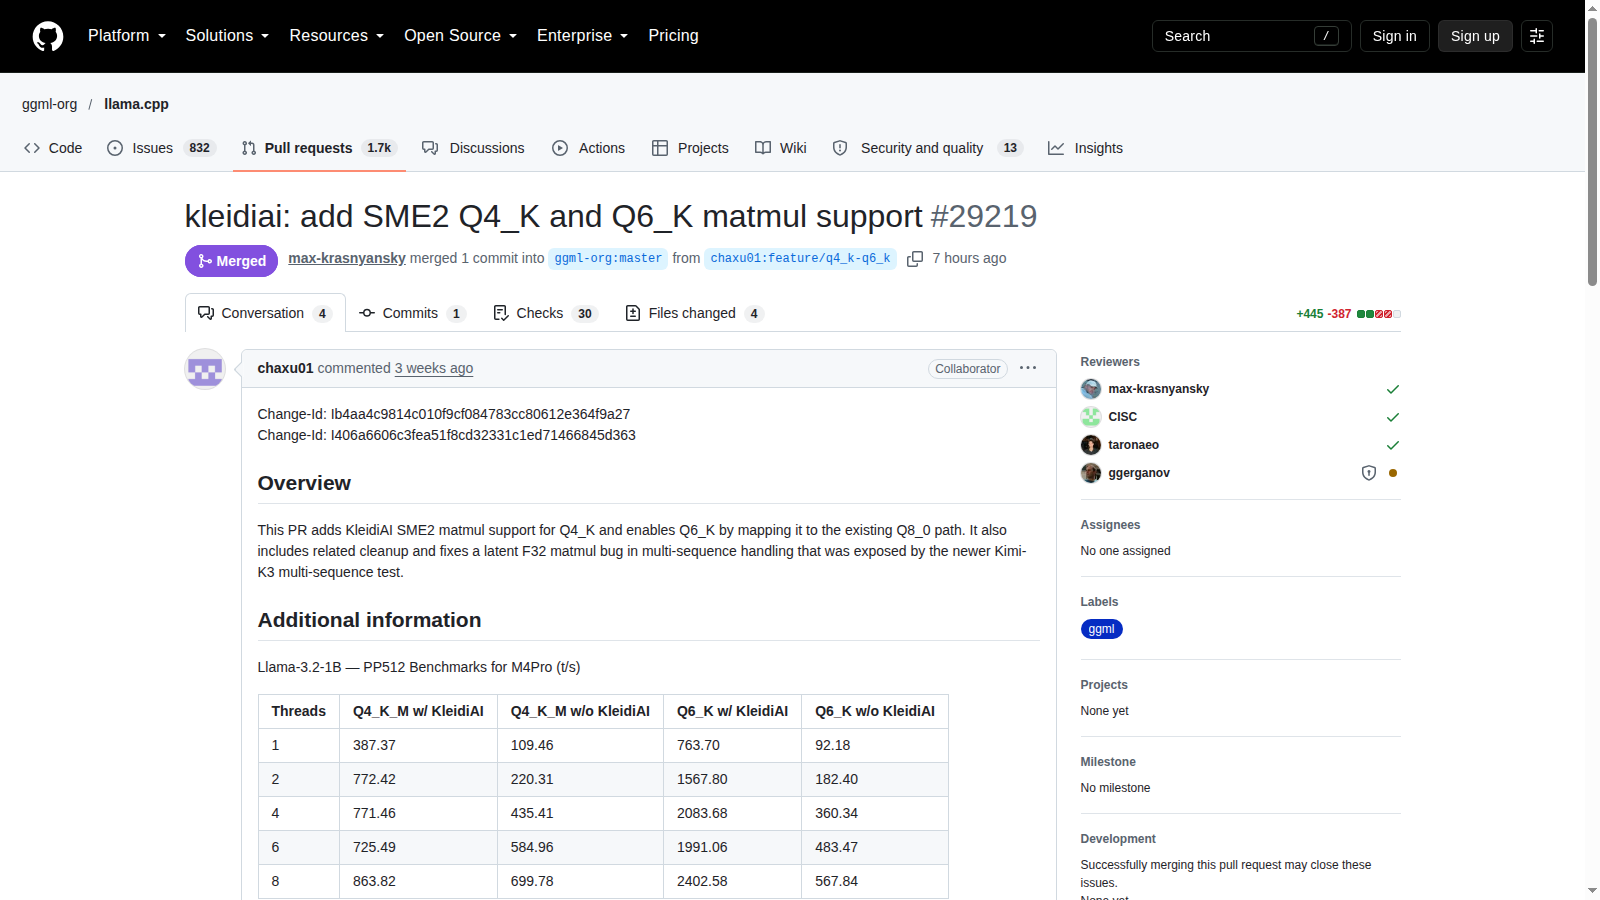
La pull request 29219 aggiunge il percorso di moltiplicazione di matrici KleidiAI SME2 per Q4_K e instrada Q6_K attraverso l’implementazione Q8_0 già presente. La stessa modifica include pulizia del codice e una correzione F32 per l’elaborazione multi-sequenza.
Dove cambia davvero l’inferenza locale
Il beneficio riguarda CPU Arm che espongono SME2 e una build con KleidiAI attivo. La release pubblica pacchetti Arm64 per Linux, Android e Windows, ma il semplice uso di un binario Arm64 non prova che il kernel SME2 venga selezionato durante l’inferenza.
Che cosa mostrano i benchmark
Nel test riportato dall’autore con Llama 3.2 1B e prompt processing da 512 token, Q4_K_M e Q6_K con KleidiAI superano il percorso senza KleidiAI a più conteggi di thread. Sono dati di progetto su un M4 Pro, non una misura indipendente né una garanzia per modelli e prompt diversi.
Perché il risultato non è uniforme
Nel riesame prima del merge, un maintainer ha confrontato un modello Qwen quantizzato su M4 Pro e ha osservato che il nuovo percorso può essere peggiore dei kernel MM_INT8 sui prompt lunghi. La scelta va quindi guidata da benchmark sul proprio modello, non dal picco migliore della tabella.
Cosa decidere oggi
Chi distribuisce modelli Q4_K o Q6_K su Arm può iniziare un confronto controllato tra b11604, build precedente e percorso predefinito. Per ambienti di produzione conviene attendere una build stabile o fissare commit, flag e rollback, perché b11604 resta pre-release.
Condizioni e limitazioni
È una build pre-release e non un rilascio stabile. I benchmark della pull request sono misure dei contributori su M4 Pro: mostrano forti guadagni nel test Llama 3.2 1B, ma un maintainer segnala che su prompt lunghi il percorso può restare inferiore ai kernel MM_INT8. Hardware, modello, lunghezza del prompt e build vanno quindi verificati separatamente.
Checklist pratica
- Verificare che la CPU e il sistema operativo espongano SME2.
- Fissare il commit 45451c3 e registrare i flag usati per compilare KleidiAI.
- Usare lo stesso modello GGUF Q4_K_M o Q6_K in tutte le prove.
- Confrontare prompt corti e lunghi, prompt processing e generazione separatamente.
- Registrare dal log il backend selezionato, thread, token al secondo e memoria.
- Mantenere la build precedente pronta per il rollback finché il risultato non è stabile.