
L’ANALISI
Granite RAG Library: adapter LoRA, aLoRA e GGUF per pipeline locali
Analisi pratica della Granite RAG Library: sei adapter per pipeline RAG, varianti LoRA e aLoRA, file GGUF, firme dei modelli e checklist per provarli in locale.
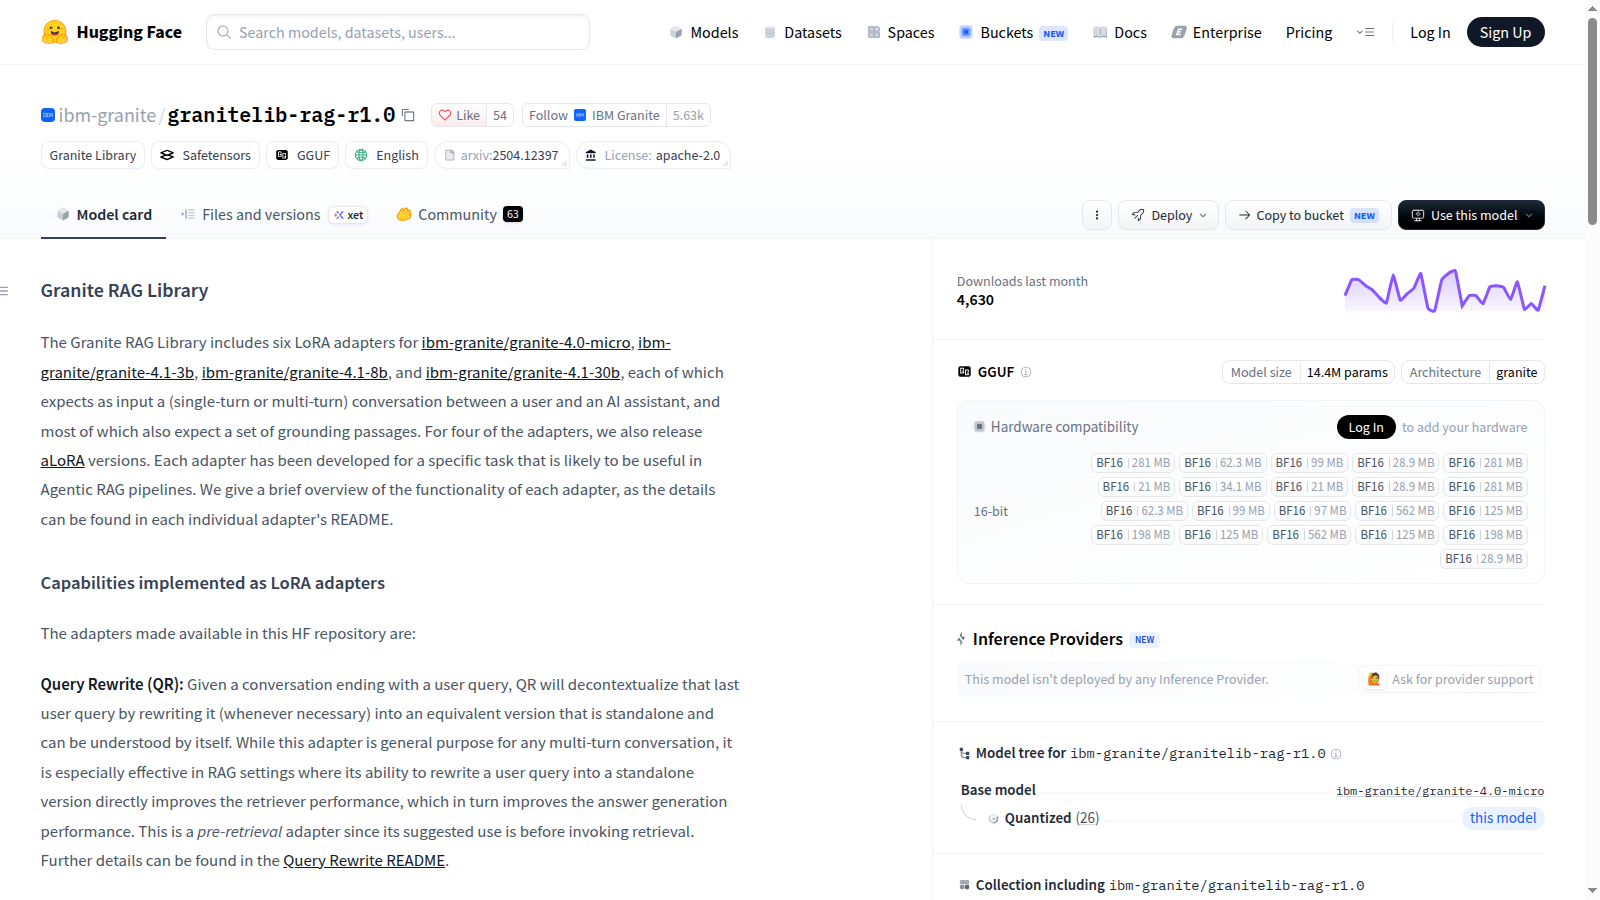
In breve: La Granite RAG Library rende scaricabili componenti specializzati per controllare una pipeline RAG prima e dopo il retrieval, senza affidare ogni passaggio a un unico modello generativo. Offre adapter per riscrittura e chiarimento delle query, rilevanza, answerability, allucinazioni e citazioni, con formati utili anche a Ollama e vLLM; i risultati dichiarati vanno però riprodotti sui propri documenti.
Che cosa è disponibile
La raccolta copre Granite 4.0 Micro e Granite 4.1 nelle taglie 3B, 8B e 30B. I file includono adapter LoRA in Safetensors, quattro famiglie aLoRA, conversioni GGUF, configurazioni e Modelfile: non è soltanto una descrizione di ricerca, ma un pacchetto scaricabile con licenza Apache 2.0.
Dove entrano gli adapter nella pipeline
Query rewrite e query clarification lavorano prima del retrieval o della generazione. Context relevance valuta ogni passaggio recuperato; answerability decide se le fonti bastano; hallucination detection e citation generation aggiungono controlli e riferimenti dopo il recupero. Separare questi compiti permette di misurare ogni passaggio invece di giudicare solo la risposta finale.
LoRA, aLoRA e runtime locali
Le varianti LoRA richiedono il modello base compatibile. aLoRA è pensata per attivare adapter in porzioni specifiche del flusso e riutilizzare il contesto condiviso. Il repository include GGUF, Modelfile e script per Ollama, oltre a uno script vLLM: la compatibilità concreta dipende comunque dalla versione del runtime e dalla corretta combinazione tra base e adapter.
Firme e integrità degli artefatti
Diversi adapter includono file di firma e la model card indica il tool model-signing per verificarli. Questo consente di distinguere il controllo di integrità dalla fiducia nelle prestazioni: una firma valida conferma l’artefatto atteso, non dimostra accuratezza o robustezza sul proprio corpus.
Come leggere i benchmark
Le tabelle sono evidenza del progetto, non una valutazione indipendente. La revisione del 14 ottobre precisa anche il riferimento usato per i decision model e avverte che il wording dei prompt non è stato ottimizzato. Per una decisione operativa servono quindi un set etichettato, metriche per singolo compito e test delle astensioni.
Condizioni e limitazioni
Le accuratezze e i confronti sono misure pubblicate dal team IBM su dataset e prompt propri. La model card avverte che i prompt dei decision model non sono stati ottimizzati per questi compiti; inoltre l’integrazione locale richiede di abbinare correttamente adapter, modello base e runtime.
Checklist pratica
- Scegliere un solo compito iniziale, per esempio answerability o context relevance.
- Fissare modello base, adapter, commit 167c451 e versione del runtime.
- Verificare firma e checksum prima di caricare i pesi.
- Preparare un set etichettato con esempi reali, casi ambigui e documenti irrilevanti.
- Misurare accuratezza, falsi positivi, falsi negativi, astensioni, latenza e memoria.
- Confrontare LoRA e aLoRA solo a parità di modello, prompt e dati.
- Testare il rollback e impedire che una classificazione incerta diventi automaticamente una decisione irreversibile.