
L’ANALISI
vLLM 0.32.0 su PyPI: cosa verificare prima dell’upgrade
Guida pratica a vLLM 0.32.0: artefatti PyPI, Python supportato, CORS, correzioni di sicurezza, breaking change e checklist di migrazione senza confondere disponibilità con compatibilità hardware.
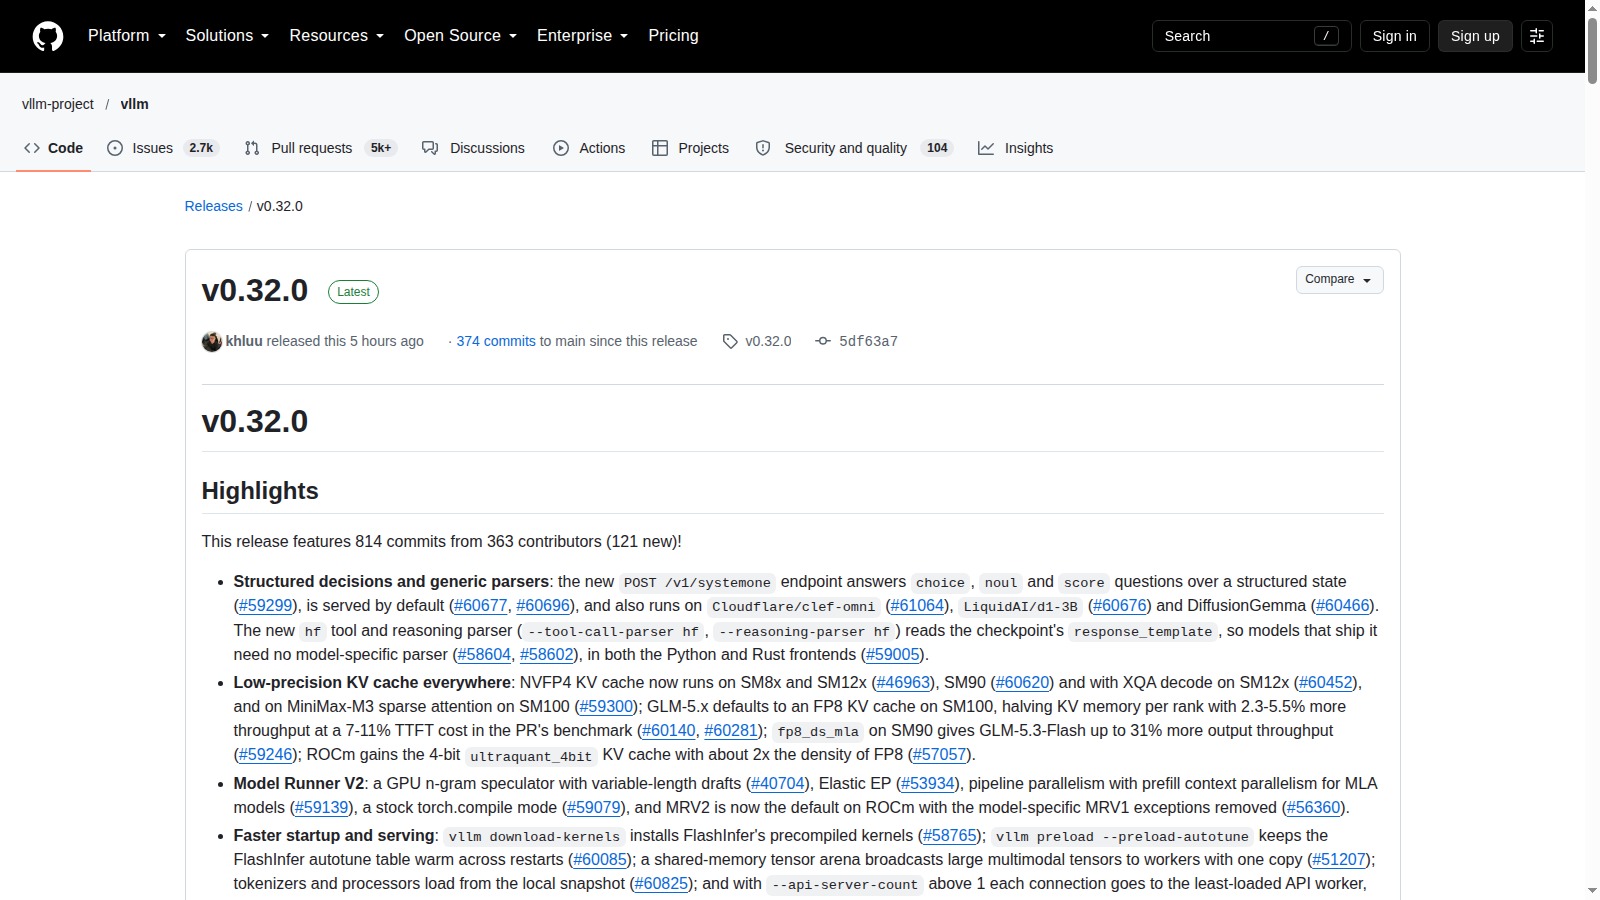
In breve: vLLM 0.32.0 è ora scaricabile da PyPI, ma non è un aggiornamento da applicare alla cieca. Prima di fissare la nuova versione bisogna verificare Python 3.11-3.14, backend hardware, origine dei client browser, dipendenze Transformers e Tokenizers, opzioni rimosse e contratti delle API usate.
Che cosa è diventato disponibile
PyPI espone la versione 0.32.0 con wheel manylinux per x86_64 e aarch64 e con archivio sorgente. Questo risolve il limite osservato poche ore prima, quando le note di release erano pubbliche ma il registry mostrava ancora la versione precedente.
Il comando pip non copre tutti i backend
Il percorso PyPI standard indicato dal progetto usa CUDA 13.0. Per ROCm la release pubblica un indice di wheel dedicato, mentre CPU, XPU e varianti CUDA hanno immagini o artefatti distinti. La scelta del pacchetto deve quindi partire dall’hardware e dal runtime reali, non soltanto dal numero di versione.
Python 3.10 esce dal perimetro
La release supporta Python da 3.11 a 3.14 e rimuove il supporto a Python 3.10. Un ambiente ancora fermo a 3.10 deve essere migrato o ricreato prima dell’upgrade, verificando anche la compatibilità delle altre dipendenze applicative.
CORS diventa più restrittivo per default
I frontend Python e Rust non accettano più ogni origine browser in modo predefinito. I deployment con console web o client JavaScript devono dichiarare le origini consentite e provare richieste preflight e autenticazione; riaprire tutto con una wildcard annullerebbe il beneficio del nuovo default.
Le correzioni di sicurezza richiedono un controllo operativo
Le note includono correzioni per esaurimento risorse nei chat template, limiti del tokenizer e socket P2P, oltre a restrizioni sui formati immagine non fidati, firma degli handle della cache multimodale e limite di profondità per gli schemi JSON. L’upgrade riduce rischi noti, ma non sostituisce limiti di input, isolamento e monitoraggio.
Le incompatibilità non si fermano a Python
Cambiano i requisiti minimi di Transformers e Tokenizers; vengono rimossi cascade attention, mamba_cache_mode=all e alcuni passaggi di parallelismo; max_tokens non viene più riservato dalla finestra di contesto e cambiano nomi di eventi reasoning nella Responses API. Ogni voce va confrontata con configurazioni e client effettivamente usati.
ROCm riceve novità, non una garanzia universale
La release porta Model Runner V2 come default su ROCm e aggiunge ottimizzazioni, cache a bassa precisione e correzioni per diversi percorsi AMD. Questi cambiamenti restano dipendenti da GPU, versione ROCm, modello e kernel disponibili: le percentuali pubblicate upstream non sono risultati riprodotti su un sistema di Francesco.
Una migrazione controllata separa installazione e serving
La prova utile crea un ambiente nuovo, installa la variante corretta, avvia lo stesso modello con la configurazione corrente e confronta API, output, memoria, latenza, throughput e failure case. Solo dopo questo confronto ha senso sostituire l’ambiente precedente.
Condizioni e limitazioni
La wheel PyPI predefinita segue il percorso CUDA 13.0 indicato dal progetto; ROCm usa un indice dedicato e immagini container separate. La presenza degli artefatti non dimostra compatibilità con una GPU, un modello o un deployment esistente. In questo run non sono stati installati pacchetti, avviati server o eseguiti benchmark AMD/ROCm.
Checklist pratica
- Inventariare Python, sistema operativo, GPU, driver, CUDA o ROCm e versione vLLM attuale.
- Creare un ambiente isolato con Python 3.11-3.14 senza modificare il deployment in produzione.
- Scegliere esplicitamente l’artefatto per CUDA, ROCm, CPU o XPU invece di assumere che la wheel standard sia universale.
- Fissare la versione e conservare il lockfile o l’elenco completo delle dipendenze risolte.
- Confrontare requisiti Transformers e Tokenizers, opzioni rimosse e semantica di max_tokens.
- Configurare allowed-origins per i client browser e provare preflight, autenticazione ed errori cross-origin.
- Avviare lo stesso modello e ripetere le API realmente usate, comprese Responses e streaming del reasoning.
- Eseguire almeno tre run comparabili misurando memoria, TTFT, latenza inter-token, throughput e failure case.
- Mantenere l’ambiente precedente pronto al rollback finché modello, client e osservabilità non superano i test.