
L’ANALISI
Ollama 0.40.4: modelli decisionali, MLX e embedding multimodali
Analisi pratica di Ollama 0.40.4: modelli decisionali da terminale, supporto MLX, embedding multimodali, integrazione Codex CLI e checklist di aggiornamento.
In breve: Ollama 0.40.4 rende più semplice usare in locale modelli specializzati nella decisione, non solo chatbot: dal terminale si possono classificare testi, rispondere a domande binarie e applicare rubriche. L’aggiornamento amplia anche MLX su Apple silicon e gli embedding multimodali, ma richiede test su accuratezza, compatibilità e regressioni prima dell’uso operativo.
Che cosa cambia nel terminale
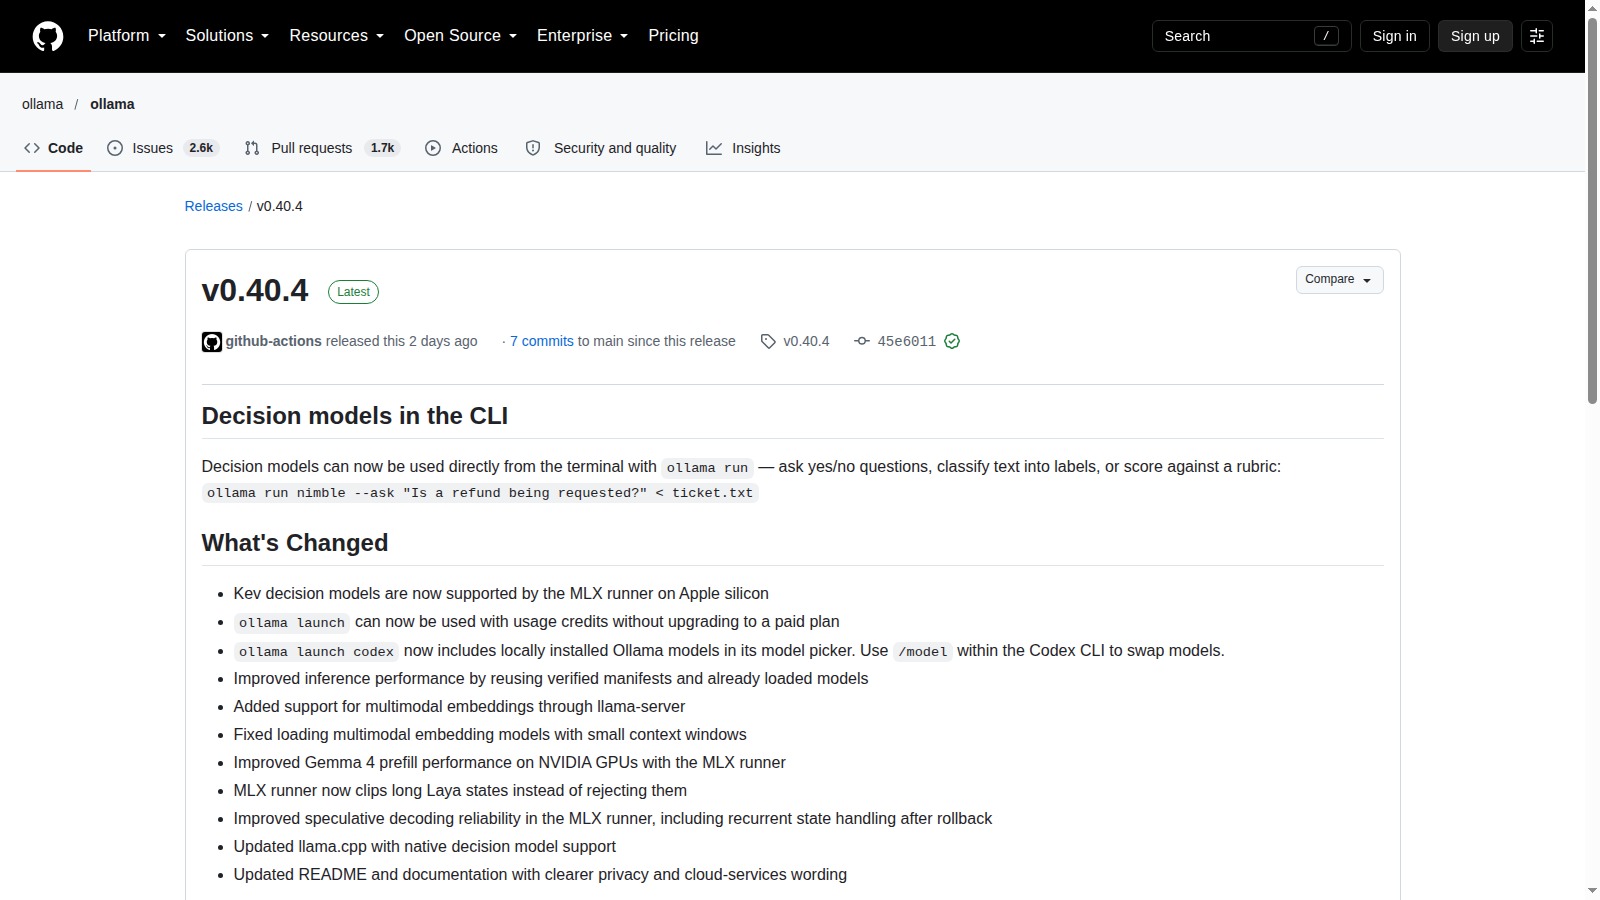
La novità più visibile è l’uso diretto dei decision model con ollama run. Il comando può ricevere testo da standard input e produrre una scelta binaria, un’etichetta o un punteggio rispetto a una rubrica, riducendo il codice necessario per prototipi di triage e classificazione.
MLX si estende su Apple silicon
Il runner MLX aggiunge supporto ai modelli decisionali Kev. La release dichiara anche miglioramenti al prefill di Gemma 4, gestione più robusta dello speculative decoding e clipping degli stati Laya troppo lunghi invece del rifiuto immediato.
Embedding multimodali e runtime
Il llama-server integrato supporta embedding multimodali. È un delta pratico per pipeline che devono rappresentare contenuti visivi e testuali, ma il comportamento effettivo dipende dal modello compatibile e dalla configurazione del contesto.
Integrazione con Codex CLI
ollama launch codex include ora i modelli Ollama installati localmente nel selettore /model. La funzione semplifica il passaggio tra modelli, ma non rende locale l’intero flusso se strumenti, autenticazione o altri servizi continuano a usare endpoint cloud.
Aggiornare senza confondere disponibilità e qualità
La release è stabile e distribuisce asset per più piattaforme. Questo prova la disponibilità del runtime, non l’accuratezza di ogni modello decisionale né un vantaggio prestazionale universale: servono dataset di controllo, misure di latenza e una procedura di rollback.
Condizioni e limitazioni
Le prestazioni e l’affidabilità dipendono dal modello, dall’hardware e dal runner. La release non pubblica benchmark comparativi completi; classificazioni, rubriche ed embedding vanno quindi verificati su dati reali prima di automatizzare decisioni.
Checklist pratica
- Salvare versione corrente, configurazione e modelli prima dell’aggiornamento.
- Installare la release stabile 0.40.4 e verificare il checksum dell’asset previsto per la piattaforma.
- Provare un modello decisionale con un piccolo set etichettato e misurare errori, astensioni e stabilità.
- Verificare su Apple silicon quale runner viene usato e confrontare memoria, latenza e output.
- Testare gli embedding multimodali con dimensioni, formati e finestre di contesto reali.
- Controllare in Codex CLI che /model mostri solo i modelli attesi e documentare i confini cloud/locali.
- Conservare un percorso di rollback e rieseguire i test di regressione prima della produzione.