
L’ANALISI
MASS di Sakana AI: cosa migliora e cosa non prova l’auto-supervisione multi-agente
Analisi pratica di MASS di Sakana AI: workflow search, selezione delle traiettorie, LoRA, risultati holdout, limiti e protocollo minimo di replica.
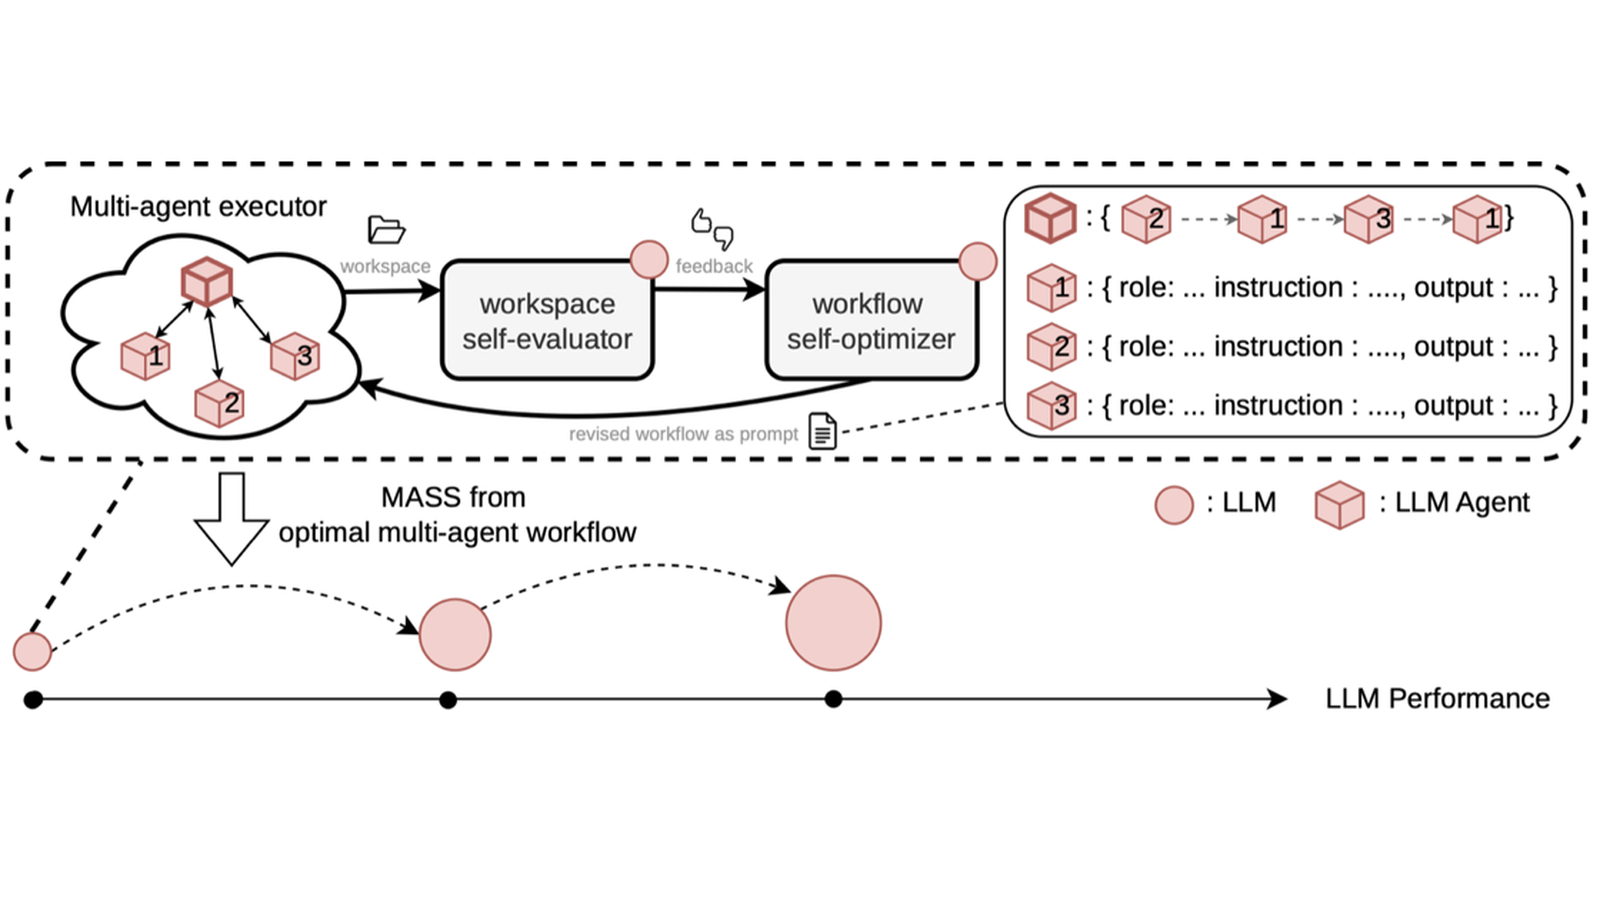
In breve: MASS non dimostra che un modello possa migliorarsi senza limiti. Mostra invece un ciclo misurabile: un sistema multi-agente genera e seleziona esperienze, poi le usa per adattare con LoRA il modello condiviso. Il risultato più utile è il confronto sui task holdout, ma resta un esperimento sintetico e dipendente dai propri valutatori.
Come funziona il ciclo MASS
Il punto di partenza è un unico modello usato in più ruoli. MASS cerca prima un workflow migliore per coordinare gli agenti, raccoglie le loro esecuzioni, seleziona quelle giudicate utili e trasforma quel lavoro collettivo in esempi di post-training.
Dalla coordinazione ai pesi
Il passaggio distintivo non è aggiungere altri agenti, ma trasferire parte dell’esperienza nel modello tramite LoRA. Dopo l’adattamento, lo stesso modello torna a risolvere, ottimizzare e valutare nel ciclo successivo.
Che cosa misurano gli autori
Il progetto usa 12 task sintetici nei domini finanza, robotica e farmacia. Tre task sono trattenuti dal post-training; sul confronto aggregato di questi holdout, il modello del secondo round ottiene un win rate dichiarato del 69,9% contro il modello base. Gli autori riportano inoltre un aumento dell’accordo con valutatori esterni dal 73% al 93% attraverso tre cicli.
Perché il risultato è interessante
Il lavoro separa tre meccanismi che spesso vengono confusi: ricerca del workflow, selezione delle traiettorie e aggiornamento dei pesi. Questo rende possibile verificare dove nasce il guadagno e confrontare costo in token, qualità e capacità di generalizzare.
Come leggere il claim senza hype
La formula “auto-miglioramento ricorsivo” descrive il ciclo sperimentale, non un’autonomia illimitata. Task sintetici, LoRA, giudizi prodotti dal modello e valutatori esterni sono condizioni precise; senza una replica non sappiamo quanto il vantaggio sopravviva a task reali, distribuzioni diverse o più cicli.
Condizioni e limitazioni
I risultati dichiarati riguardano 12 task sintetici in finanza, robotica e farmacia, con tre task holdout. La supervisione resta in parte interna allo stesso modello e può condividere blind spot; non è una prova di miglioramento ricorsivo in produzione né di generalizzazione ad altri modelli o workflow.
Checklist pratica
- Fissare modello, versione, task, budget di token e criteri di selezione prima del test.
- Separare i task usati per il post-training da almeno un set holdout non visto.
- Eseguire baseline e modello adattato per almeno tre run con gli stessi limiti.
- Registrare workflow, traiettorie selezionate, scarti, costi e failure case.
- Usare almeno un valutatore esterno e misurarne l’accordo con il giudice interno.
- Interrompere il ciclo se il guadagno holdout non supera variabilità e costo aggiuntivo.