
L’ANALISI
vLLM riduce la latenza del top-p nei piccoli batch
Analisi pratica del nuovo sampler top-p di vLLM: piccoli batch, benchmark B300 e H200, impatto end-to-end, condizioni di applicabilità e checklist di verifica.
In breve: Il nuovo percorso non rende ogni decode due volte più veloce: elimina una discontinuità di latenza nella fase di sampling top-p dei piccoli batch. Il vantaggio è maggiore quando il batch contiene righe top-p-only e top-k insieme, mentre l’effetto end-to-end dipende da quanto il sampler pesa rispetto a GEMM, attenzione e comunicazione distribuita.
Il collo di bottiglia nei piccoli batch
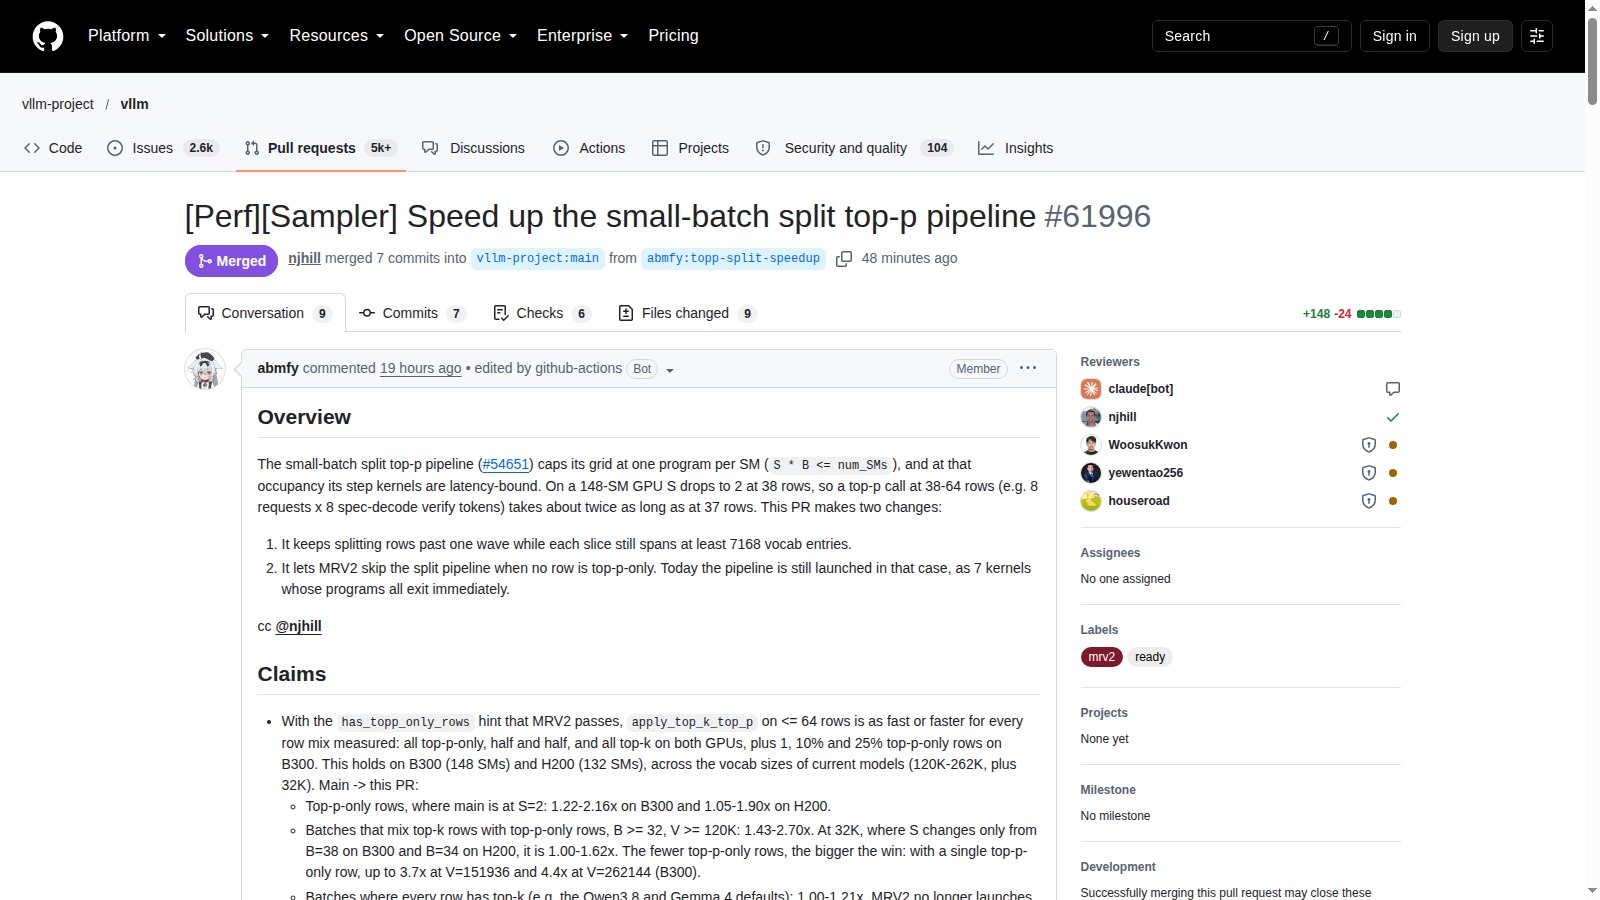
La pipeline split limitava la griglia a un programma per streaming multiprocessor. Su GPU con 132 o 148 SM il fattore di split scendeva bruscamente intorno a 34-38 righe, raddoppiando in alcuni casi il tempo del sampler anche se il batch cresceva di una sola riga.
Che cosa cambia nel kernel
La patch continua a suddividere le righe oltre la prima wave finché ogni slice conserva almeno 7168 elementi di vocabolario. Inoltre MRV2 passa un indicatore che evita di lanciare sette kernel split quando nessuna riga richiede esclusivamente top-p.
I benchmark pubblicati
Su B300 e H200, con batch fino a 64 righe e vocabolari da 120K a 262K, il contributore riporta accelerazioni da 1,22 a 2,16 volte per righe solo top-p e da 1,43 a 2,70 volte nei batch misti più rilevanti. Nel caso MiMo-V2.6 su B300, 38 righe passano da 561 a 219 microsecondi e 64 righe da 565 a 318.
Quanto cambia il servizio completo
Il microbenchmark isola il sampler, quindi non misura da solo la latenza dell’intero modello. Nel test end-to-end pubblicato con Llama 3 8B Instruct a concorrenza 48, la mediana inter-token migliora del 5,1%; con MiMo-V2.6 il tempo GPU esclusi i GEMM MoE cala di 0,27 millisecondi su uno step da 22,7 millisecondi.
Modelli e workload interessati
Il delta è più pertinente per serving NVIDIA con piccoli batch, vocabolari ampi, speculative decoding e richieste che usano top-p. Configurazioni che saltano top-p, batch diversi o GPU con un altro numero di SM possono vedere un vantaggio minore o nullo.
Condizioni e limitazioni
Il cambiamento è appena confluito nel ramo main e non appartiene ancora a una release stabile. Le misure provengono dal contributore su NVIDIA B300 e H200, con configurazioni specifiche di vocabolario, batch e sampling: il guadagno end-to-end pubblicato è più contenuto del microbenchmark e va misurato sul proprio modello.
Checklist pratica
- Fissare il commit precedente e 7b6310c1, insieme a immagine container, driver, CUDA e configurazione vLLM.
- Ripetere il benchmark con gli stessi batch 16, 32, 38, 48 e 64 e con il vocabolario del modello in produzione.
- Separare il tempo del sampler da TTFT, inter-token latency, throughput e durata completa della richiesta.
- Provare separatamente righe top-p-only, batch misti top-k/top-p e workload che disattivano top-p.
- Controllare qualità e determinismo con seed e parametri identici, non soltanto la velocità del kernel.
- Attendere una release o mantenere un rollback semplice se il commit viene portato in produzione prima del tag.