
L’ANALISI
Trident-Qwen3VL-2B: retrieval unico tra testo e immagini
Analisi pratica di Trident-Qwen3VL-2B: pesi BF16, retrieval testo-immagine, dataset, benchmark, requisiti, licenze e checklist di valutazione.
In breve: Il delta utile è un pacchetto completo e scaricabile per il retrieval multimodale: modello da 2,13 miliardi di parametri, codice, circa 211 mila query di training e benchmark con corpus testuali, visivi e fusi. Può quindi essere provato come retriever per RAG su documenti misti, ma prestazioni, costo GPU e conformità delle immagini vanno verificati sul proprio corpus.
Che cosa è diventato eseguibile
Il repository Hugging Face ora contiene il checkpoint BF16 di Trident-Qwen3VL-2B con l’adapter LoRA già fuso. Il codice ufficiale accetta query e documenti testuali, visivi o combinati, normalizza gli embedding e consente di confrontarli nello stesso spazio con similarità coseno.
Perché i corpus misti sono il punto centrale
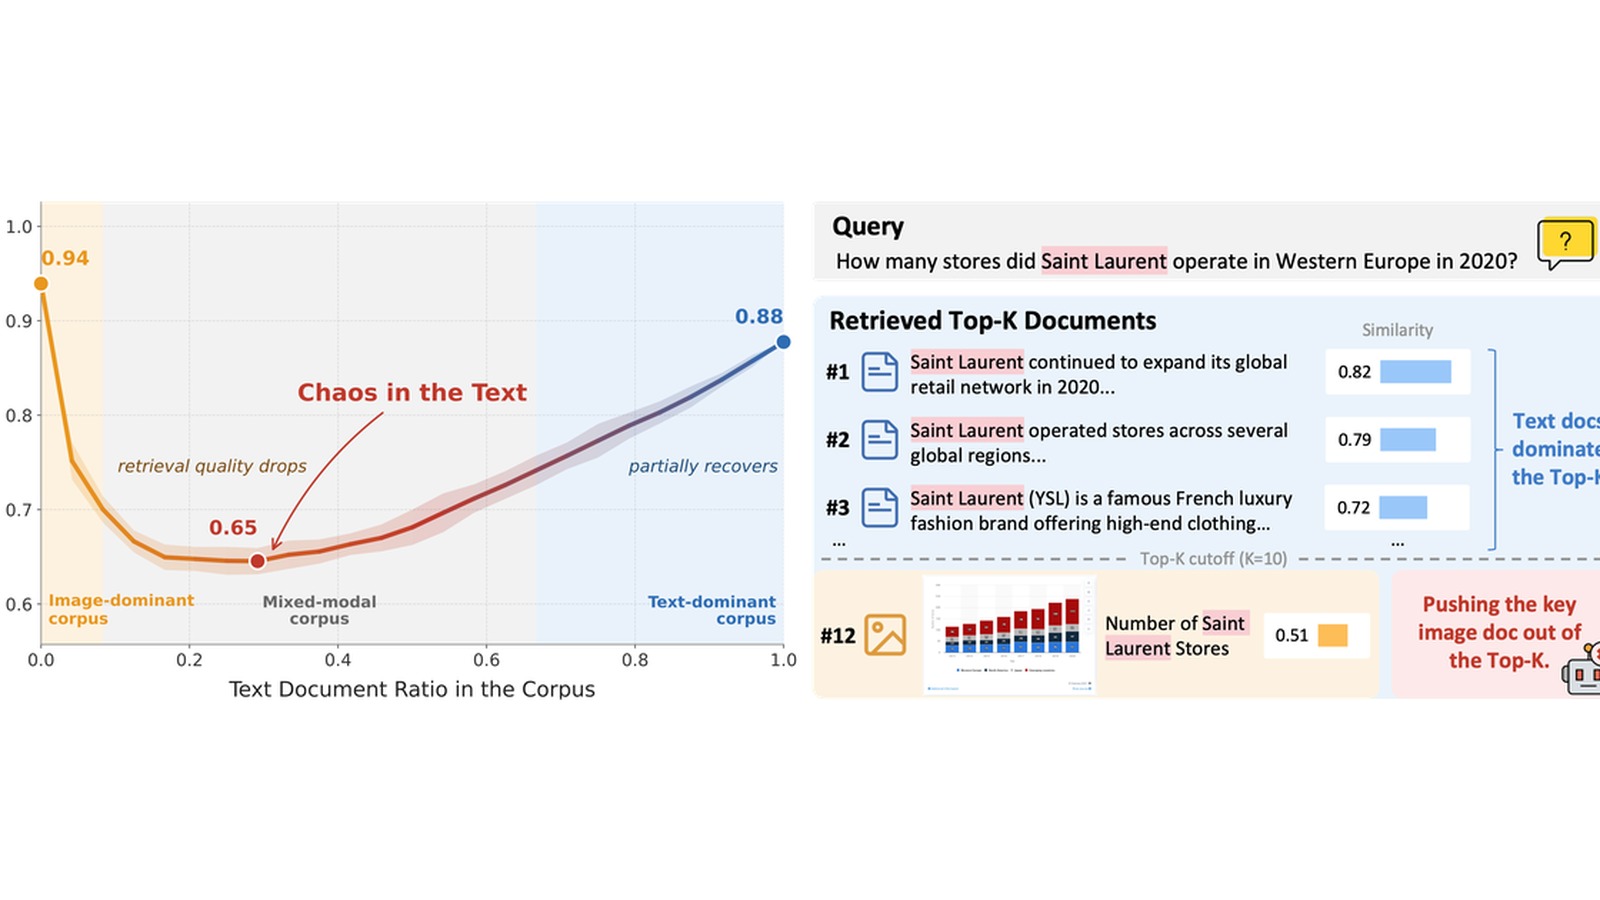
Il lavoro parte da una distorsione misurata dagli autori: nei corpus che mescolano testo e immagini, i retriever possono assegnare punteggi maggiori al testo anche quando un’immagine è più pertinente. Trident addestra tre viste equivalenti dello stesso documento, testo, immagine e versione fusa, come positivi nello stesso obiettivo contrastivo.
Dati e benchmark disponibili
Trident-Train pubblica circa 41 mila query per documenti visivi e circa 170 mila per immagini naturali. Trident-Eval include dieci dataset con corpus originali e misti, query e giudizi di rilevanza. Questo permette di misurare non soltanto la qualità media, ma anche quanto il ranking cambia quando varia la composizione delle modalità.
Requisiti e confine operativo
Il quickstart è testato con Python 3.12, Transformers 4.57.1 e una GPU CUDA. Gli esperimenti completi dichiarati nel repository hanno usato otto NVIDIA A100 da 80 GB; questo dato riguarda training e valutazioni degli autori, non prova che ogni inferenza richieda quel cluster. Non è disponibile un endpoint gestito nella scheda del modello.
Licenze e limiti da non saltare
Le parti specifiche di Trident sono MIT e la base Qwen3-VL-2B-Instruct è Apache-2.0, ma immagini e dataset di origine mantengono licenze proprie. Prima di importare gli archivi in un sistema aziendale servono inventario delle fonti, regole di conservazione e un test separato sul corpus reale.
Condizioni e limitazioni
I risultati arrivano dagli autori e non sono stati riprodotti in questo aggiornamento. Il quickstart richiede CUDA, il training dichiarato usa otto A100 da 80 GB e immagini, query e annotazioni derivate conservano le licenze dei dataset originali. La scheda non indica un provider di inferenza gestito.
Checklist pratica
- Bloccare commit di codice e revisione del checkpoint prima del download.
- Inventariare licenze e provenienza delle immagini usate nel test.
- Creare un piccolo corpus con documenti testuali, immagini e record fusi equivalenti.
- Misurare NDCG o recall separando corpus originale e corpus misto.
- Confrontare Trident con il retriever già in uso a parità di candidati.
- Registrare VRAM, latenza e throughput su una GPU realmente disponibile.
- Controllare errori e ranking manualmente prima di collegarlo a un RAG in produzione.