
L’ANALISI
K2-Horizon in GGUF: quantizzazioni pronte, supporto llama.cpp ancora nel fork IFM
Guida pratica ai GGUF di K2-Horizon: taglie 0,9B, 3,7B, 7B e MoVA 36B-A4B, quantizzazioni disponibili, fork llama.cpp richiesto, limiti e checklist di prova.
In breve: Il delta pratico è la disponibilità di GGUF ufficiali, dal modello compatto 0,9B al MoVA 36B-A4B, con sei profili tra BF16 e Q4_K_M. Oggi però non basta scaricare un file e usare una build standard: le model card indicano che il supporto K2 Horizon per llama.cpp è ancora in corso e rimandano al fork IFM.
Che cosa è stato pubblicato
La famiglia ora dispone di repository GGUF ufficiali per 0,9B, 3,7B, 7B e MoVA 36B-A4B. Ogni repository espone BF16, Q8_0, Q6_K, Q5_K_M, Q5_0 e Q4_K_M, con tokenizer e chat template incorporati.
Come scegliere la taglia
0,9B è il punto di ingresso compatto con contesto dichiarato fino a 128K. I modelli densi 3,7B e 7B dichiarano 512K; il MoVA conserva 36B parametri ma ne attiva 4B per token. RAM, VRAM e velocità reali dipendono dalla quantizzazione, dal backend e dalla lunghezza effettiva del contesto.
Il vincolo del runtime
Le model card avvertono che l’architettura K2 Horizon richiede codice llama.cpp dedicato. La pull request upstream è indicata come in corso; il percorso disponibile oggi passa dal ramo model/K2Horizon del fork MBZUAI-IFM. Questo rende il rilascio eseguibile, ma non ancora plug-and-play per chi aggiorna solo llama.cpp main.
Come leggere i benchmark
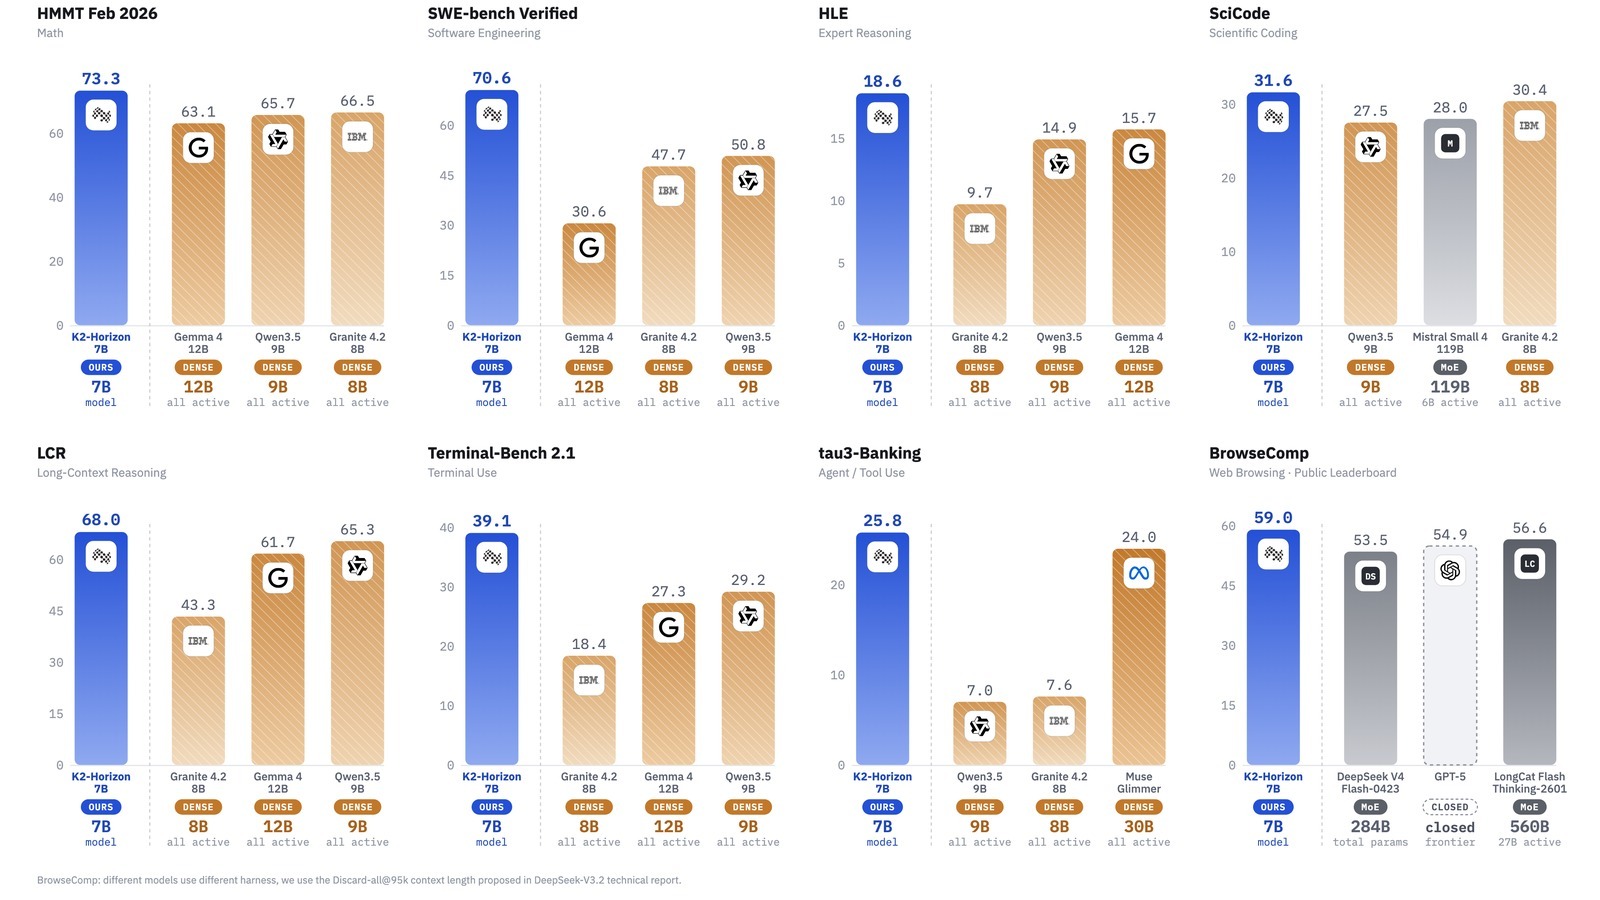
Le tabelle ufficiali confrontano BF16 e quantizzazioni su più benchmark e mostrano che la perdita non è uniforme tra compiti. Sono risultati del progetto, con protocolli che possono differire tra modelli: servono test locali separati per qualità, memoria, token al secondo e stabilità del contesto.
Condizioni e limiti
Non ho eseguito i modelli né verificato la compatibilità su CPU, GPU diverse o frontend che incorporano una propria build di llama.cpp. Il supporto upstream può cambiare rapidamente; prima di automatizzare il deploy va fissato il commit del fork e registrato il file GGUF scelto.
Condizioni e limitazioni
La disponibilità dei GGUF non equivale ancora a compatibilità immediata con una build standard di llama.cpp. I benchmark e i confronti di qualità delle quantizzazioni sono dichiarati dal progetto; non ho riprodotto inferenza, memoria, velocità o tenuta del contesto lungo su hardware locale.
Checklist pratica
- Scegli la taglia e la quantizzazione in base a RAM o VRAM realmente disponibili.
- Clona il fork MBZUAI-IFM sul ramo model/K2Horizon e fissa il commit usato.
- Scarica un solo GGUF e verifica checksum, metadati del tokenizer e chat template.
- Avvia prima un prompt breve, poi misura memoria e token al secondo.
- Prova il contesto lungo in modo progressivo, senza assumere che il massimo dichiarato sia praticabile.
- Confronta almeno BF16 o Q8_0 con la quantizzazione scelta su un set di prompt ripetibile.