
L’ANALISI
MiniCPM-V 4.7 in GGUF: dal modello 1B al MoE 35B-A3B
Guida pratica ai GGUF di MiniCPM-V 4.7 1B e 35B-A3B: quantizzazioni, mmproj, llama.cpp, DSpark, requisiti e limiti.
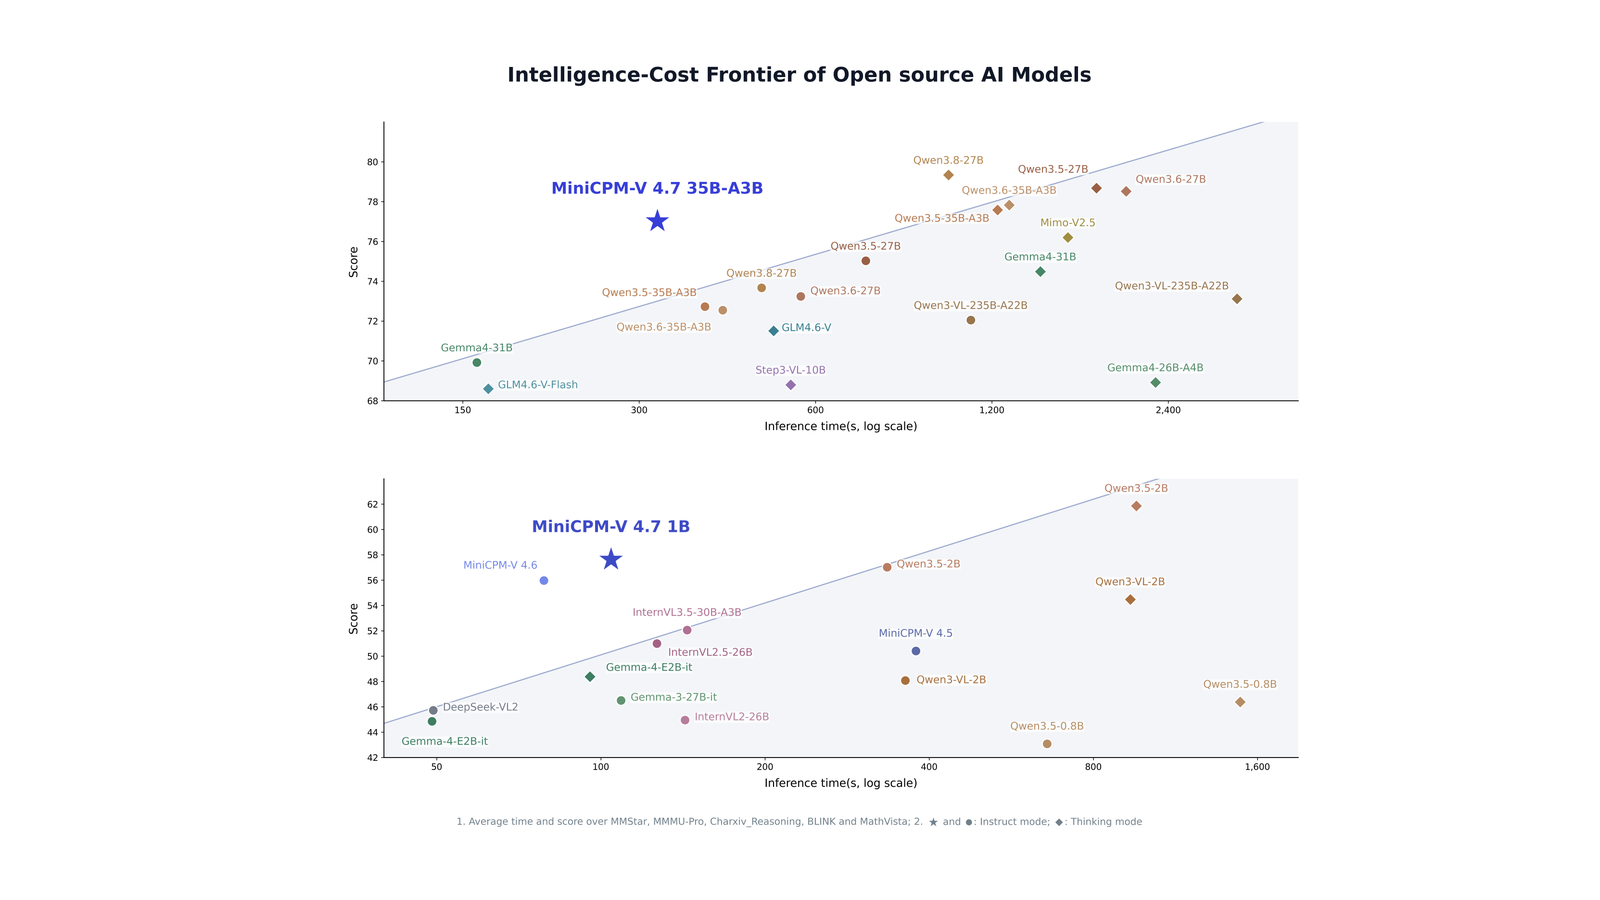
In breve: Il delta concreto è che i due modelli MiniCPM-V 4.7 ora hanno pacchetti GGUF ufficiali pronti per llama.cpp: il compatto 1B e il MoE 35B-A3B, con quantizzazioni F16, Q8, Q6, Q5, Q4 e IQ4_XS, proiettore visivo e varianti DSpark. Questo rende possibile provare localmente comprensione di immagini e video, ma non elimina i vincoli di memoria, storage e compatibilità della build.
Che cosa è diventato scaricabile
I repository ufficiali separano 1B e 35B-A3B e includono i file del modello, il proiettore visivo mmproj e profili che vanno da F16 a IQ4_XS. Il 35B-A3B aggiunge anche una quantizzazione mista dedicata al percorso on-device.
Come si avvia con llama.cpp
La model card espone il comando llama serve con il riferimento Hugging Face e il profilo Q4_K_M. Per input visivi occorre usare il proiettore mmproj coerente con il modello; per DSpark servono anche il draft model e le opzioni speculative indicate dal progetto.
1B o 35B-A3B
Il modello 1B privilegia dimensioni e semplicità per dispositivi limitati. Il 35B-A3B è un MoE che attiva una parte dei parametri per token, ma tutti gli esperti devono comunque restare disponibili su storage e transitare secondo lo scheduler: il requisito reale non coincide con i soli parametri attivi.
Cosa misurare prima di adottarlo
Le priorità sono tempo di caricamento, RAM e memoria grafica, token al secondo, qualità OCR, tenuta su immagini dense e stabilità del percorso video. I benchmark del progetto aiutano a scegliere il candidato, non sostituiscono una prova sul proprio hardware.
Licenza e confine operativo
Le model card dichiarano Apache 2.0. L’inferenza può restare locale con llama.cpp o Ollama, ma download iniziali, applicazioni client e integrazioni esterne vanno verificati separatamente prima di descrivere l’intero flusso come offline.
Condizioni e limitazioni
La pubblicazione dei file non equivale a una prova indipendente su ogni dispositivo. Il 35B-A3B richiede spazio e banda rilevanti nonostante attivi circa 3B parametri per token; i 13+ token/s su iPhone 17 Pro Max e i confronti di qualità restano misure dichiarate dal progetto.
Checklist pratica
- Scegliere 1B per il primo test e partire da Q4_K_M.
- Scaricare anche il file mmproj corretto per gli input visivi.
- Usare una build recente di llama.cpp e registrare commit e comando.
- Misurare RAM, storage, latenza e token al secondo con gli stessi prompt.
- Provare OCR, una scena complessa e un breve video prima di salire al 35B-A3B.
- Valutare DSpark solo dopo avere una baseline stabile senza decoding speculativo.