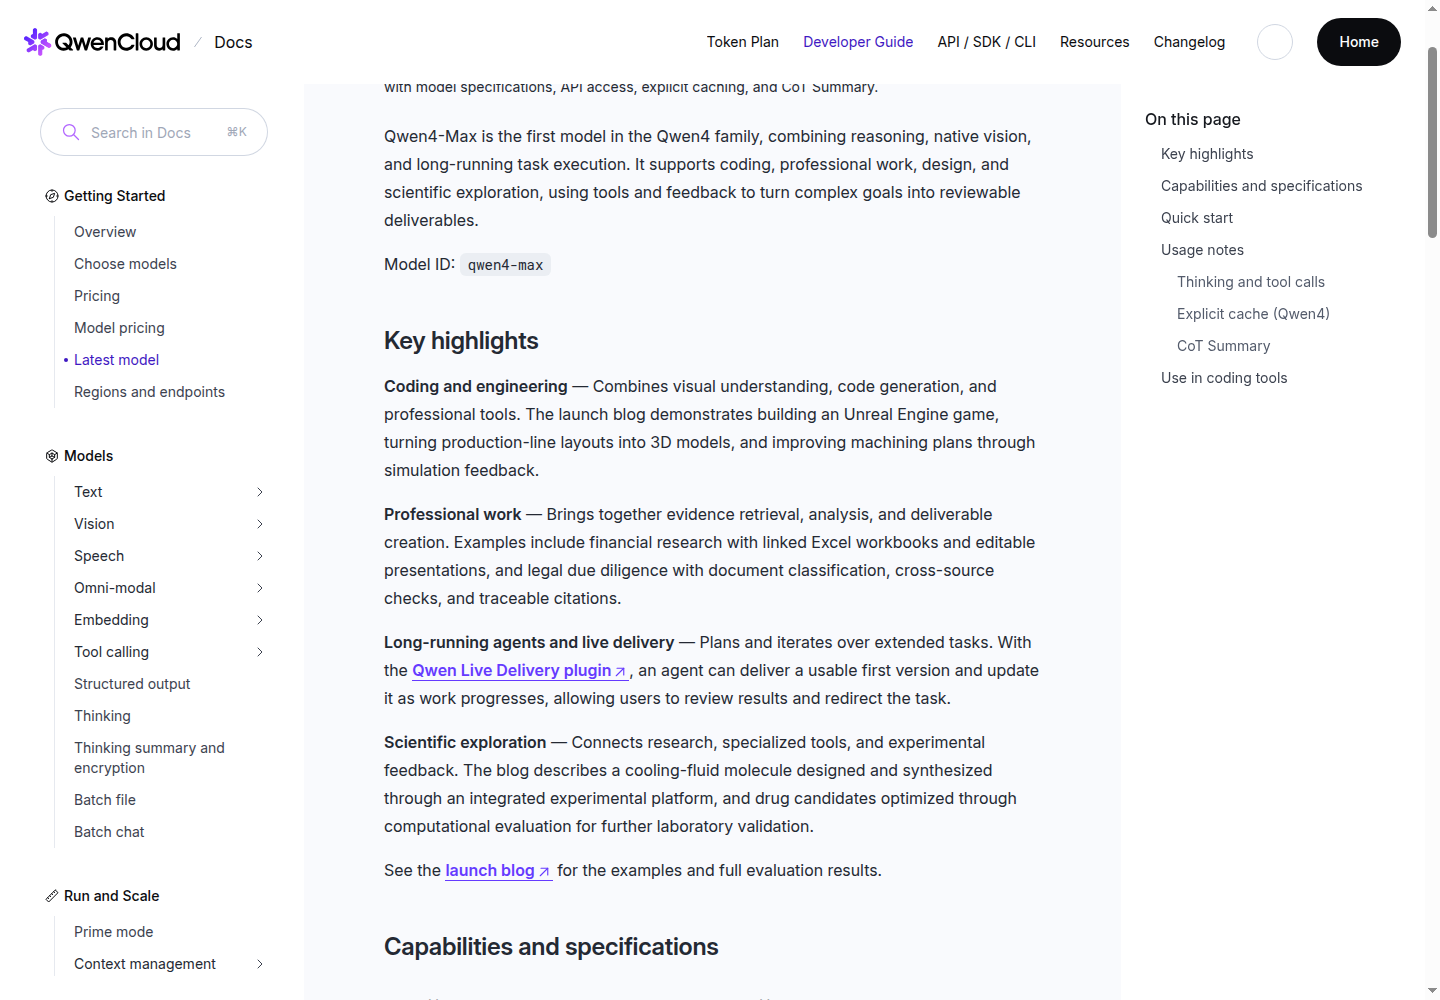
Qwen4-Max, chiamato anche Qwen 4 Max, è il modello multimodale di punta presentato da Alibaba il 16 novembre 2026, dopo la preview dell’11 novembre. Si usa attraverso servizi cloud e API: non è un modello a pesi scaricabili per Ollama o per il tuo PC. Alibaba annuncia separatamente modelli Qwen4 più piccoli a pesi aperti, ma l’annuncio non ne stabilisce date, taglie e licenze.
Specifiche, prezzi e catalogo dei pesi ricontrollati il 18 novembre 2026; valutazioni indipendenti fotografate il 17 novembre. Questa guida confronta documentazione ufficiale e valutazioni indipendenti. Non contiene un benchmark interno di Qwen4-Max: le demo sono del produttore e i risultati di terzi restano attribuiti ai loro autori.
Qwen4-Max in breve
- Il modello disponibile in API è
qwen4-max.qwen4-max-previewè un identificatore distinto: il changelog QwenCloud colloca la preview all’11 novembre e il rilascio al 16 novembre 2026. - Comprende testo, immagini e video e produce testo. La scheda tecnica ufficiale indica una finestra di contesto di 1.000.000 di token.
- Il listino Singapore è 1,50 $ per milione di token in ingresso e 4,50 $ in uscita. Altre regioni e ambiti di elaborazione hanno condizioni diverse: il riferimento è il listino dettagliato per modello e regione.
- Il blog Qwen descrive 2.400 miliardi di parametri del backbone, 71 miliardi attivi per token e un modulo N-gram Embedding aggiuntivo da 328 miliardi. “Attivi” non significa memoria necessaria per eseguirlo in locale.
- Artificial Analysis e Plotly offrono riscontri esterni. Le loro misure non vanno mescolate con Work360, il benchmark interno di Alibaba.
È uscito Qwen4-Max oppure soltanto una preview?
È uscito il modello qwen4-max. La confusione viene dalla sequenza molto ravvicinata: l’11 novembre era stata aperta la preview; il 16 novembre sono arrivati il rilascio e la documentazione per l’API a consumo.
Le due voci restano separate nel changelog. Anche la guida ufficiale distingue i vantaggi della preview dalle modalità di accesso al modello finale tramite API e Token Plan.
Per un progetto nuovo controlla quindi tre elementi: il nome esatto nella risposta dell’API, l’endpoint che stai chiamando e il piano che paga la richiesta. Un’interfaccia con scritto “Qwen4” non dimostra da sola quale versione abbia eseguito il lavoro.
Il primo avviso era già nel Radar AI del 16 novembre, dedicato alle differenze dalla preview. Qui il punto è capire se convenga usarlo e che cosa significhi, concretamente, la promessa dei modelli aperti.
Qwen4-Max è open source? Si può usare con Ollama?
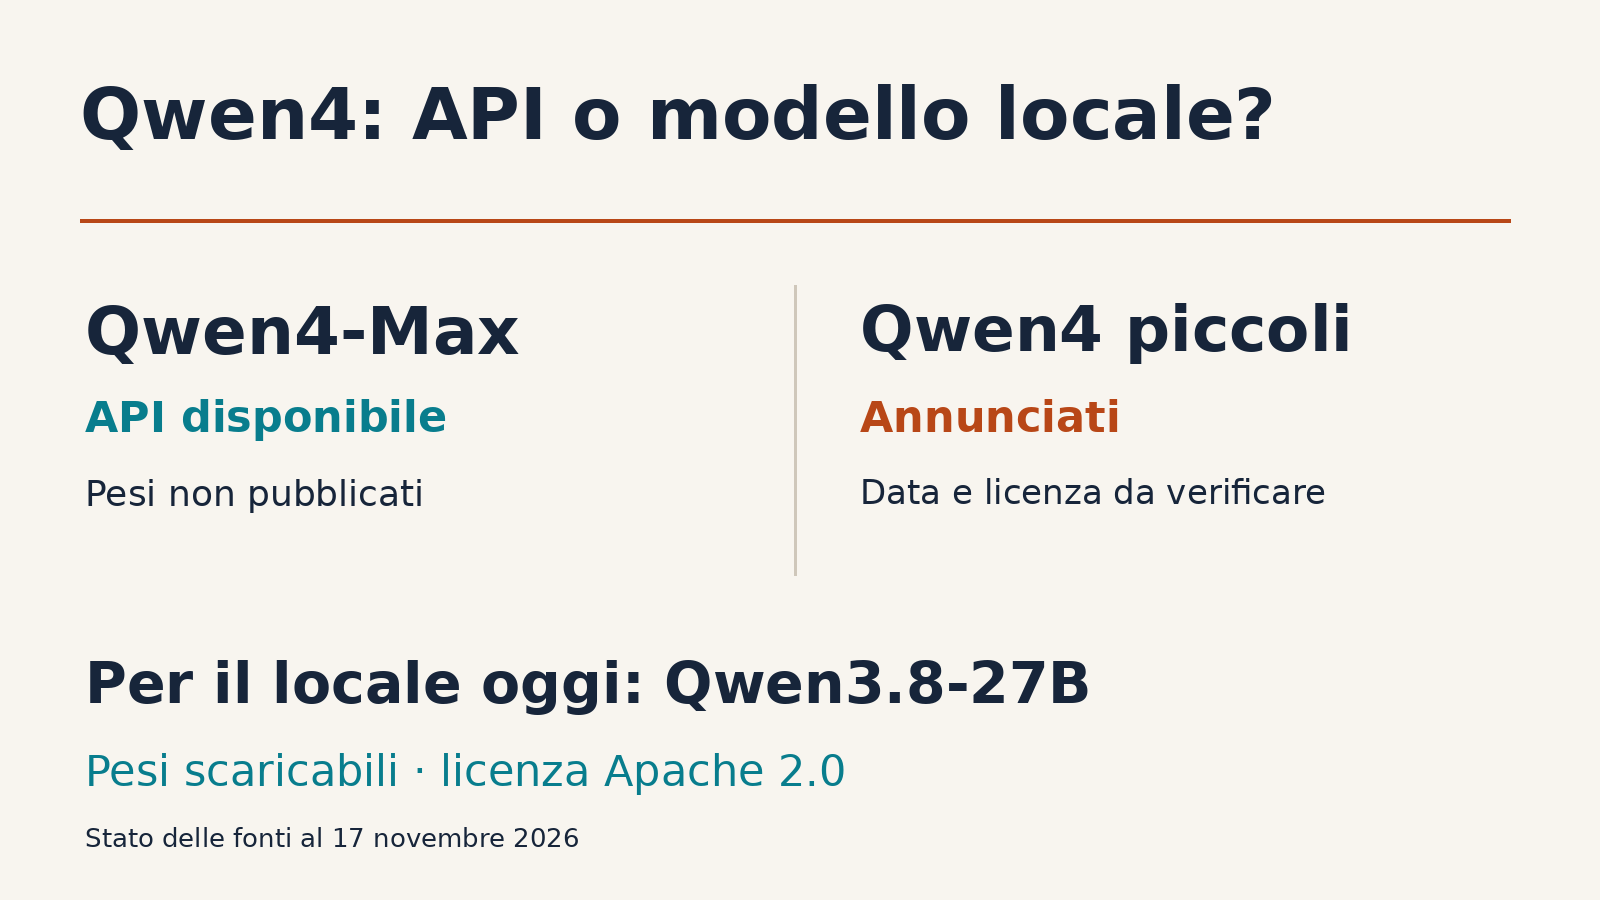
No: al 18 novembre non risultano pesi ufficiali scaricabili di Qwen4-Max. L’annuncio descrive l’accesso tramite QwenCloud, QwenWork, Qoder e QwenStudio. La scheda tecnica non supporta fine-tuning o deployment del modello da parte del cliente.
La promessa sui Qwen4 piccoli è un’altra cosa. Nel post del team Qwen, Max è il primo rilascio della famiglia e i modelli più piccoli sono indicati come successivi modelli aperti. Non è una licenza già pubblicata e non consente di inventare un comando ollama pull per un artefatto non disponibile.
Nella verifica del 18 novembre, la ricerca dei nomi Qwen4 nell’organizzazione ufficiale Qwen su Hugging Face non ha restituito modelli. È una fotografia di quel catalogo, non una prova che non possano arrivare nuovi annunci dopo questa verifica.
Che cosa è già disponibile per lavorare in locale?
Un esempio concreto è Qwen3.8-27B, con pesi pubblicati e licenza Apache 2.0 dichiarata nella model card ufficiale. Non è Qwen4-Max in formato ridotto e non va presentato come equivalente.
Per il percorso operativo trovi la guida a Qwen3.8 27B come agente locale e il quadro su hardware e runtime per modelli AI locali. Verifica formato, quantizzazione e supporto del runtime: la presenza dei pesi non dimostra che il modello completo, la cache e il contesto desiderato stiano nella memoria del tuo computer.
I pesi sono i file dei parametri appresi dal modello. Il codice di un plugin, un’API utilizzabile gratuitamente entro una quota e quei file sono artefatti diversi. Il lancio collega anche il Qwen-Live-Delivery-Plugin: la disponibilità di quel software non rende aperti i pesi di Max.
Che cosa cambia nell’architettura Qwen4?
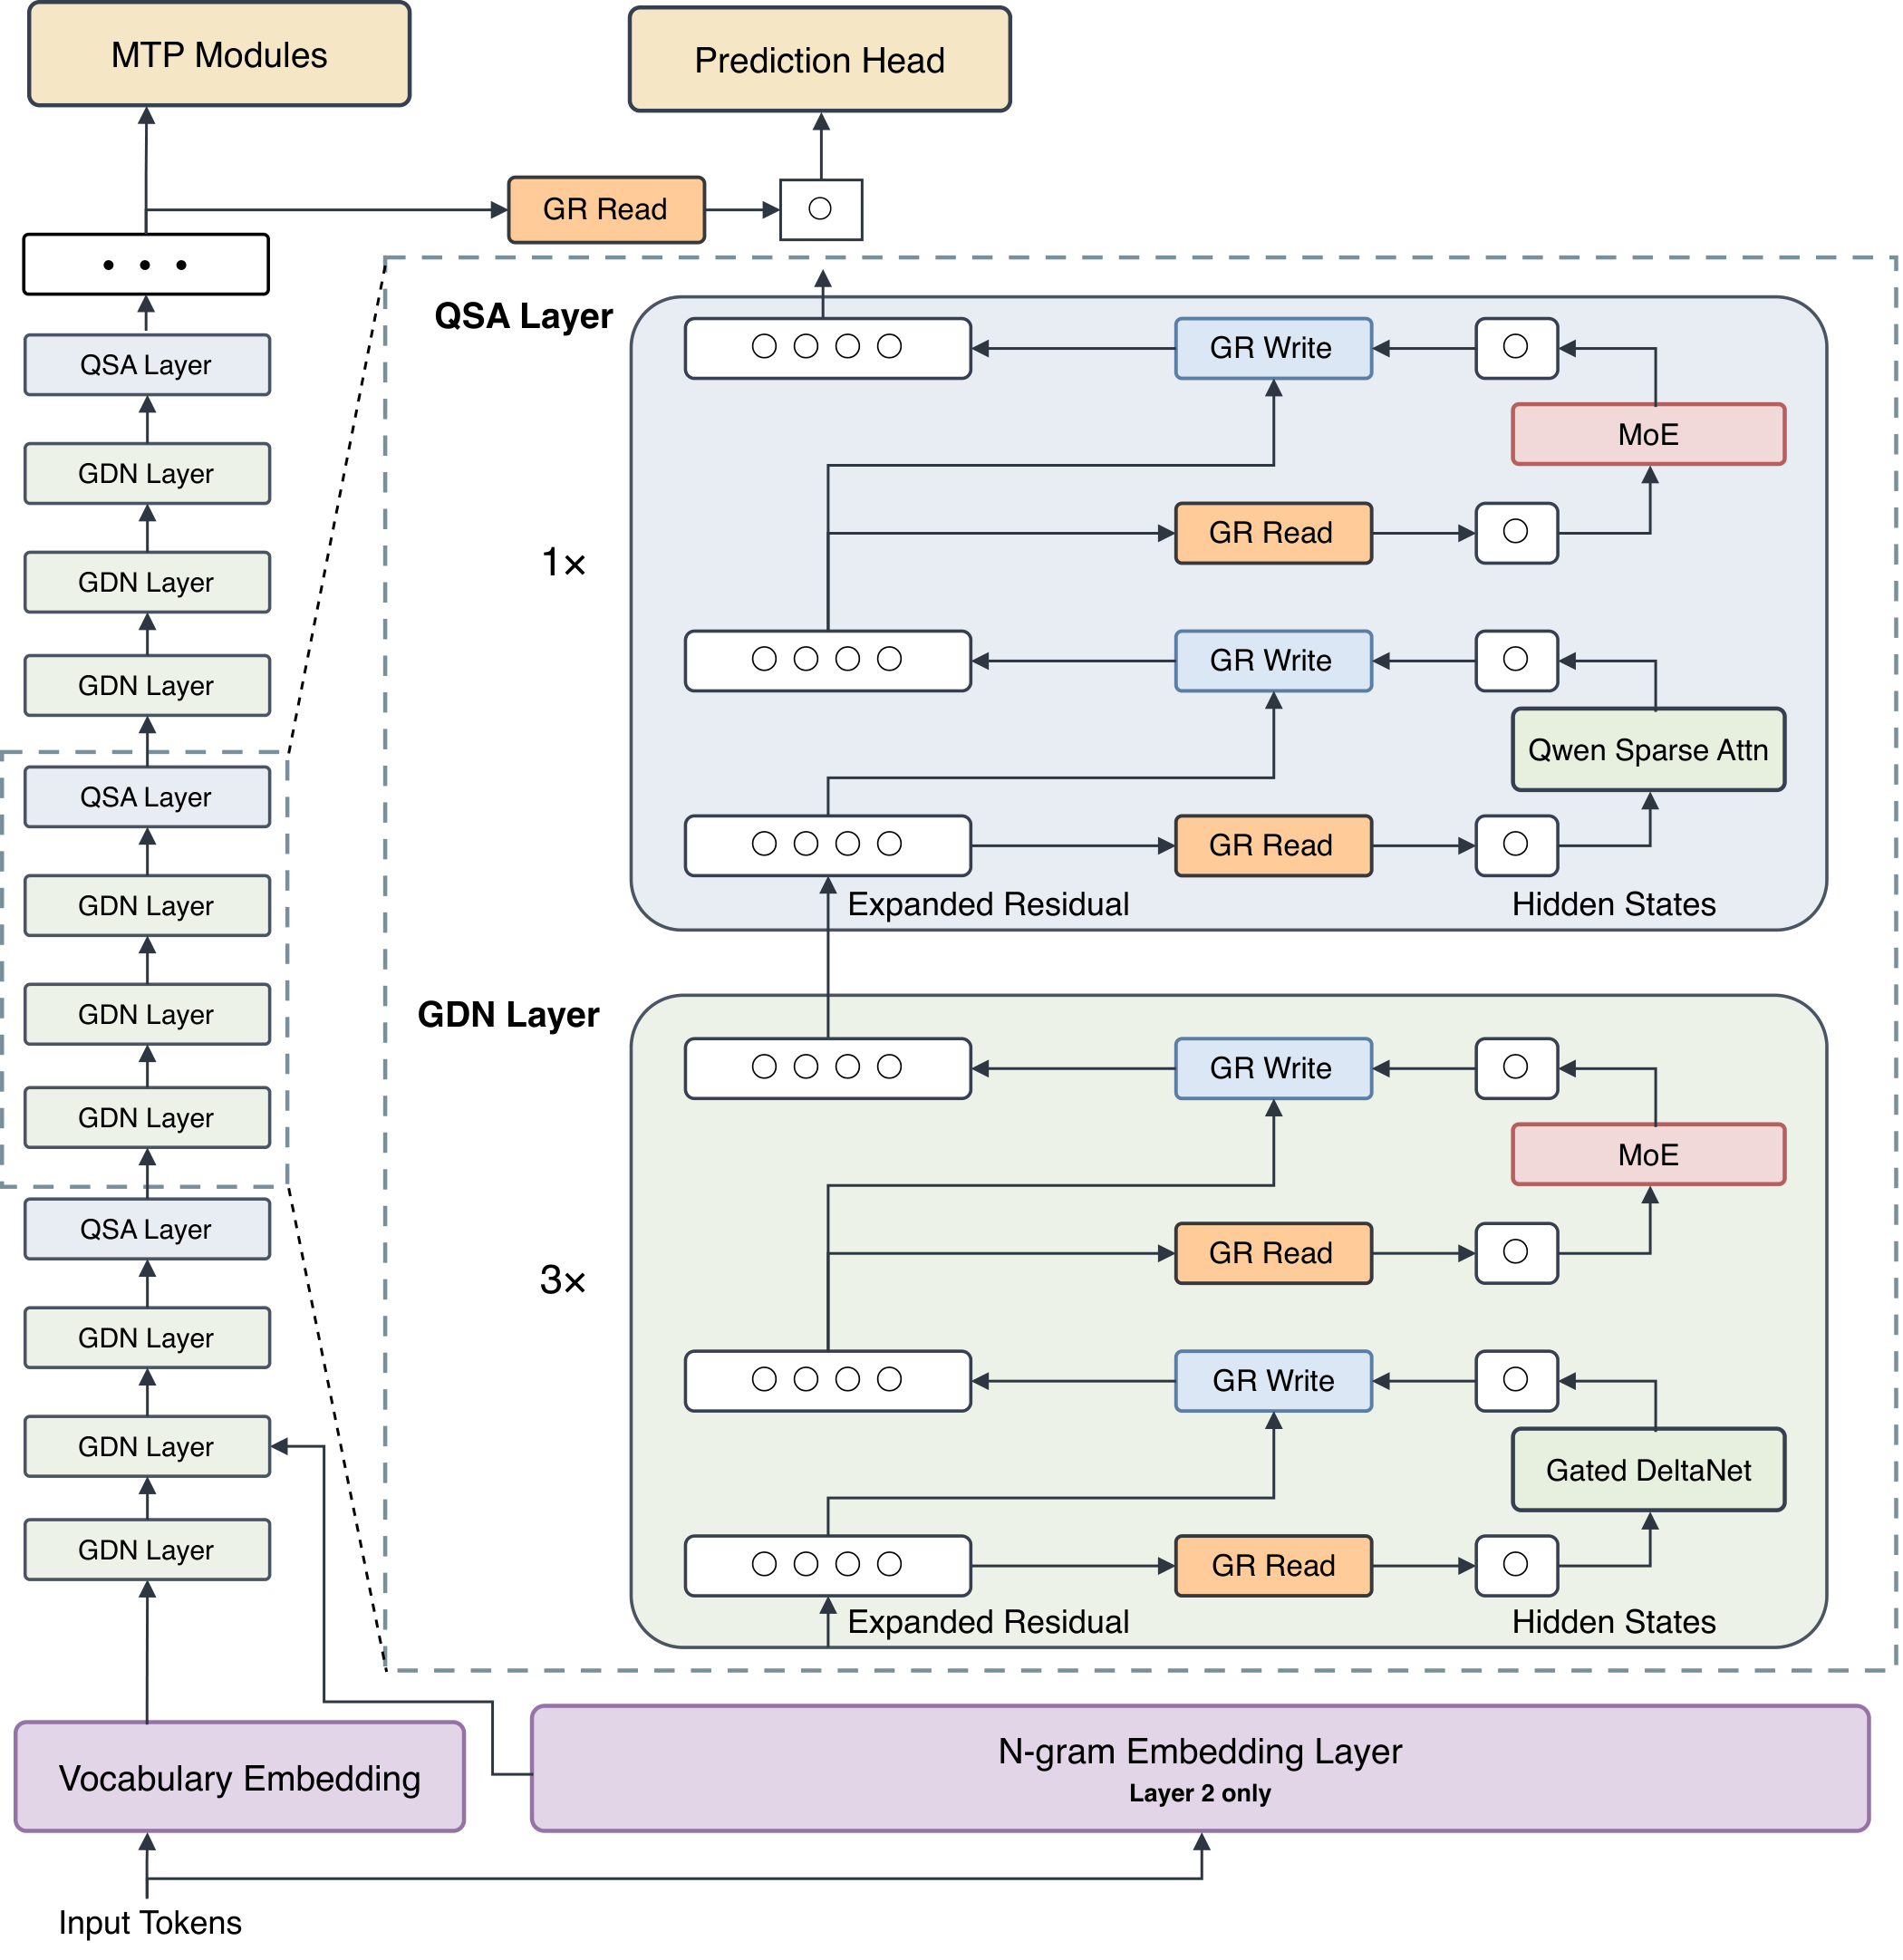
Secondo il team Qwen, il backbone mantiene una scala di 2.400 miliardi di parametri ma ne attiva 71 miliardi per token. È un’architettura Mixture of Experts: una parte degli esperti viene selezionata durante il calcolo, anziché usare ogni parametro allo stesso modo a ogni passaggio.
Il post tecnico descrive tre modifiche: strati Gated DeltaNet affiancati da Qwen Sparse Attention per gestire il contesto; quattro rami residui con porte dinamiche; un N-gram Embedding aggiuntivo da 328 miliardi di parametri.
Per il lettore, la conseguenza da verificare è se il modello mantenga informazioni utili durante un lavoro lungo usando meno risorse. Il numero dei parametri attivi, da solo, non risponde a questa domanda. E non permette di ricavare una quantità di RAM: i pesi non attivati non diventano automaticamente inesistenti.
Che cosa può fare con documenti, immagini e video?
La scheda ufficiale elenca ragionamento, chiamate a strumenti, output strutturati, comprensione di immagini e video e diversi strumenti integrati. L’output nativo è testo: un gioco, un filmato o una presentazione richiedono anche un ambiente di esecuzione, applicazioni e strumenti appropriati.
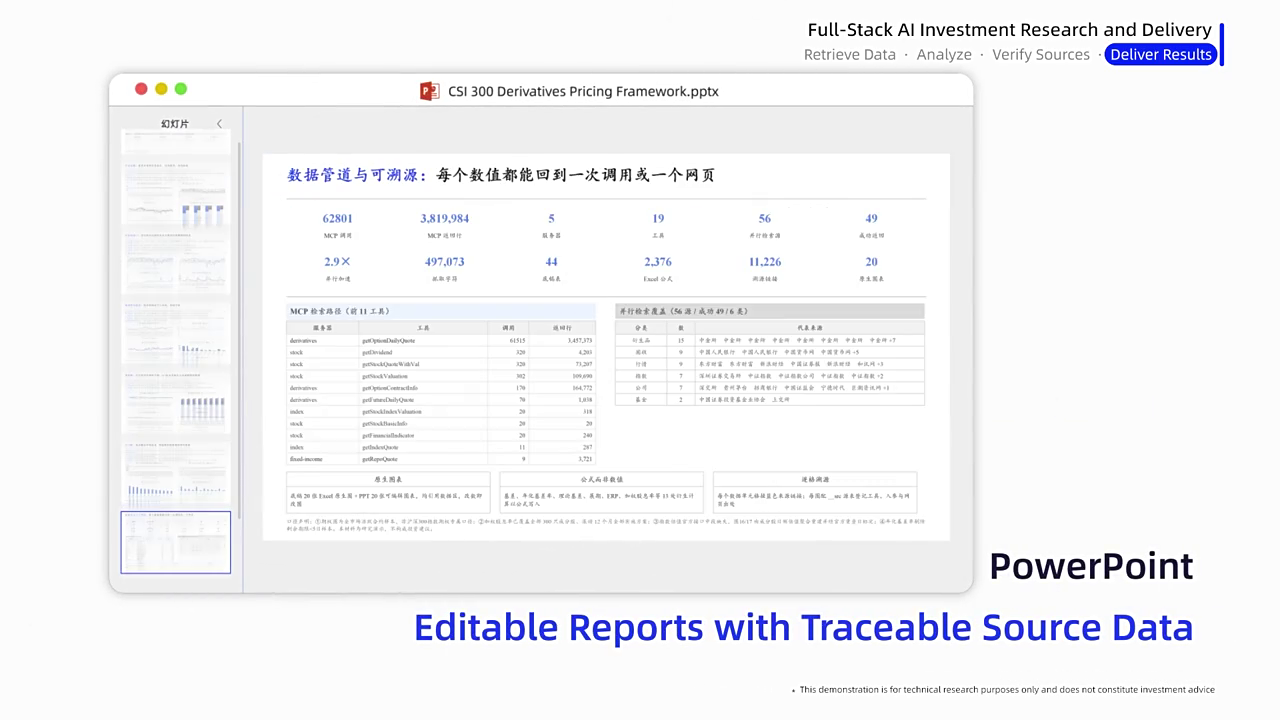
La distinzione è visibile nelle demo del lancio. Qwen mostra, fra gli esempi, sviluppo di giochi con motori reali, modellazione 3D e un flusso finanziario che consegna Excel e presentazioni modificabili. Sono dimostrazioni selezionate dal produttore, non una misura della probabilità di ottenere lo stesso risultato al primo tentativo.
La funzione Live Delivery propone una consegna progressiva: una prima versione utilizzabile, poi revisioni guidate dai risultati e dal feedback dell’utente. È un’idea utile per non scoprire soltanto alla fine che l’agente ha interpretato male il compito. Non sostituisce permessi, verifiche dei file e controllo delle azioni esterne.
Che cosa mostra la demo finanziaria di Qwen?
La dimostrazione ufficiale sulla ricerca finanziaria, lunga circa un minuto, mostra raccolta di dati da più fonti, controlli incrociati e consegna di file Excel e PowerPoint modificabili. È il caso descritto dal produttore, non una prova di rendimento degli investimenti o un test svolto da noi.
Per controllare un risultato simile, non fermarti all’anteprima della presentazione:
- Apri il foglio di calcolo e controlla le formule, non soltanto i totali visualizzati.
- Segui i collegamenti alle fonti e verifica data, unità di misura e periodo del dato.
- Confronta un grafico della presentazione con le celle da cui dovrebbe derivare.
- Chiedi quali dati mancano e quali passaggi non sono stati eseguiti. Non usare la demo come sostituto di una verifica professionale.
Un milione di token non è un milione di token di output
I limiti della documentazione corrente sono distinti:
Contesto
- Finestra nominale
- 1.000.000 token
- Output nativo
- Testo
Senza ragionamento
- Input massimo
- 991.808 token
- Output massimo
- 131.072 token
Con ragionamento
- Input massimo
- 983.616 token
- Pensiero + risposta finale
- Fino a 262.144 token
In modalità ragionamento, il budget complessivo di 262.144 token comprende pensiero e risposta finale: non va promesso come altrettanto testo finale. La documentazione indica un budget di ragionamento predefinito di 131.072 token, con high come sforzo predefinito.
L’affermazione “393.000 token di risposta” che compare in alcuni resoconti non coincide con questi limiti del modello finale. Per integrare il modello userei i limiti della scheda corrente, non una somma fra valori differenti o un dato ripreso dalla preview.
Quanto costa Qwen4-Max? Attenzione alla regione
A Singapore, la pagina commerciale del modello mostra 1,50 $ per milione di token di input, 4,50 $ per l’output e 0,075 $ per letture dalla cache. Il listino dettagliato aggiunge una distinzione importante per chi lavora dall’Italia:
Singapore · International
- Input
- 1,50 $ / milione
- Output
- 4,50 $ / milione
- Lettura cache
- 0,075 $ / milione
Frankfurt · Global
- Input
- 1,413 $ / milione
- Output
- 4,24 $ / milione
- Lettura cache
- 0,071 $ / milione
- Elaborazione soltanto UE
- Non dimostrata da questa offerta
Un token è un’unità di testo elaborata dal modello, non una parola né una pagina. Questi sono prezzi in dollari per milione di token, rilevati il 17 novembre 2026. L’output fatturato comprende il ragionamento secondo le regole del servizio. Costi degli strumenti, imposte e condizioni contrattuali vanno verificati separatamente.
Con 100.000 token di input non in cache e 10.000 token fatturati in uscita, il calcolo è 0,195 $ a Singapore. Applicando le tariffe Frankfurt/Global indicate sopra, diventa 0,1837 $. Sono esempi aritmetici sui listini: non dimostrano quanto consumerà Qwen4-Max per completare il tuo lavoro.
Calcola un esempio sui listini
Inserisci i token e premi Calcola. Nessun dato viene inviato.
Dollari USA, listini del 17 novembre 2026. Stessi token ipotetici, non uguale qualità o consumo reale. Esclusi cache, strumenti, imposte e maggiorazioni regionali. L’output include gli eventuali token di ragionamento fatturati. Senza JavaScript restano validi gli esempi nel testo.
Francoforte non significa automaticamente elaborazione soltanto nell’UE
La guida ufficiale a regioni ed endpoint distingue la regione che riceve la richiesta e conserva i dati dall’ambito in cui avviene l’inferenza.
A Francoforte un workspace può avere ambito Global oppure EU. Global può usare nodi disponibili anche fuori dall’Unione europea, inclusa la Cina continentale. Il workspace predefinito usa Global e l’URL base non cambia fra gli ambiti.
La riga di Qwen4-Max consultata nel listino di Francoforte è Global: non la presenterei come un’offerta di inferenza EU-only. Prima di inviare documenti riservati controlla che quello specifico modello sia disponibile nell’ambito richiesto, oltre a contratto, conservazione, accessi e trattamento dei dati. Un endpoint europeo, da solo, non dimostra che l’intero flusso resti in Europa.
Si può provare gratis?
La scheda ufficiale segnala un milione di token gratuiti per chiamate a consumo a Singapore, distinto dai crediti Token Plan e soggetto a requisiti di idoneità e validità. È una quota condizionata, non una promessa di accesso gratuito illimitato o di inferenza gratuita in ogni regione.
Non è stata verificata qui l’attivazione della quota su un account specifico. Prima di eseguire una prova controlla il credito disponibile in console, il modello e la regione; non dare per scontato che un abbonamento o una promozione valgano anche sull’endpoint che stai usando.
I test indipendenti dicono che è il migliore?
No. Forniscono indicazioni utili, ma circoscritte ai loro metodi.
Il 17 novembre la scheda di Artificial Analysis riporta 43 punti sull’Intelligence Index e 3,27 $ di costo medio per attività dell’indice. La pagina lo classifica come proprietario e riporta un contesto di circa 984.000 token, mentre Qwen indica un contesto nominale di un milione. I valori non vanno arrotondati in una presunta equivalenza fra input utilizzabile e contesto totale.
La prova di Plotly su DataAnalyticsBench è particolarmente istruttiva: Qwen4-Max supera 35 domande su 43, per un costo del loro intero test di 2,29 $. Qwen3.8-27B arriva a 38 su 43, con 1,71 $. Max è più rapido nella mediana per domanda di quella prova, ma non è il più accurato fra i due.
Plotly specifica che si tratta di una sola esecuzione per modello, su dati sintetici e nel proprio ambiente agentico. Segnala inoltre variazioni fino a tre punti nelle ripetizioni di altri modelli: una piccola distanza non diventa una legge generale. Il benchmark è di un’azienda che vende prodotti di analisi dati, non una certificazione universale o un test eseguito sul nostro computer.
E il risparmio di circa il 60% annunciato da Alibaba?
Il team Qwen riporta sul proprio Work360 un costo medio per attività da 4,43 $ a 1,67 $, rispetto a Qwen3.8-Max. Lo stesso post parla di minori consumi con impostazioni di ragionamento specifiche.
È un confronto del produttore sul suo benchmark, non uno sconto garantito sulla tua fattura e nemmeno un confronto diretto con il costo di Plotly. Un modello può avere tariffe basse e fare molte chiamate prima di risolvere un compito. Per scegliere servono qualità e costo dello stesso lavoro completato.
Come collegarlo a un’app senza confonderlo con OpenAI o Claude
QwenCloud documenta compatibilità con Chat Completions, Responses, Anthropic Messages e DashScope. Compatibilità di protocollo non significa che il modello diventi Claude, che usi l’abbonamento OpenAI o che ogni funzione dei client sia identica.
Il percorso è: scegli regione e workspace, crea la relativa chiave, usa l’endpoint corretto e imposta qwen4-max. Le chiavi sono regionali. Token Plan e API a consumo hanno credenziali ed endpoint da distinguere.
Un esempio documentale per Singapore, con l’SDK OpenAI usato soltanto come client, è questo:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
response = client.chat.completions.create(
    model="qwen4-max",
    messages=[{
        "role": "user",
        "content": "Leggi il materiale fornito, elenca i dati mancanti e non inventare risultati."
    }],
    max_completion_tokens=2048,
    extra_body={"enable_thinking": False},
)
print(response.choices[0].message.content)
Questo esempio segue il protocollo documentato, ma non è stato eseguito contro Qwen4-Max in questa analisi. Usa una chiave che hai già configurato nell’ambiente; non inserirla in un repository o in uno screenshot. L’esecuzione può generare consumi. Il kit contiene anche un programma che resta in modalità preparazione finché non aggiungi esplicitamente --execute.
Per i lavori lunghi vanno verificati preservazione del ragionamento, limiti e parametri del protocollo scelto. Non copiare automaticamente la configurazione di un altro provider.
Come confrontarlo con un modello aperto sul tuo lavoro
La domanda utile è se il cloud migliori abbastanza il risultato da giustificare costo, trasferimento dei dati e dipendenza dal servizio. Non basta contrapporre “nuovo e grande” a “vecchio e piccolo”.
Nel kit trovi un CSV dimostrativo con un duplicato e un valore mancante, un prompt e un risultato atteso calcolato localmente. Puoi usare lo stesso materiale con Qwen4-Max e con un modello locale già funzionante. Il test controlla soprattutto se l’agente riconosce quando non può fornire un totale definitivo.
Il protocollo è pronto, ma il confronto fra modelli resta da eseguire. Annota versione esatta, runtime o provider, contesto, impostazioni, tempi, token fatturati e correzioni necessarie. Un esito ottenuto sul modello locale non va attribuito a Max, e viceversa.
Quando lo proverei e quando aspetterei
Proverei Qwen4-Max su un ambiente di sviluppo isolato per documenti multimodali o flussi lunghi, se la collocazione dei dati e il modello di costo sono accettabili. Prima di migrare un’app farei passare gli stessi casi difficili al sistema attuale e a quello nuovo.
Se servono pesi scaricabili, esecuzione offline o controllo diretto del runtime, sceglierei fra i modelli già pubblicati invece di pianificare un rilascio Qwen4 non datato. Se servono fine-tuning o Batch, la scheda tecnica corrente di Max li indica come non supportati, anche se la pagina commerciale mostra sezioni generiche su queste funzioni.
La decisione, oggi, è fra un servizio Qwen4-Max disponibile e modelli aperti concretamente scaricabili. I futuri Qwen4 piccoli saranno un nuovo confronto quando avremo file, licenza e supporto verificabili.
Se stai confrontando servizi cloud per documenti e codice, trovi anche la guida a GPT-6.2 Astra e Sol: disponibilità, costi e limiti. Per l’esecuzione offline, invece, resta pertinente il percorso sui pesi e sui runtime locali citato sopra.
Domande frequenti
Qwen4-Max è open source?
No: al 17 novembre 2026 Max è un servizio cloud senza pesi ufficiali scaricabili. I Qwen4 più piccoli sono annunciati separatamente; disponibilità e licenza andranno verificate al rilascio.
Posso scaricare Qwen4-Max con Ollama?
Non esiste un download ufficiale dei pesi di Max verificato in questa analisi. Non confondere i modelli Qwen già pubblicati, come Qwen3.8-27B, con il nuovo servizio Qwen4-Max.
Qwen4-Max genera direttamente video?
La scheda indica testo, immagini e video in ingresso, ma testo in uscita. Le dimostrazioni che producono giochi, presentazioni o scene 3D includono anche strumenti e un ambiente di esecuzione.
Qwen4-Max si può provare gratuitamente?
La documentazione indica una quota condizionata di un milione di token per API a consumo a Singapore. Requisiti, validità e credito del proprio account vanno controllati prima dell’uso; non è accesso gratuito illimitato.
L’endpoint di Francoforte garantisce inferenza soltanto UE?
No. Regione dell’endpoint e ambito di inferenza sono distinti. La riga di Qwen4-Max verificata nel listino di Francoforte usa Global, che può elaborare anche fuori dall’UE.
Fonti e riferimenti
Documentazione, dichiarazioni del produttore e valutazioni esterne sono tenute separate. Fonti consultate il 17 novembre 2026; i riferimenti puntuali sono accanto a prezzi e affermazioni nel testo.
Team Qwen: lancio e architettura
Max disponibile come servizio; modelli aperti più piccoli annunciati.
Apri fonteQwenCloud: limiti e API del modello
Input, output, protocolli, modalità di ragionamento e funzioni supportate.
Apri fontePlotly: DataAnalyticsBench
Una prova di analisi dati con costi, risultati e limiti dichiarati.
Apri fonteAggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.