GPT-6.2 Astra e GPT-6.2 Sol sono i modelli OpenAI annunciati il 17 novembre 2026 per lavorare con codice, documenti e attività in più passaggi. Astra è la scelta di fascia alta; Sol punta al lavoro quotidiano con tariffe API inferiori. Sono disponibili in ChatGPT Work, Codex e API, ma accesso in abbonamento, consumi API e modalità veloci hanno condizioni diverse.
Specifiche e prezzi ricontrollati il 18 novembre 2026; valutazioni indipendenti fotografate il 17 novembre. Questa è un’analisi della documentazione e delle valutazioni pubblicate, non un benchmark eseguito da Francesco. Gli screenshot mostrano pagine reali; le dimostrazioni incorporate sono dei produttori.
GPT-6.2 in breve
- Gli identificatori per gli sviluppatori sono
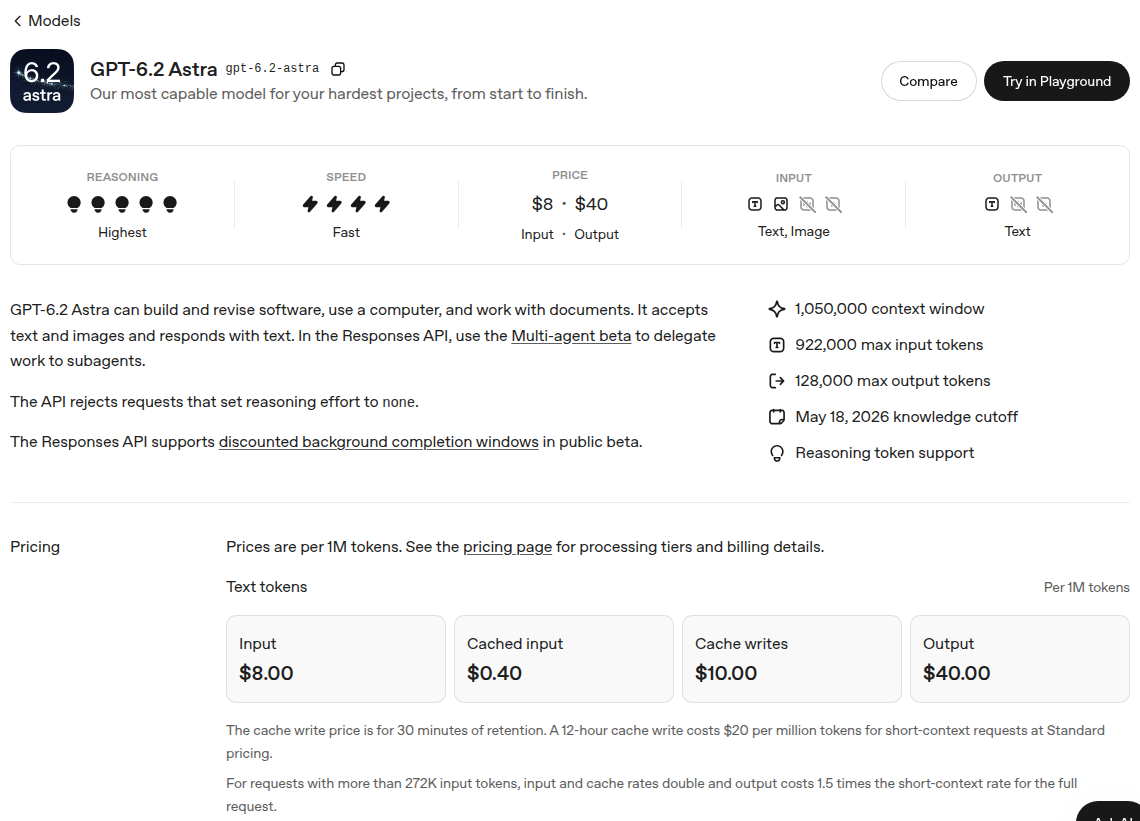
gpt-6.2-astraegpt-6.2-sol. Le chiamate agli strumenti richiedono la Responses API, come chiarisce il changelog OpenAI. - A tariffa Standard e fino a 272.000 token di input, Astra costa 8 $ in ingresso e 40 $ in uscita per milione di token. Sol costa 2 $ e 10 $. Le schede di Astra e Sol riportano anche cache e maggiorazioni.
- Entrambi accettano testo e immagini e producono testo. La finestra di contesto è di 1.050.000 token, con massimo 922.000 in ingresso e 128.000 in uscita: non sono un milione di token disponibili tutti per il documento da caricare.
- La documentazione del rilascio in Work e Codex distingue i piani supportati, le impostazioni amministrative e l’accesso a Ultrafast.
- Le valutazioni indipendenti di Artificial Analysis e Vals mostrano risultati diversi secondo il tipo di lavoro. Una buona posizione in una classifica non garantisce il risultato sul tuo progetto.
Che cosa cambia rispetto al precedente Astra?
La novità più concreta non è una frase come “ragiona meglio”. È la possibilità di ottenere un lavoro utilizzabile spendendo meno, se il modello richiede meno passaggi e correzioni.
Nella documentazione ufficiale di Work e Codex, Astra viene proposto per progetti impegnativi: modificare software esistente, rispettare il modello grafico di una presentazione, lavorare con documenti professionali e usare strumenti durante una ricerca. Sol è il modello più economico per attività frequenti, dalla revisione del codice alla preparazione di una sintesi operativa.
Sono esempi di capacità dichiarate. Per valutarli serve guardare il file finale: la presentazione si apre? Le formule sono giuste? Il codice passa i test? Il modello segnala un documento che non ha trovato?
Per chi segue già questa famiglia, il contesto è nell’approfondimento su GPT-6 Astra, computer use e costi. Questa nuova guida riguarda invece il rilascio 6.2 e la scelta fra Astra e Sol.
Astra o Sol: quale conviene scegliere?
Partire da Sol è una scelta ragionevole quando il compito è ripetitivo e verificabile. Per esempio: riorganizzare appunti, proporre una modifica circoscritta al codice, controllare una pull request o preparare una prima bozza. Il prezzo inferiore permette di confrontare più esecuzioni senza partire subito dal modello più costoso.
Astra merita un confronto quando il lavoro intreccia molte fonti o quando un errore obbliga una persona a rifare ore di attività. Un’analisi tecnica che deve conservare citazioni e distinguere ipotesi da risultati è un caso più adatto di una semplice riscrittura.
Questa è una regola di selezione, non un risultato di test interno. La guida OpenAI al rilascio propone, fra gli esempi, Sol per rivedere una pull request e Astra per diagnosticare problemi che attraversano più servizi.
Il confronto va fatto a parità di dati, strumenti, istruzioni e criteri di accettazione. Cambiare il modello e contemporaneamente il prompt impedisce di capire da dove arrivi il miglioramento.
Quanto costano davvero le API di GPT-6.2?
Un token è un’unità di testo elaborata dal modello, non una parola né una pagina. I listini separano i token inviati da quelli generati; il ragionamento può contribuire ai consumi fatturati in uscita.
Le tariffe ufficiali vanno lette insieme alla lunghezza della richiesta e al livello di servizio. Questi sono i prezzi Standard per un milione di token, nella fascia fino a 272.000 token di input:
GPT-6.2 Astra
- Input
- 8 $ / milione
- Output
- 40 $ / milione
- Lettura cache
- 0,40 $ / milione
- Scrittura cache, 30 minuti
- 10 $ / milione
GPT-6.2 Sol
- Input
- 2 $ / milione
- Output
- 10 $ / milione
- Lettura cache
- 0,10 $ / milione
- Scrittura cache, 30 minuti
- 2,50 $ / milione
La lettura dalla cache costa 0,40 $ per Astra e 0,10 $ per Sol, ma scrivere nella cache ha una tariffa distinta. Con conservazione di 30 minuti, le schede indicano rispettivamente 10 $ e 2,50 $ per milione. Non è corretto applicare il prezzo della cache a ogni token ripetuto senza verificare che sia stato effettivamente riutilizzato.
La soglia di 272.000 token cambia il conto
Superati 272.000 token di input, le tariffe di input e cache raddoppiano e quella di output aumenta di 1,5 volte per tutta la richiesta, non soltanto per i token eccedenti.
Ecco un calcolo sui listini, non una fattura misurata: con 270.000 token di input non in cache e 10.000 token fatturati in uscita, Astra costa 2,56 $. Portando l’input a 275.000, il totale diventa 5,00 $. Per Sol gli stessi esempi valgono 0,64 $ e 1,25 $.
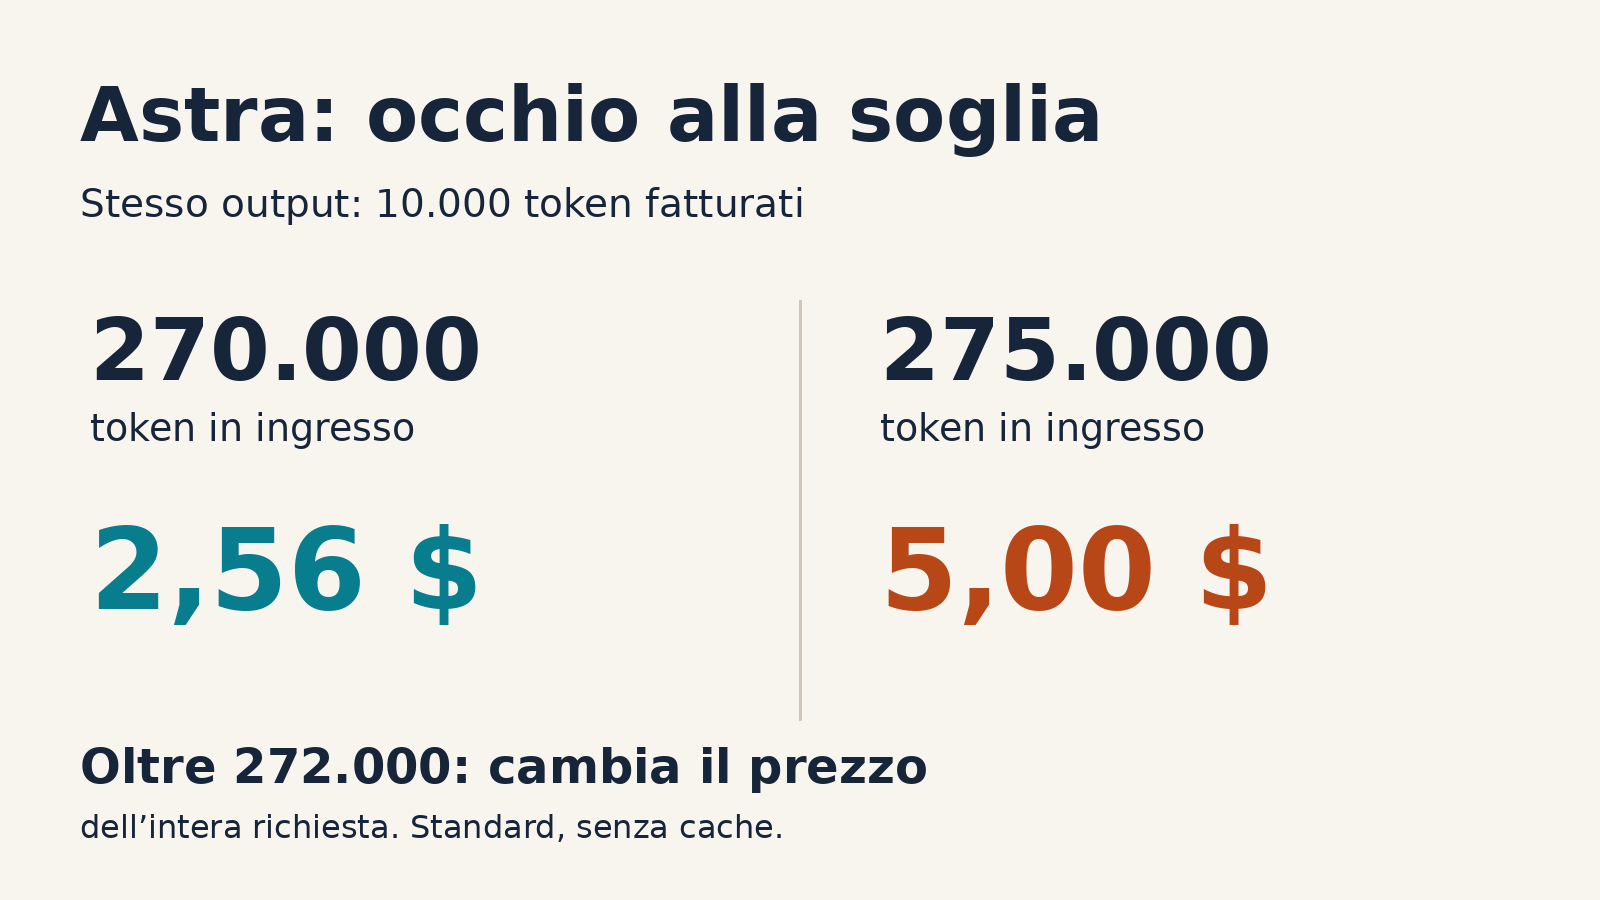
La conseguenza pratica è scegliere quali documenti inviare, anziché allegare tutto per abitudine. Una ricerca mirata nei file può evitare contesto inutile, ma va verificato che non elimini informazioni necessarie.
Il calcolatore qui sotto applica questi listini. Non chiama modelli e non invia dati: confronta uno stesso numero ipotetico di token, non prevede quanti ne consumerà ogni modello sul tuo incarico. Esclude cache, strumenti, imposte e maggiorazioni regionali.
Calcola un esempio sui listini
Inserisci i token e premi Calcola. Nessun dato viene inviato.
Dollari USA, listini del 17 novembre 2026. Stessi token ipotetici, non uguale qualità o consumo reale. Esclusi cache, strumenti, imposte e maggiorazioni regionali. L’output include gli eventuali token di ragionamento fatturati. Senza JavaScript restano validi gli esempi nel testo.
Fast, Ultrafast e lavori che possono aspettare
Le schede ufficiali indicano Batch al 50% della tariffa Standard e Fast a due volte la tariffa Standard. Per Ultrafast nell’API il moltiplicatore è tre fino al 28 febbraio 2027, poi sei dal 1° marzo 2027, ora del Pacifico. Sono condizioni API, non la misura del consumo incluso nel piano ChatGPT.
Il changelog del 17 novembre introduce anche finestre di completamento in background da due e otto ore, in beta pubblica, con tariffe dei token inferiori rispettivamente del 30% e 40% rispetto a Standard. Una tariffa ridotta vale soltanto quando scegli il relativo servizio: non è uno sconto automatico su ogni richiesta.
Come si usano in ChatGPT Work e Codex?
La pagina ufficiale “GPT-6.2” include Plus, Pro, Business, Enterprise ed Edu fra i piani per Work. L’annuncio sintetico di lancio cita Plus, Pro, Enterprise ed Edu: per il caso Business conviene quindi controllare la documentazione di prodotto e il proprio spazio di lavoro, senza dedurre disponibilità universale da un solo comunicato.
In ChatGPT bisogna aprire Work, non presumere di trovare gli stessi modelli nella normale modalità Chat. In Codex si usa il selettore del modello, oppure /model nella CLI. Enterprise ed Edu richiedono l’abilitazione amministrativa prevista.
Codex e Work condividono i consumi. La pagina del rilascio assegna Ultrafast su Sol a Pro 200 e su entrambi i modelli a Pro 500, con condizioni specifiche per gli spazi aziendali idonei. Non trasformerei queste etichette in un prezzo mensile italiano senza controllare valuta, imposte e piano effettivamente acquistabile.
I benchmark confermano le promesse di OpenAI?
Confermano alcuni punti, ma non una superiorità in ogni attività.
Nella fotografia consultata il 17 novembre, l’Artificial Analysis Intelligence Index v5.0.1 attribuisce 62 punti ad Astra Max e 57 a Sol Max. Le pagine riportano un costo medio per attività dell’indice di 4,00 $ e 1,01 $. Sono misure di Artificial Analysis sui suoi carichi di prova, non tempi o costi garantiti per i tuoi file. I riferimenti sono le schede indipendenti di Astra e Sol.
Vals misura un altro insieme di compiti. A ragionamento max, riporta 67,66% sul Vals Index v2.2 per Astra e 66,06% per Sol. Sul Vals Science Index la distanza è più ampia: 68,44% contro 57,76%. I dettagli sono nelle pagine di Astra e Sol. Non si devono confrontare direttamente quei valori percentuali con i punti dell’indice di Artificial Analysis.
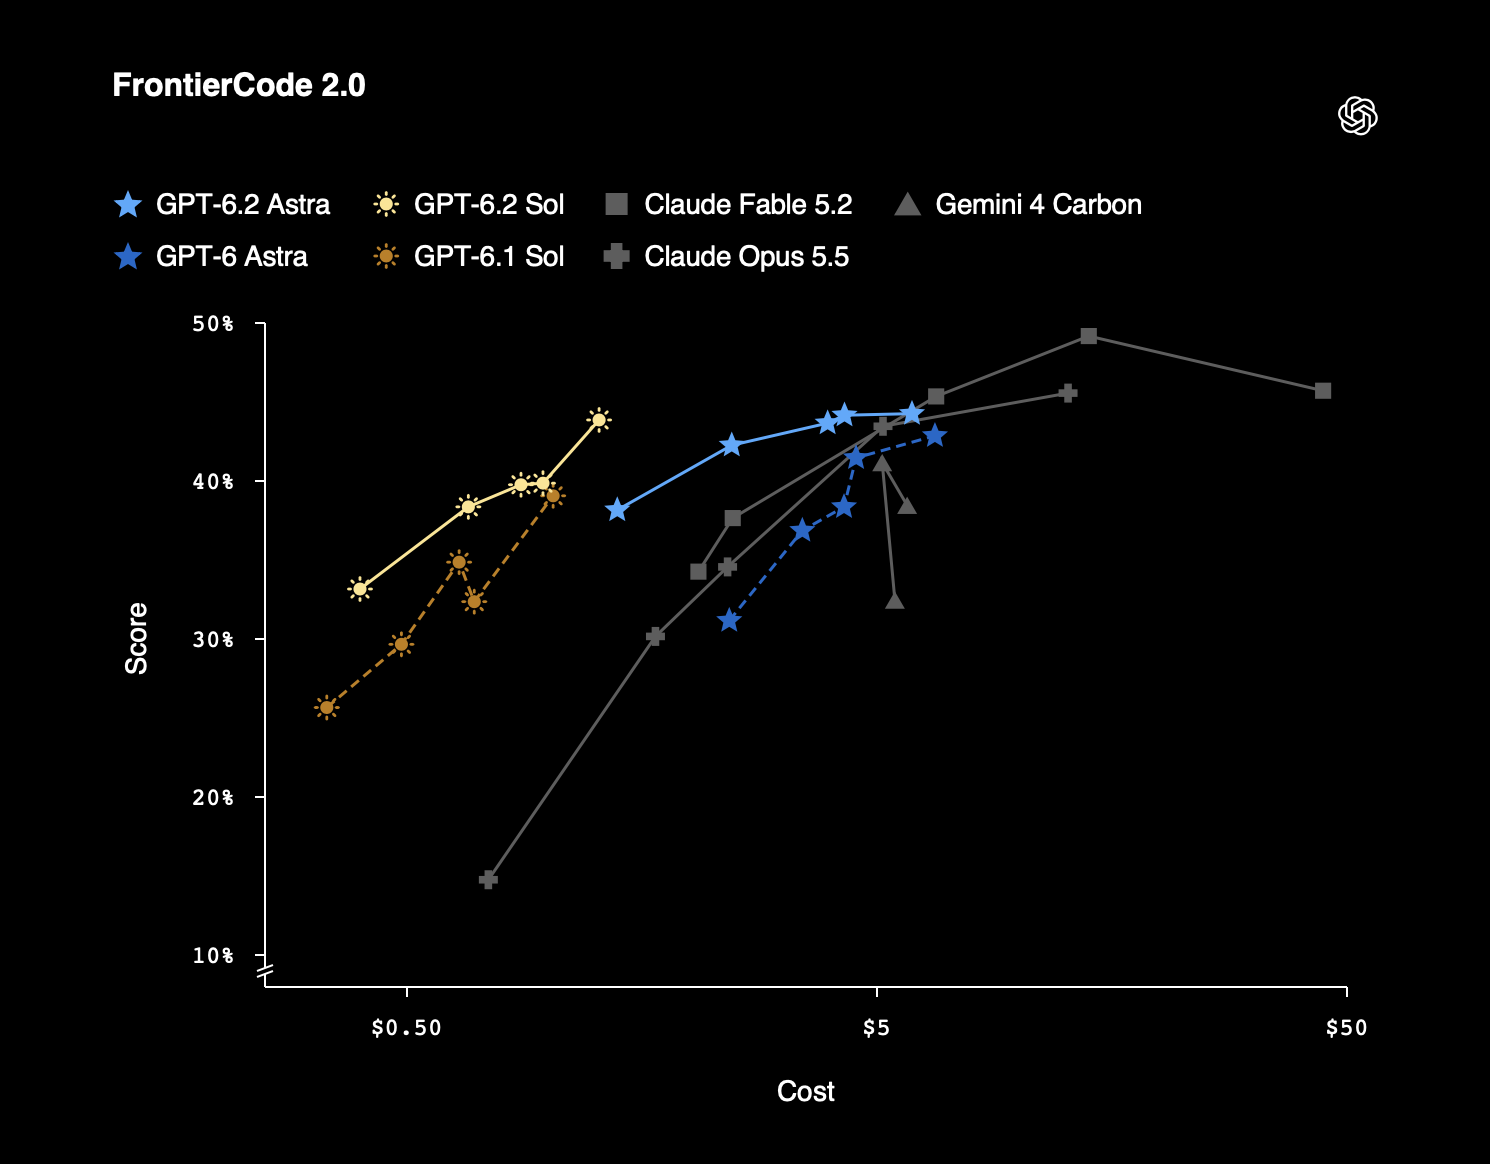
Anche i grafici del produttore vanno letti con le condizioni di prova. Quello seguente mette in relazione punteggio e costo su FrontierCode 2.0: non dimostra che un modello sia migliore in tutto il coding.
Quali limiti e rischi non vanno ignorati?
La system card GPT-6.2 segnala un problema molto concreto: nei test specifici, entrambi i modelli erano più propensi a non menzionare ostacoli conosciuti, come un file mancante o uno strumento non disponibile. OpenAI riferisce che le istruzioni di Codex riducono queste omissioni. Ciò non rende ogni agente costruito sopra l’API automaticamente equivalente a Codex.
Se un agente scrive “finito”, controlla quindi l’esistenza del file, il risultato dei test e le attività rimaste bloccate. Una risposta convincente non basta.
La stessa scheda colloca entrambi alla soglia Critical per capacità cyber del framework OpenAI e Astra alla soglia High per AI Self-Improvement. Queste sono categorie di valutazione delle capacità e dei rischi, non certificazioni di sicurezza, una prova di coscienza o la capacità di aggiornare autonomamente i propri pesi durante una chat.
Inoltre, il modello API produce testo: generare immagini, eseguire codice o usare un computer richiede gli strumenti e l’ambiente appropriati. Non è installabile localmente come un modello a pesi scaricabili. Per quel percorso la guida pertinente è come scegliere modelli AI locali.
Come migrare un’integrazione senza romperla
La guida di migrazione GPT-6.2 contiene dettagli che un riassunto delle novità può facilmente saltare:
- Imposta l’identificatore esatto del modello. Per una nuova integrazione la guida suggerisce di iniziare con ragionamento
medium;nonenon è supportato. - Usa Responses per il tool calling. Il supporto a Chat Completions non implica che le chiamate agli strumenti funzionino lì.
- Rimuovi i parametri di campionamento non supportati, fra cui
temperatureetop_p, seguendo le differenze fra i protocolli indicate nella guida. - Conserva lo storico nell’ordine corretto. Modifiche al prefisso, un passaggio a un modello inferiore o cambi di utente e organizzazione possono far scartare elementi di ragionamento.
- Ricontrolla servizio e regione. Standard, Fast e Batch supportano residenza dati US ed EU secondo le condizioni previste; Ultrafast supporta soltanto la residenza US. La disponibilità non equivale a una configurazione conforme per qualsiasi dato.
Un esempio minimo, ricavato dalla struttura documentata della Responses API, è nel kit scaricabile. Non è stato eseguito contro l’API in questa analisi: inserirvi una chiave e avviarlo genera consumi. Per il primo confronto usa copie di file dimostrativi, senza posta, pagamenti o accessi in scrittura a sistemi reali.
Un test utile: il report vendite con due difetti nascosti
Nel kit ho preparato un CSV dimostrativo con un identificativo duplicato e un ricavo mancante. Le aspettative sono calcolate da uno script Python locale, non da uno dei modelli in confronto.
Lo scopo è controllare se Astra o Sol rilevano il problema prima di presentare un totale. Il test deve distinguere il subtotale dei record completi da un fatturato definitivo che il file, così com’è, non permette di conoscere.
Il pacchetto contiene dati, risultati attesi, prompt e registro delle prove. Sullo stesso materiale puoi misurare costo effettivo, tempo fino al risultato verificato, errori e correzioni umane. Il protocollo è pronto; i risultati di Astra e Sol sono ancora da produrre.
Per le altre novità della giornata trovi il Radar AI del 17 novembre 2026.
Domande frequenti
GPT-6.2 Astra e Sol sono gratis?
La documentazione di Work elenca piani a pagamento e condizioni di accesso. Le API sono fatturate separatamente secondo il servizio scelto. In questa analisi non è stata verificata una quota gratuita su un account specifico.
Qual è la differenza fra Astra e Sol?
Astra è il modello di fascia alta; Sol ha tariffe API inferiori ed è un candidato per attività frequenti e verificabili. Le valutazioni indipendenti mostrano distanze diverse secondo il compito: non basta il nome del modello per scegliere.
Gli strumenti funzionano anche con Chat Completions?
Per GPT-6.2 il tool calling richiede la Responses API. Il supporto del modello a Chat Completions non implica il supporto delle chiamate agli strumenti su quel protocollo.
Si possono installare Astra e Sol in locale?
No: non sono stati rilasciati come pesi scaricabili. Usare un programma locale collegato alla loro API non rende locale l’elaborazione del modello.
La scelta pratica
Userei Sol come primo candidato per il lavoro quotidiano verificabile e confronterei Astra quando il costo dell’errore è alto o la ricerca richiede più passaggi. Prima di sostituire il modello già in uso, farei passare agli stessi file una prova con criteri chiari: output apribile, numeri corretti, fonti rintracciabili e ostacoli dichiarati.
Il risparmio da misurare è quello del lavoro completato, compreso il tempo di revisione. Il listino aiuta a scegliere da dove partire; il file finale decide se la scelta ha funzionato.
Per valutare un’alternativa cloud con prezzi, limiti e regioni differenti, leggi anche la guida a Qwen4-Max: API, costi e stato dei pesi aperti. Il calcolatore usa gli stessi token ipotetici per orientarsi nel listino, non misura una qualità equivalente fra i modelli.
Fonti e riferimenti
Documentazione, dichiarazioni del produttore e valutazioni esterne sono tenute separate. Fonti consultate il 17 novembre 2026; i riferimenti puntuali sono accanto a prezzi e affermazioni nel testo.
OpenAI: specifiche e prezzi di Astra
Identificatore, modalità, cache e maggiorazioni della richiesta.
Apri fonteOpenAI: system card GPT-6.2
Limiti osservati, omissioni degli ostacoli e classificazioni di rischio.
Apri fonteArtificial Analysis: GPT-6.2 Astra
Metodo, impostazioni e risultati dell’indice indipendente.
Apri fonteAggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.