
L’ANALISI
Qwen4-Max: API e differenze dalla preview
Qwen4-Max documenta un milione di token di contesto e accesso API pay-as-you-go: identificatore, endpoint e limiti restano distinti dalla preview.
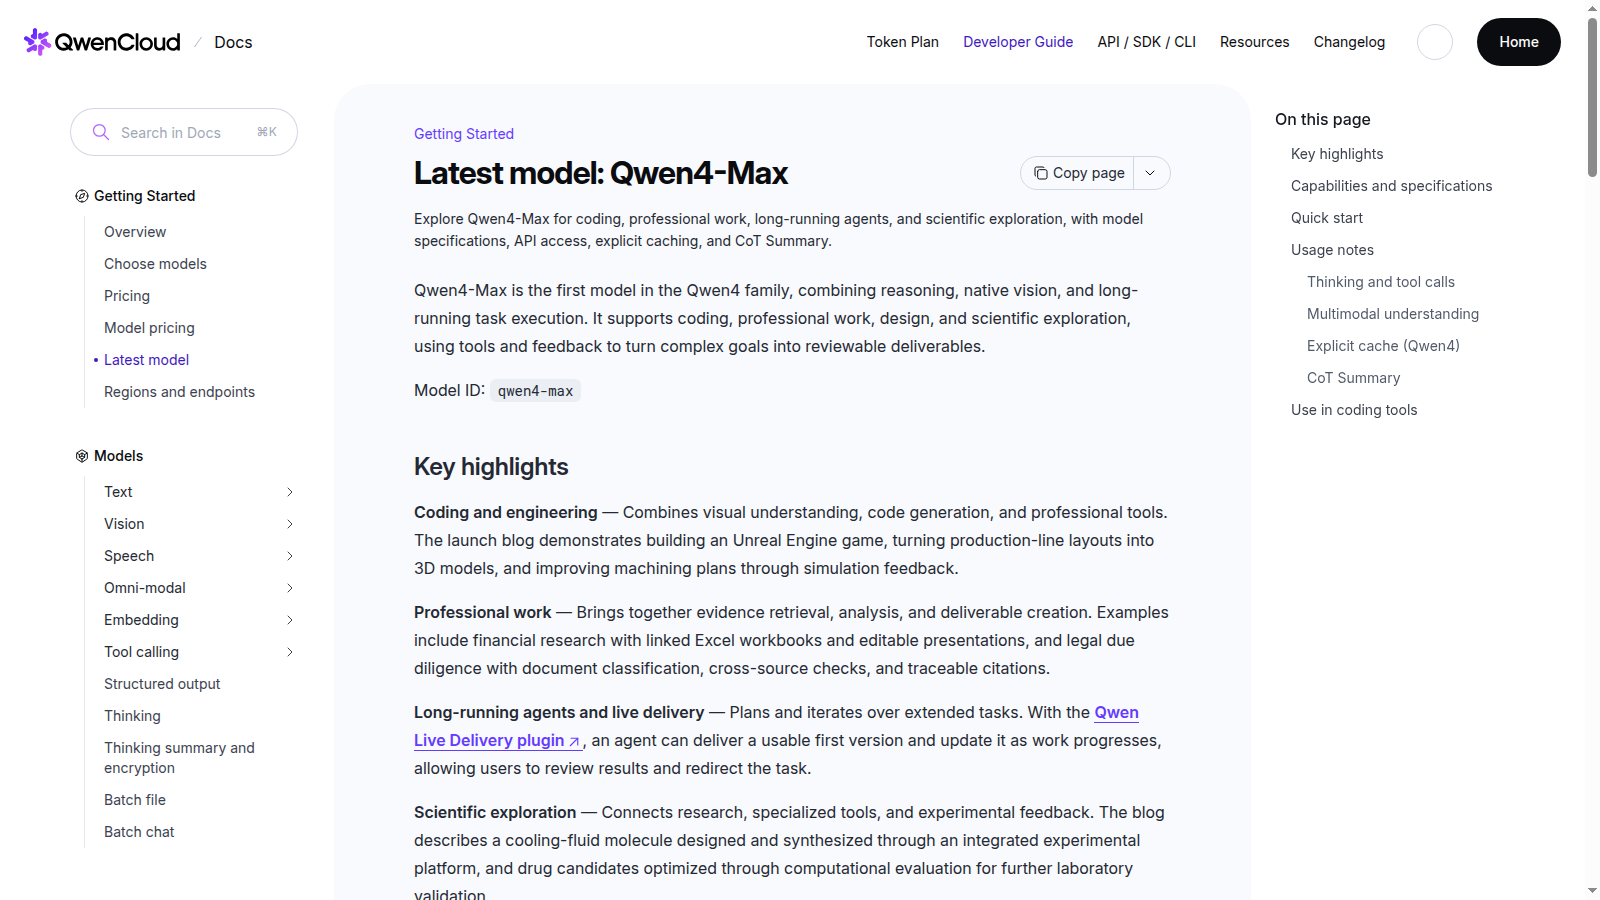
In breve: Qwen4-Max è il modello API identificato da qwen4-max, distinto da qwen4-max-preview. Il changelog lo data al 16 novembre 2026; la guida documenta un milione di token di contesto, strumenti e output strutturati. Prima di integrarlo occorre controllare piano, chiave, endpoint e regione: la presenza nella documentazione non prova l’abilitazione del proprio account. QwenCloud: rilasci del 16 e dell’11 novembre.
Verifica documentale del 16 novembre 2026 sul changelog e sulla guida ufficiale QwenCloud. Nessuna richiesta di inferenza, verifica di account, prova di qualità o misura di costo eseguita. Il changelog fornisce il giorno, non l’orario o il fuso del rilascio.
Che cosa cambia rispetto alla preview?
Il changelog separa due voci: qwen4-max-preview l’11 novembre e qwen4-max il 16 novembre. La voce della preview parla di accesso tramite Token Plan; la guida corrente del modello nuovo descrive anche API pay-as-you-go e distingue esplicitamente i benefici della preview. Non basta quindi riconoscere il nome commerciale Qwen4: una configurazione che usa l’identificatore precedente non dimostra che stia interrogando il modello nuovo. Per una migrazione controllata conviene conservare la configurazione precedente e verificare quale identificatore restituisce il servizio.
QwenCloud: rilasci del 16 e dell’11 novembre · Qwen4-Max: specifiche, API e percorsi di accesso.
Quali limiti documenta il modello API?
La guida indica un milione di token di contesto e un massimo di 131.072 token in uscita senza thinking. In modalità thinking il limite complessivo di ragionamento e risposta arriva a 262.144 token. Sono limiti distinti, non un’unica quantità di testo liberamente intercambiabile. Sono documentati comprensione di immagini e video, function calling e output strutturati. La stessa pagina esclude batch inference, fine-tuning e model deployment. Non presenta quindi un percorso per scaricare questi pesi ed eseguirli su un proprio server.
Qwen4-Max: specifiche, API e percorsi di accesso.
Perché piano, chiave ed endpoint vanno separati?
QwenCloud distingue Token Plan Personal, Token Plan Team e API pay-as-you-go. La guida invita a usare credenziali ed endpoint corrispondenti al percorso scelto e documenta disponibilità regionale. L’esempio Chat Completions usa un endpoint regionale compatibile OpenAI; non va copiato come se fosse valido per ogni piano o ogni requisito di residenza dei dati. La compatibilità del protocollo non prova l’accesso a tutte le funzioni. Prima di inviare documenti reali occorre leggere prezzi, quote e condizioni del proprio account: qui non vengono attribuiti prezzi o gratuità illimitata al modello.
Qwen4-Max: specifiche, API e percorsi di accesso.
Come impostare una prima verifica controllata?
Il protocollo proposto parte da un testo sintetico non riservato, un limite di output contenuto e nessun tool con capacità di scrittura. Si annotano identificatore, piano, regione, endpoint e parametri di thinking, poi si confrontano risposta, errori e consumo visibile nell’account. Solo dopo si può provare uno schema JSON e una funzione innocua con argomenti verificabili. Le dimostrazioni del fornitore non sostituiscono questo controllo. È una procedura da eseguire, non un test già effettuato sul dispositivo o sull’abbonamento di Francesco.
Qwen4-Max: specifiche, API e percorsi di accesso.
Checklist pratica proposta
- Distinguere qwen4-max da qwen4-max-preview nella configurazione.
- Controllare piano, API key, regione ed endpoint ufficiale corrispondente.
- Separare contesto, output finale e budget di thinking.
- Leggere prezzi e quote del proprio account prima di una richiesta.
- Usare dati sintetici e un limite di output prudente per il primo test.
- Non descrivere l’API come modello locale o come prova di pesi scaricabili.
Condizioni e limitazioni
Verifica documentale, non prova operativa: accesso dell’account, costo effettivo, prestazioni e qualità non verificati. Orario esatto del lancio non indicato.