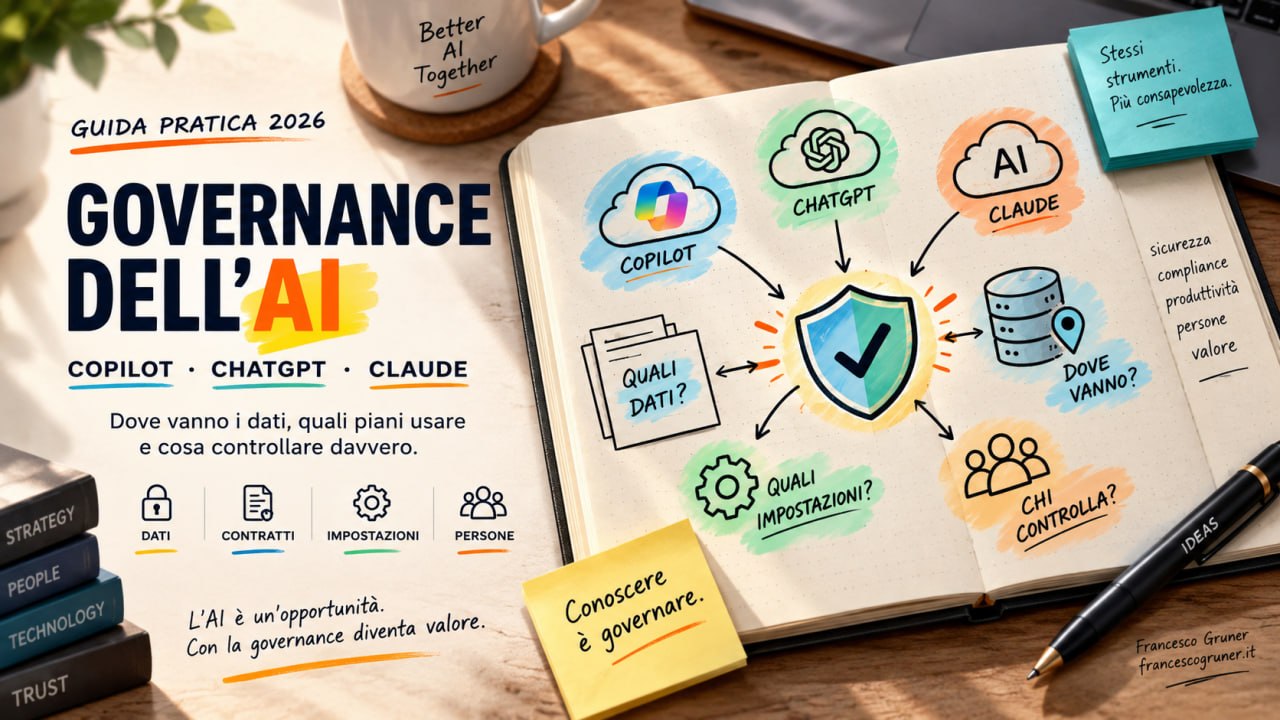
Per scegliere un assistente AI in azienda non basta il marchio: account, modello, connettori (accessi a servizi come SharePoint, Drive o posta), localizzazione, conservazione e controlli devono corrispondere ai rischi del caso d’uso. Copilot, ChatGPT e Claude hanno confini diversi; “enterprise” non significa automaticamente trattamento confinato nell’UE.
Una guida per decidere sull’AI aziendale anche senza competenze tecniche.
In una PMI il rischio è spesso concreto: dati personali incollati in un account consumer, un modello alternativo abilitato senza verificarne il fornitore, oppure storage europeo scambiato per elaborazione interamente europea.
Un’azienda usa Microsoft 365 Copilot, tre dipendenti hanno ChatGPT Plus personale e il reparto tecnico utilizza Claude Code. Non ha semplicemente “tre strumenti AI”: ha identità diverse, contratti diversi, più modelli, connettori e condizioni di conservazione differenti. Governance significa prima di tutto sapere che questa situazione esiste.
Governance AI: non una policy da firmare, ma un sistema da mantenere
La policy da sola non basta: allineate contratto, impostazioni del tenant (l’ambiente Microsoft 365 dell’organizzazione), dati utilizzati e processo che impiega l’output.
Contratto
Configurazione
Uso
Controllo
Nessun bollino “GDPR compliant” sostituisce una configurazione documentata per trattamenti definiti e riesaminata quando cambiano modelli, condizioni o processi.
Scarica il modello gratuito di Policy AI aziendale 2026
Ho preparato un modello Word modificabile da utilizzare come punto di partenza per definire una Policy AI aziendale.
Include regole sui dati, ruoli e responsabilità, controlli di sicurezza, gestione degli incidenti e schede dedicate a Microsoft 365 Copilot, ChatGPT e Claude.
È una bozza operativa da adattare alla propria organizzazione e approvare dalle funzioni responsabili, con il coinvolgimento di legale, DPO, HR e IT secondo i rispettivi ruoli, prima dell’adozione.
Scarica il modello Word (.docx)Microsoft 365 Copilot: modelli, Flex Routing e confini dei dati
Essere dentro Microsoft 365 semplifica identità, autorizzazioni e audit, ma non garantisce che ogni inferenza (l’elaborazione che genera la risposta) resti in Europa. La documentazione Microsoft sulla Flex Routing per UE ed EFTA precisa che, per i tenant interessati, dopo il 25 marzo 2026 l’abilitazione può diventare predefinita in condizioni specifiche: non esiste una data universale in cui «tutto esce dall’Europa». Verificate rollout, eleggibilità e impostazioni del vostro tenant.
Con Flex Routing attivo, prompt, risposte e grounding (informazioni aziendali consultate per rispondere) possono essere elaborati fuori dall’EU Data Boundary, negli Stati Uniti, in Canada o in Australia. Disabilitarlo mantiene l’inferenza dei modelli linguistici coperti nel perimetro UE, ma non elimina automaticamente eccezioni o trasferimenti di altri servizi.
Modello ospitato, subprocessore o fornitore indipendente
Modello ospitato
Subprocessore
Fornitore indipendente
Questi ruoli cambiano responsabilità e documenti applicabili: censite ogni famiglia di modelli con proprietario, casi d’uso ammessi e condizioni, invece di abilitarle tutte insieme.
ChatGPT: Business, Enterprise e residenza dei dati
OpenAI dichiara che, per impostazione predefinita, non addestra i modelli sui dati delle offerte business. Questo non determina dove avvengano archiviazione, inferenza e altri trattamenti, né quanto a lungo i contenuti restino conservati.
La documentazione sulla residenza dei dati distingue storage regionale e inference residency (inferenza sulle GPU nella regione). Per ChatGPT Business, l’archiviazione regionale viene distribuita gradualmente ai workspace idonei e copre contenuti definiti, non garantisce inferenza nella stessa regione. Per Enterprise ed Edu idonei sono disponibili storage europeo e, in regioni e configurazioni previste, inference residency; alcune elaborazioni globali restano necessarie. Su Business i log antiabuso restano negli USA; se scegliete una regione non statunitense, anche una copia di ciascun prompt e risposta vi resta per un tempo limitato per sicurezza e applicazione delle regole. Una mappa contrattuale deve specificare contenuti coperti, metadati, eccezioni e regione configurata.
App, integrazioni esterne e server MCP seguono termini e percorsi dei rispettivi fornitori: non ereditano automaticamente le garanzie del workspace. Verificate separatamente connettori, GPT personalizzati e API.
Prima del rollout, fate una prova con un workspace di test: confrontate la regione indicata nel contratto con quella effettivamente selezionata nell’interfaccia amministrativa. Documentate quali file e conversazioni rientrano nello storage regionale e chi può esportarli o cancellarli. Se abilitate un’app esterna, chiedete dove tratta i dati e per quanto li conserva: il suo accordo può avere condizioni diverse da quelle del servizio principale. La stessa verifica vale quando una funzione viene aggiunta dopo l’acquisto.
Business ed Enterprise: controlli e costi differenti
Business è un prodotto aziendale con prezzo per utente pubblicato, ma non offre necessariamente gli stessi controlli amministrativi e geografici di Enterprise. Enterprise segue condizioni commerciali dedicate: prima di progettare processi su funzionalità specifiche, chiedete un’offerta per l’organizzazione. Anche Edu ha requisiti di idoneità propri.
Claude: servizio diretto, cloud e costi
Anthropic dichiara che i dati commerciali non vengono usati per addestramento salvo accordi o programmi espliciti. Per il servizio diretto, la pagina ufficiale sui server indica storage negli Stati Uniti e routing delle richieste in più regioni: non dichiara residenza esclusivamente UE. Non è un divieto d’uso, ma un confine da valutare. Ne parlo anche nell’analisi della residenza dei dati di Claude.
Bedrock, Vertex AI e Microsoft Foundry
Il canale cambia l’architettura: Amazon Bedrock offre per alcuni modelli endpoint regionali o profili EU Geo che mantengono l’elaborazione nella geografia europea; Vertex AI ha endpoint multi-regione UE per modelli supportati. Contratti e controlli del cloud provider diventano parte della valutazione.
Per Microsoft Foundry distinguete versioni ospitate da Anthropic e versioni Azure-hosted end-to-end; regioni e Data Zone dipendono dal modello. Alla data di verifica, il Data Zone Standard documentato per alcune versioni Azure-hosted è negli Stati Uniti: non costituisce una garanzia generale UE. Se il flusso non è ammissibile, bloccatelo tecnicamente invece di vietarlo solo nella policy.
Una regione dichiarata nel catalogo non prova che ogni versione del modello sia disponibile nello stesso luogo. Prima di migrare, confrontate la scheda del modello, il deployment effettivo, i servizi che registrano richieste e le autorizzazioni dell’account cloud. Verificate anche se le funzioni usate dal team, come strumenti e integrazioni, siano disponibili nel canale selezionato: cambiare endpoint non equivale a replicare l’intero prodotto Claude.
Token, caching e fatturazione
API diretta, Bedrock, Vertex e Foundry possono fatturare a consumo anziché con abbonamento mensile: i token misurano input e output; prezzi dipendono da modello, provider, regione, caching e batch. Anche Claude Code offre diverse autenticazioni e infrastrutture, con possibili costi diversi. Per i nuovi piani Claude Enterprise, Anthropic documenta accesso per postazione più consumo separato; piani precedenti e accordi negoziati possono differire. Chiedete una proposta tecnica e commerciale sul caso d’uso prima di scegliere l’architettura.
Trasferimenti extra UE: non equivalgono a un divieto automatico
La verifica non si esaurisce nel paese del server. Distinguete dati inviati nel prompt, documenti richiamati dai connettori, metadati tecnici, log e accessi per assistenza. Registrate destinatari e finalità del trasferimento nella mappa dei flussi: ciò che è accettabile per un testo pubblico può non esserlo per informazioni dei clienti. Se una funzione opzionale modifica la destinazione, la sua attivazione deve passare da una nuova valutazione, non da un consenso generico all’uso del prodotto.
«USA = vietato, Europa = conforme» è una falsa scorciatoia. Per i dati personali trasferiti fuori UE serve uno strumento previsto dal GDPR. L’EU-US Data Privacy Framework si basa su una decisione di adeguatezza e può applicarsi se il destinatario statunitense è certificato per i dati e il trattamento interessati. In altri casi possono servire Standard Contractual Clauses (SCC) e le ulteriori verifiche del caso concreto. Alla data di verifica la decisione DPF resta applicabile; monitoratene l’evoluzione normativa e giudiziaria.
Né la certificazione del fornitore né la sua sede europea autorizzano a inviare qualsiasi dato. Riscrivere una descrizione pubblica non equivale a caricare contratti riservati, dati sanitari o giudiziari, credenziali e segreti industriali. Chiedetevi: quali dati, per quale finalità, tramite quale servizio e con quali garanzie?
Modello, infrastruttura e provider europei
Gestire il modello in proprio sposta responsabilità sull’organizzazione: aggiornamenti, protezione degli endpoint, controllo degli accessi, log e disponibilità non sono forniti automaticamente da un abbonamento SaaS. Un provider cloud può assumere parte di questi compiti, ma il suo contratto e i servizi ausiliari entrano nel flusso dei dati. Perciò confrontate il costo operativo e le competenze interne necessarie, oltre alla localizzazione.
I modelli open-weight distribuiscono pesi eseguibili nel rispetto della licenza, anche su infrastrutture scelte dall’organizzazione. Non sono necessariamente open source: codice, dati di addestramento e diritti di modifica o ridistribuzione possono differire. Modelli come DeepSeek e GLM possono, se licenza e requisiti lo permettono, girare su infrastruttura propria o presso un provider scelto.
Un modello sviluppato in Cina può operare in Europa senza inviare prompt alle API originali; uno europeo può dipendere da componenti extra UE. Open-weight non significa automaticamente privato, sicuro o conforme: verificate hosting, log, servizi esterni, subprocessori e destinazione dei dati. L’esecuzione locale e il cloud di terzi creano perimetri diversi.
Mistral: endpoint e control plane
Mistral AI, società francese, indica hosting UE predefinito per i suoi servizi; l’endpoint API statunitense comporta invece hosting negli USA. Per l’API distingue endpoint globale ed endpoint regionale UE. Non tutti i modelli, strumenti o dati del control plane condividono la stessa garanzia. Controllate prodotto, contratto, subprocessori, retention e funzionalità abilitate.
GDPR e AI Act: gli obblighi dipendono dall’uso
Il GDPR non impone una DPIA per ogni uso dell’AI. Quando il trattamento può presentare un rischio elevato per i diritti e le libertà delle persone, il Titolare del trattamento deve valutare la necessità di una DPIA, consultando il DPO ove designato. Screening sistematico, categorie particolari di dati, monitoraggio, valutazioni su larga scala o decisioni con effetti significativi possono alzare il rischio; riassumere un testo pubblico è diverso. Documentate lo screening e l’escalation.
Il DPO svolge una funzione di consulenza e vigilanza: può fornire il proprio parere e monitorare il processo, mentre la responsabilità delle decisioni sul trattamento rimane in capo al Titolare.
L’articolo 4 dell’AI Act, dopo la modifica del 2026, chiede a fornitori e deployer misure per sostenere l’AI literacy di personale e persone che usano sistemi per loro conto. È un obbligo di mezzi: formazione proporzionata a ruolo, contesto, rischio, limiti e supervisione umana.
L’articolo 50 non impone di etichettare ogni testo AI: obblighi ed eccezioni variano per fornitori e deployer, interazione diretta, contenuti sintetici, deepfake e testi pubblicati per informare il pubblico su questioni di interesse pubblico. Distinguete uso interno, comunicazione esterna e contenuti sensibili; si veda la guida sull’articolo 50.
Considerate il Regolamento (UE) 2026/1744, non solo checklist precedenti. La Legge 132/2025, articolo 13 prevede per le professioni intellettuali un uso di supporto e informazioni chiare al cliente sull’impiego dell’AI.
Come scegliere: dati prima del chatbot
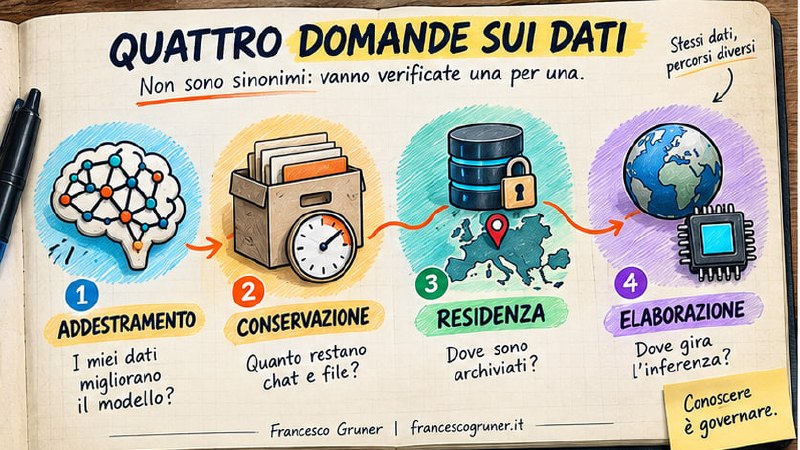
Partite dall’operazione concreta: chi inserisce il dato, chi può leggere la risposta e quale decisione verrà presa. Poi chiedete al fornitore la documentazione del piano acquistato, non una garanzia generica valida per altri prodotti. Nella scheda di valutazione separate quattro domande: uso dei dati per addestramento, luogo di archiviazione, luogo dell’inferenza e altri trattamenti necessari al funzionamento. Aggiungete tempi di conservazione, accessi di supporto e integrazioni: una risposta favorevole su un punto non risolve gli altri.
Per un documento interno, per esempio, non basta sapere dove gira il modello: un connettore può ampliare i contenuti accessibili e l’output può essere condiviso fuori dal gruppo previsto. Un test con dati pubblici consente di verificare utilità e revisione umana prima di aprire l’accesso ai documenti riservati. Quando entrano dati personali o obblighi del cliente, coinvolgete le funzioni competenti e registrate la decisione, comprese le alternative scartate.
Un Business governato può bastare per materiale pubblico; Copilot si integra nel lavoro Microsoft 365. Per dati riservati con vincoli geografici, valutate Enterprise, API regionali, Bedrock, Vertex o Azure; per maggior controllo, open-weight su infrastruttura scelta o provider europei come Mistral. Nessuna piattaforma è «la più conforme» in assoluto: nei trattamenti delicati decidete prima requisiti e controlli.
Dati → Caso d’uso → Requisiti → Modello → Infrastruttura → Contratto → Configurazione. Lo stesso strumento può essere adatto a un flusso e inadatto a un altro.
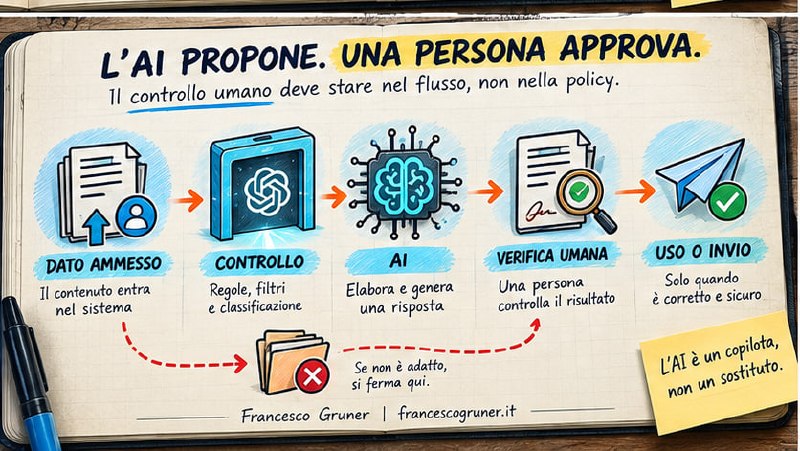
Un metodo in sette passi per scegliere e governare gli strumenti
Il metodo produce evidenze utili anche quando decidete di non adottare uno strumento. Non serve compilare un questionario identico per ogni prompt: definite classi di attività, approvate i flussi ricorrenti e riaprite la valutazione quando cambiano dati, modelli, regioni o destinatari dell’output. Così le persone sanno cosa possono fare senza aspettare un’autorizzazione improvvisata per ogni richiesta.
- Inventariate servizi e account. Separate consumer, business, enterprise, API, funzioni integrate e strumenti acquistati dai singoli reparti. Annotate proprietario, piano, identità usata e rinnovo.
- Mappate i casi d’uso. “Usiamo Copilot” non è un caso d’uso. “Preparare una bozza da documenti SharePoint interni” lo è. Indicate input, output, interessati, decisione supportata e revisore umano.
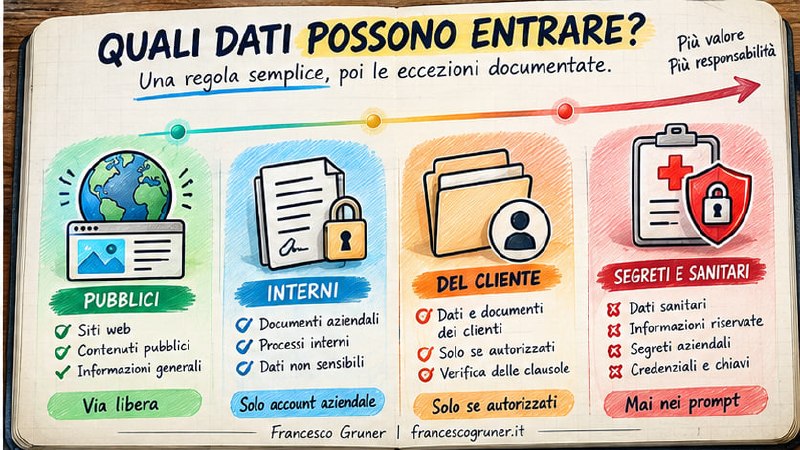
- Classificate i dati. Create poche categorie applicabili: pubblico, interno, riservato, dati personali, categorie particolari, segreti e dati soggetti a vincoli del cliente.
- Disegnate il flusso reale. Includete grounding, connettori, plugin, log, retention, supporto, subfornitori, regioni e download dell’output. Il diagramma deve rappresentare la configurazione acquistata.
- Applicate controlli tecnici. SSO (accesso ai servizi con l’identità aziendale), MFA, gruppi, blocco degli account non gestiti, DLP (controlli che aiutano a impedire la condivisione impropria di dati sensibili) dove disponibile, connettori approvati, logging, retention e revisione periodica degli amministratori.
- Valutate rischio e obblighi. Fate screening GDPR/DPIA, ruolo nell’AI Act, trasparenza, trasferimenti, proprietà intellettuale, sicurezza e obblighi professionali. Registrate decisione e motivazione.
- Misurate e riesaminate. Controllate incidenti, eccezioni, nuovi modelli, modifiche dei termini e reale utilità. Una licenza inutilizzata è un costo; un modello non governato è anche una superficie di rischio.
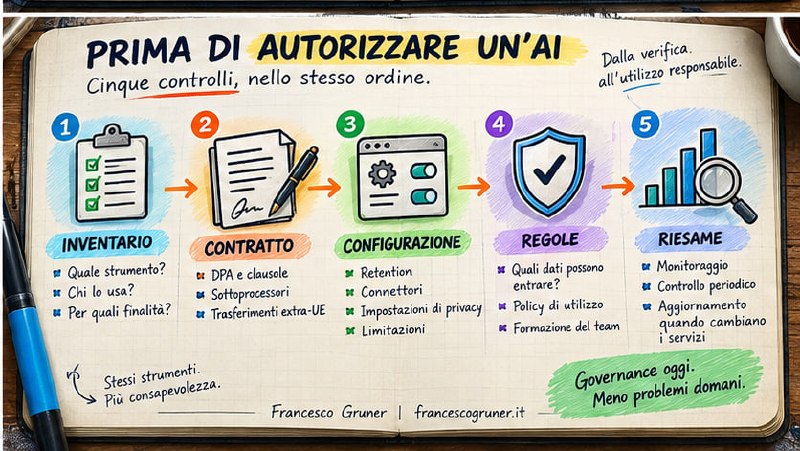
Checklist operativa per PMI, IT e DPO
Usate queste domande durante l’approvazione e nei riesami periodici. Per ogni risposta conservate una prova concreta: impostazione verificata, documento contrattuale, proprietario del controllo o decisione motivata. Un «sì» senza evidenza non aiuta a ricostruire cosa fosse realmente attivo quando il servizio è stato autorizzato.
- Esiste un registro unico di strumenti, piani, amministratori e proprietari del servizio?
- Gli account personali sono vietati o tecnicamente limitati per il lavoro?
- Ogni caso d’uso ha una categoria di dati ammessa e una esplicitamente vietata?
- Sono documentate regione di storage, regione di inferenza, trasferimenti e subprocessori?
- Le opzioni come Flex Routing sono verificate nel tenant, non dedotte da un articolo?
- I modelli alternativi sono approvati uno per uno, con il relativo ruolo contrattuale?
- Connettori e plugin hanno una valutazione distinta dal chatbot principale?
- File e conversazioni persistenti sono gestiti consapevolmente? Ho raccolto i controlli specifici nell’articolo sulla Libreria di ChatGPT.
- Retention, esportazione, cancellazione e accesso amministrativo sono configurati?
- Gli output destinati a clienti o decisioni rilevanti richiedono revisione umana?
- È stato eseguito e registrato lo screening DPIA, con criteri di escalation?
- La formazione soddisfa l’AI literacy per ruolo, contesto e rischio?
- Esiste una procedura per errori, data leakage, prompt injection e output dannosi?
- Ogni trimestre qualcuno controlla cambi di termini, modelli, default e regioni?
Struttura minima di una policy AI che possa funzionare
Una policy utile è breve al centro e precisa negli allegati. Può seguire questo schema:
1. Scopo e ruoli
2. Catalogo autorizzato
3. Regole sui dati
4. Uso dell’output
5. Sicurezza e incidenti
6. Eccezioni e riesame
Allegati per servizio
Registrate regioni, subfornitori, default, retention e funzioni abilitate in una scheda aggiornabile senza riscrivere la policy.
Metriche
Misurate account gestiti, casi d’uso con proprietario, eccezioni scadute, formazione, incidenti e tempo di revisione. Il numero di prompt non dimostra produttività: valutate miglioramento del compito, rischio residuo e costo.
Riesame e dismissione
Definite chi approva gli acquisti e, all’uscita, revocate accessi, chiudete connettori, esportate o cancellate dati e conservate le evidenze necessarie. Verificate mensilmente gli accessi critici, trimestralmente modelli e connettori; aggiornate la formazione ogni anno o al cambiare del rischio. Annotate data, responsabile, esito, correzioni e scadenza.
Domande frequenti
Copilot mantiene sempre i dati nell’Unione europea?
No. Dipende da tenant, funzione, modello e configurazione. Con Flex Routing attivo, prompt, risposte e grounding possono essere elaborati negli Stati Uniti, in Canada o in Australia. Disabilitarlo protegge il perimetro dei modelli coperti, non cancella ogni possibile eccezione del servizio.
ChatGPT Business mantiene i dati in Europa?
Non per tutti i workspace: la data residency è in distribuzione graduale e copre i contenuti principali a riposo, non l’inferenza. I log antiabuso restano negli USA; con una regione non statunitense, vi resta per un tempo limitato anche una copia di prompt e risposte per sicurezza. Verificate piano, regione e funzioni attive.
Posso usare ChatGPT in azienda con il GDPR?
Non esiste un sì valido per ogni trattamento. Scegliete il piano adatto, classificate i dati, verificate DPA, trasferimenti, retention, accessi e configurazione; documentate il caso d’uso e la valutazione del Titolare. “Non usiamo i dati per addestrare” non risolve da solo queste verifiche.
Claude offre una modalità con dati solo in Europa?
Anthropic non dichiara una residenza esclusivamente europea per il servizio diretto: indica storage negli Stati Uniti e routing in più regioni. La protezione commerciale dal training non modifica questo confine geografico.
Serve sempre una DPIA per usare un assistente AI?
No. Il Titolare valuta la necessità della DPIA quando il trattamento può presentare rischio elevato per i diritti e le libertà; documenta lo screening e consulta il DPO ove designato. Il DPO consiglia e vigila, non assume la decisione del Titolare.
È obbligatoria una Policy AI aziendale?
Non esiste un obbligo generale di adottare proprio questo documento per qualsiasi uso. L’organizzazione deve però governare i trattamenti e gli obblighi applicabili, comprese le misure di alfabetizzazione AI previste dall’AI Act. Una policy operativa documenta strumenti ammessi, dati, ruoli, controlli, incidenti e riesame; il modello Word è una bozza da adattare, non un certificato di conformità.
Il modello è gratuito. La parte difficile è compilarlo correttamente.
Scaricare una policy è semplice. Capire quali strumenti AI vengono realmente utilizzati, quali dati possono trattare, dove vengono elaborati, quali connettori sono attivi e quali configurazioni sono applicate al tenant richiede invece una verifica tecnica.
Se vuoi, posso effettuare un assessment degli strumenti AI utilizzati dalla tua azienda, delle configurazioni e dei flussi dati e aiutarti a trasformare questa bozza in una policy realmente applicabile.
Fonti e riferimenti
Tre fonti primarie per verificare i confini operativi dei servizi. Le norme europee e italiane sono collegate direttamente nei passaggi pertinenti.
Flex Routing (EU and EFTA)
Default condizionali, destinazioni di elaborazione e conseguenze dell’abilitazione o disabilitazione.
Apri fonteData residency and inference residency
Differenze tra piani, storage regionale, inferenza e trattamenti globali necessari.
Apri fonteWhere are your servers located?
Posizione dei server, storage negli Stati Uniti e routing delle richieste in più regioni.
Apri fonteAltri documenti primari citati
- Microsoft Learn - Anthropic come subprocessor nei servizi Microsoft Online
- Amazon Bedrock - Claude Sonnet 5, disponibilità regionale ed EU Geo
- Google Cloud - endpoint multi-regione UE per Claude su Vertex AI
- Microsoft Foundry - versioni Claude, hosting e deployment disponibili
- EUR-Lex - Regolamento (UE) 2026/1744
- OpenAI - archiviazione dei contenuti ChatGPT Business
- EUR-Lex - decisione di adeguatezza EU-US Data Privacy Framework
- Anthropic - autenticazione e provider supportati in Claude Code
- Mistral AI - localizzazione dei dati
- Open Source Initiative - Open Source AI Definition 1.0
- Anthropic - prezzi API e consumo dei modelli Claude
- Anthropic - fatturazione dei nuovi piani Claude Enterprise
- AWS - prezzi Amazon Bedrock
- Google Cloud - prezzi Claude su Vertex AI
- Microsoft Learn - fatturazione Claude in Foundry
- Mistral AI - inferenza regionale
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.