Agente = modello + harness. La formula è di DeepSeek e spiega bene dove finiscono i soldi.
L’harness è l’impalcatura: quella che dà al modello gli strumenti, l’accesso ai file, la memoria e le regole su quando fermarsi. Claude Code, Codex, Hermes Agent, DeepSeek Harness sono tutti harness, e quasi tutti sono gratuiti o open source. Installarli non costa niente.
A costare è il modello. Ogni token che il tuo agente manda a un’API a pagamento è una voce sul conto a fine mese, e se lavora tutto il giorno il conto sale in fretta.
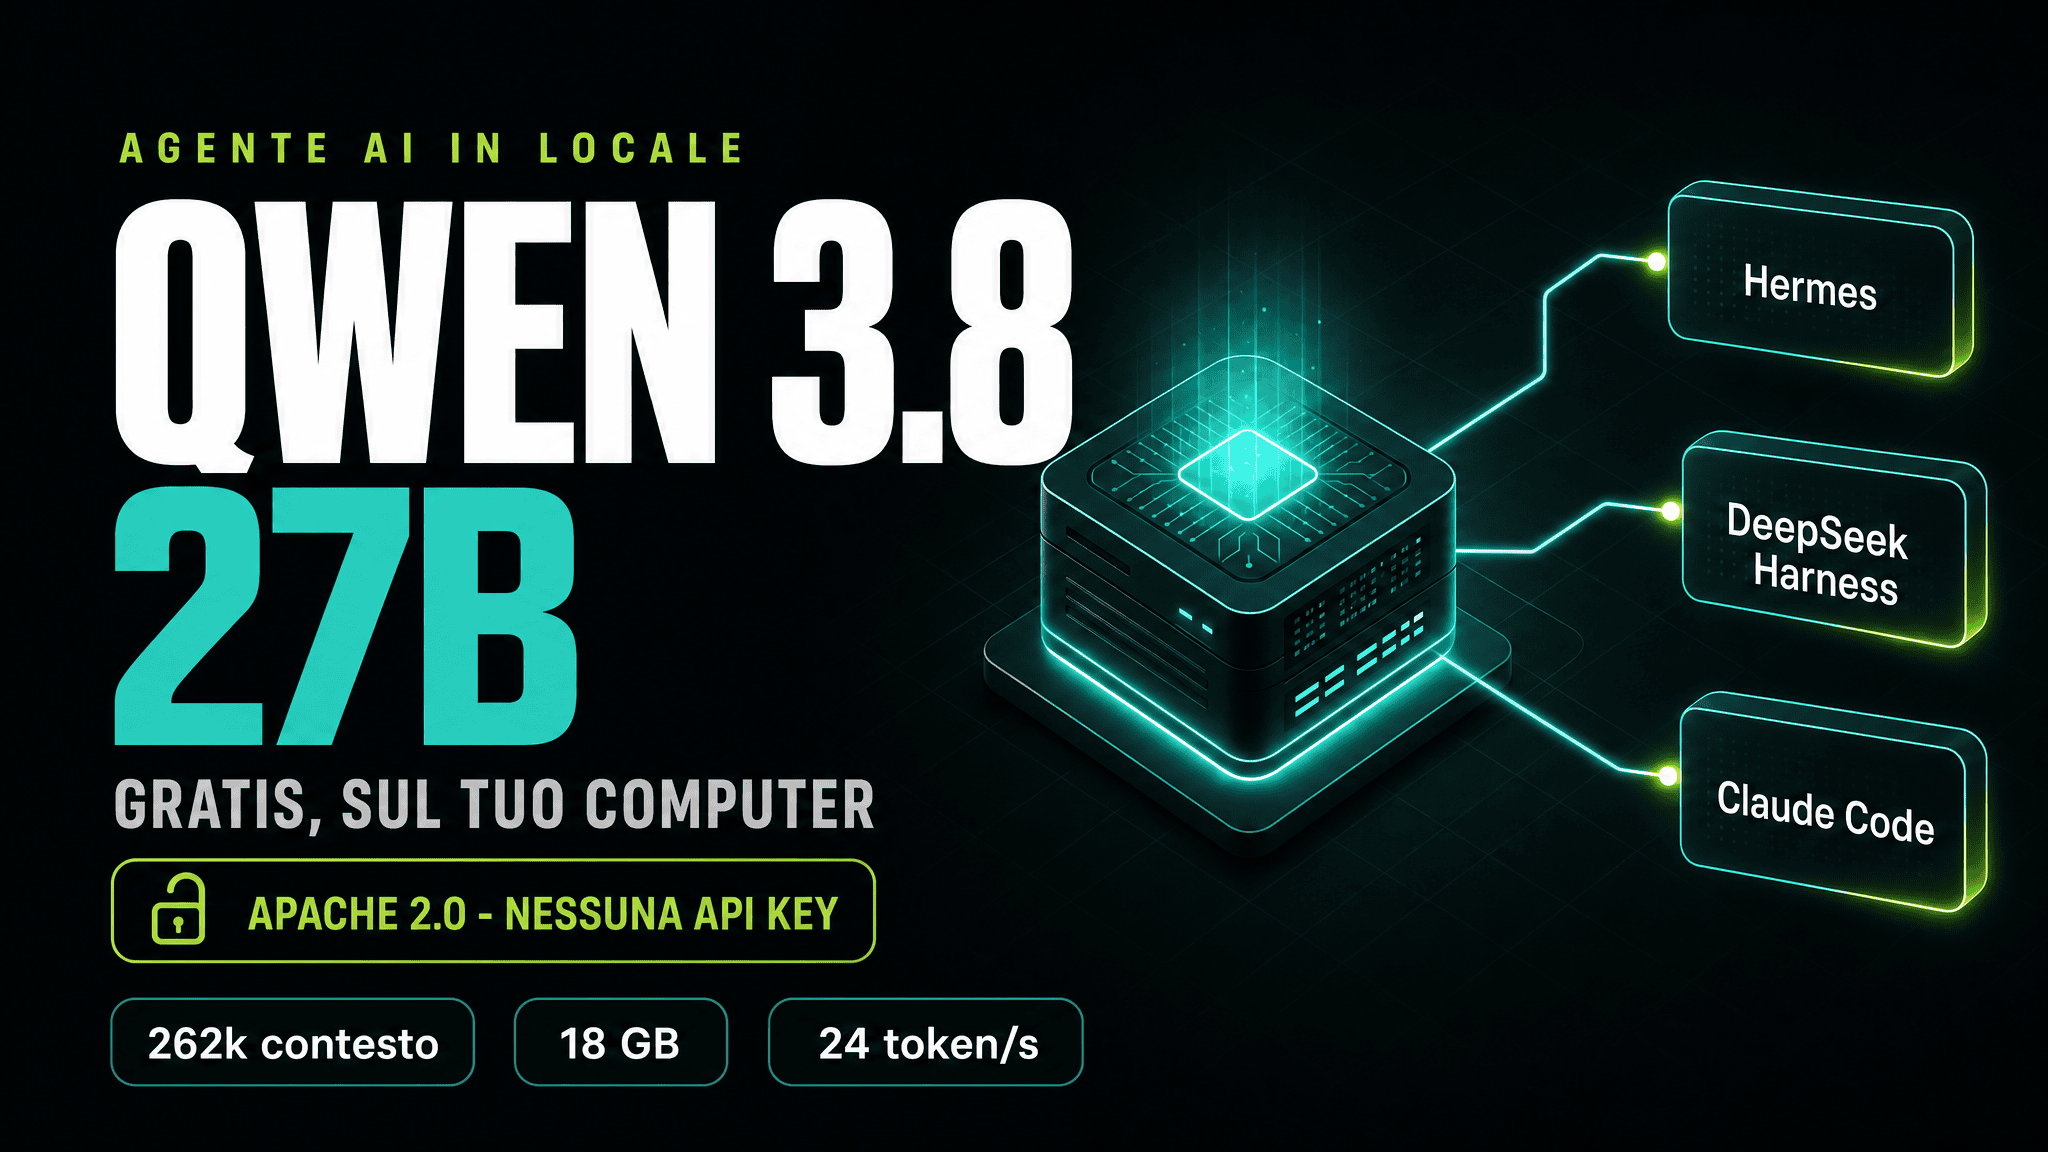
Quindi la domanda giusta non è quale strumento usare, ma cosa ci metti dentro. E da qualche giorno c’è una risposta concreta: Qwen3.8 27B, il modello aperto di Alibaba, gira sul tuo computer e si collega a qualunque di quegli harness. Licenza Apache 2.0, nessuna chiave API, nessun limite di richieste, nessun dato che esce dalla tua rete.
Ho misurato le prestazioni su un mini-PC Beelink con Radeon 8060S e 128 GB di memoria unificata, di cui 96 GiB assegnati alla scheda grafica. In questa guida trovi come installarlo, come collegarlo ai due framework agentici, e quali impostazioni fanno la differenza tra un modello che vola e uno che sembra rotto.
Cos’è Qwen3.8 27B
È un modello denso da 27,8 miliardi di parametri rilasciato da Alibaba il 13 agosto 2026 con licenza Apache 2.0, la più permissiva in circolazione: uso commerciale, modifica e ridistribuzione sono tutti consentiti.
Le caratteristiche che contano per l’uso come agente:
- 262.144 token di contesto nativi, estendibili fino a un milione con configurazione aggiuntiva
- Multimodale di serie: capisce immagini e video, non solo testo
- Chiamata degli strumenti e modalità di ragionamento regolabile
- Testa MTP integrata per la decodifica speculativa, cioè il meccanismo che raddoppia la velocità senza installare nulla
- 18 GB di download nella versione quantizzata: sta su una scheda da 24 GB
Alibaba lo presenta esplicitamente come costruito per i compiti agentici a lungo orizzonte, con pianificazione autonoma più solida e migliore gestione del ritorno dall’ambiente. Non è un modello da chat riadattato: è pensato per portare a termine sequenze lunghe di azioni.
I due riferimenti ufficiali:
- Pesi originali su Hugging Face: Qwen/Qwen3.8-27B
- Versione pronta all’uso su Ollama: ollama.com/library/qwen3.8
Installazione in due comandi
Se hai già Ollama installato, servono due righe:
ollama pull qwen3.8
ollama run qwen3.8
Il tag qwen3.8 punta al 27B, che è la versione predefinita. Scarica 18 GB e ti mette in chat.
Su Mac con chip Apple conviene la variante ottimizzata:
ollama pull qwen3.8:27b-mlxEsiste anche un tag che include già la testa per la decodifica speculativa:
ollama pull qwen3.8:27b-mtp-q4_K_MStesse dimensioni, stessi pesi, più il meccanismo di accelerazione integrato.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Le tre impostazioni che cambiano tutto
Il modello appena installato funziona, ma non al meglio. Tre regolazioni fanno la differenza tra 10 e 25 token al secondo, e nessuna delle tre dà errore se la sbagli: il modello va semplicemente piano.
1. Dichiara sempre la dimensione del contesto
Se non specifichi num_ctx, Ollama apre la finestra nativa completa, 262.144 token, e spinge il carico sulla memoria di sistema. Risultato: lentezza inspiegabile con la scheda grafica quasi ferma.
Per l’uso agentico normale 32.768 token sono abbondanti. Se ti serve la finestra grande, la puoi aprire: ho misurato il consumo di memoria fino ai 262.144 token e la velocità resta praticamente identica, meno 3% sul testo libero e meno 7% sul riassunto rispetto a 8k. È una particolarità architetturale di questo modello, che ho documentato nel confronto con Muse Glimmer 30B, ancora in preparazione.
2. Regola il parametro della decodifica speculativa
Il valore da toccare è draft_num_predict. Le mie misure:
Il valore giusto è 4. Sopra crolla, perché il modello spreca lavoro su previsioni che poi scarta.
3. Su GPU AMD usa Vulkan, non ROCm
Se hai una scheda AMD, il backend fa una differenza enorme. Sulle mie prove Vulkan genera testo il 50% più velocemente di ROCm, 22,50 contro 15,05 token al secondo.
Ma il motivo decisivo è un altro: ROCm su questa macchina vede solo 21 GiB dei 96 disponibili, Vulkan ne vede 111. Con ROCm le finestre di contesto grandi semplicemente non ci stanno.
Attenzione a una trappola: impostare OLLAMA_LLM_LIBRARY=rocm sembra corretto ma quel nome non esiste, e il sistema ripiega in silenzio sul processore. La velocità crolla di cinque o dieci volte senza nessun messaggio di errore. Il nome giusto è rocm_v7_2.
Quale harness scegliere
Il modello resta lo stesso, cambia l’impalcatura che ci monti attorno. Sono tutti gratuiti, e la scelta dipende da cosa ti serve: un agente persistente che ti raggiunge su Telegram, un’infrastruttura da smontare pezzo per pezzo, o lo strumento da terminale che usi già.
Hermes Agent
Hermes Agent è il framework di agenti open source di Nous Research, licenza MIT, uscito a febbraio 2026. Gira sul tuo server, ha memoria persistente tra le sessioni, si scrive da solo le competenze che impara, e ti raggiunge su Telegram, Discord, Slack e altre piattaforme.
La cosa notevole: Ollama documenta ufficialmente il lancio diretto. Un comando solo:
ollama launch hermes --model qwen3.8Non serve configurare endpoint a mano né inserire chiavi. Hermes parte già collegato al modello locale.
Il requisito minimo dichiarato da Hermes è un modello con almeno 64.000 token di contesto. Qwen3.8 ne offre 262.144, quindi sei quattro volte sopra la soglia. E siccome tutto resta sulla tua macchina - memorie, competenze, cronologia in un database locale - non esce niente verso servizi di terze parti.
DeepSeek Harness
DeepSeek Harness è l’infrastruttura per agenti che DeepSeek ha aperto ad agosto con licenza MIT, e di cui ho scritto nella guida dedicata. Qui il collegamento passa dalla configurazione dei provider.
Avvia l’interfaccia:
npx @deepseek-ai/dsh webPoi apri Settings → Models e aggiungi un provider personalizzato con questi valori:
- Provider ID:
ollama-local(minuscolo, senza spazi) - Base URL:
http://localhost:11434/v1 - Protocollo API:
openai-completions - Modello:
qwen3.8
Ollama espone un endpoint compatibile con l’API di OpenAI, quindi Harness lo tratta come qualsiasi altro fornitore. Le modifiche valgono dalla richiesta successiva, senza riavviare.
Un dettaglio che fa perdere tempo: un modello aggiunto a mano viene considerato solo testo. Siccome Qwen3.8 capisce anche le immagini, se vuoi usarle devi dichiararlo nel file settings.yaml:
llm-pi-ai:
  providers:
    ollama-local:
      api: openai-completions
      baseURL: http://localhost:11434/v1
      models:
        - id: qwen3.8
          input: [text, image]
Senza quella riga l’immagine viene rifiutata prima ancora di partire.
Claude Code, OpenCode e OpenClaw
Qui sta il punto che in pochi hanno capito: non devi abbandonare lo strumento, devi cambiargli il motore. Claude Code come programma è gratuito, quello che paghi è il modello di Anthropic che sta dietro. Sostituiscilo e resta gratis anche l’uso.
ollama launch claude --model qwen3.8
ollama launch opencode --model qwen3.8
ollama launch openclaw --model qwen3.8
Tieni l’interfaccia e il flusso di lavoro a cui sei abituato, ma i token li genera il tuo computer. Se vuoi la procedura passo passo, l’ho spiegata nella guida per collegare Claude Code a Ollama.
Quanto va davvero
Questi sono i numeri che ho misurato, con la macchina completamente libera e cinque giri validi per ogni prova.
Per capire cosa significano: sopra i 20 token al secondo il testo esce più velocemente di quanto tu riesca a leggerlo. Non percepisci attesa.
Sul contesto massimo il modello resta interamente sulla scheda grafica e non scarica niente sul processore: occupa 35,2 GiB dei 96 assegnati, quindi ne restano liberi una sessantina per fare altro.
Due cose da sapere prima di metterlo al lavoro tutto il giorno. La prima: sotto carico continuo oltre i dieci minuti la velocità scende del 10-25%, e si riprende con un paio di minuti di pausa. Non è surriscaldamento, la scheda sta sui 64-66 gradi: è un limite di potenza sostenuta. La seconda: ho misurato velocità e memoria, non la qualità delle risposte su compiti agentici lunghi. Quel confronto lo sto facendo adesso e lo pubblico quando avrò i numeri.
Quanto risparmi
Il calcolo è semplice, e riguarda solo metà dell’equazione. L’harness non lo paghi in nessuno dei casi. Quello che cambia è il modello: un agente che lavora otto ore al giorno su un’API a pagamento genera un conto mensile che cresce con l’uso, mentre lo stesso agente alimentato da Qwen3.8 in locale ha un costo marginale pari alla corrente elettrica.
L’investimento iniziale è l’hardware: serve una scheda da almeno 24 GB, oppure un Mac o un mini-PC con memoria unificata sufficiente. Sotto i 16 GB questo modello non è la scelta giusta, meglio guardare a taglie inferiori.
Il secondo risparmio non si misura in euro: nessun dato esce dalla tua rete. Per chi lavora con documenti di clienti, dati sanitari o materiale sotto NDA, questo da solo può giustificare la scelta.
Da dove partire
Se vuoi provare oggi, l’ordine più rapido è questo. Installa Ollama e scarica il modello con ollama pull qwen3.8. Lancia Hermes con il comando singolo e verifica che risponda. Regola num_ctx a 32.768 e draft_num_predict a 4. Se hai una GPU AMD, controlla di essere su Vulkan.
A quel punto hai un agente autonomo, con memoria persistente, che gira interamente su hardware tuo e non ti manda nessuna fattura a fine mese.
Qwen3.8 27B è davvero gratis?
Sì. I pesi sono rilasciati con licenza Apache 2.0, che consente uso commerciale, modifica e ridistribuzione. Non ci sono chiavi API né limiti di richieste: l’unico costo è l’hardware e la corrente elettrica.
Che hardware serve?
Il download è di 18 GB, quindi servono circa 20-24 GB di memoria grafica per farlo girare interamente sulla scheda. Vanno bene una RTX 4090 o 5090, un Mac con 24 GB o più di memoria unificata, oppure un mini-PC con memoria unificata come il Beelink delle mie prove. Sotto i 16 GB conviene scegliere un modello più piccolo.
Come lo collego a Hermes Agent?
Con un comando solo: ollama launch hermes --model qwen3.8. È il metodo documentato da Ollama e non richiede configurare endpoint o inserire chiavi. Hermes parte già collegato al modello locale.
Posso usarlo dentro Claude Code?
Sì, con ollama launch claude --model qwen3.8. Tieni l’interfaccia e il flusso di lavoro a cui sei abituato, ma i token li genera il tuo computer invece dell’API a pagamento. Lo stesso vale per OpenCode e OpenClaw.
Perché va lento appena installato?
Quasi sempre perché non hai dichiarato num_ctx: senza quel parametro il sistema apre la finestra massima da 262.144 token e spinge il carico sulla memoria di sistema. Imposta 32.768 per l’uso normale e regola draft_num_predict a 4.
Su GPU AMD meglio Vulkan o ROCm?
Vulkan, per due motivi: genera testo circa il 50% più velocemente e soprattutto vede tutta la memoria disponibile, mentre ROCm sulla mia macchina ne vede solo 21 GiB su 96. Con ROCm i contesti grandi non ci stanno.
Regge davvero 262.000 token di contesto?
La finestra si apre senza problemi e la velocità resta piatta, con 35,2 GiB di memoria occupata contro i 18,3 della finestra minima. Il modello non scarica mai niente sul processore. Va detto che ho misurato il costo di aprire quella finestra, non le prestazioni con 200.000 token realmente dentro.
I dati di velocità e memoria vengono da prove eseguite direttamente sulla macchina descritta. Per le caratteristiche dichiarate e le procedure di installazione sono state consultate le fonti ufficiali seguenti.
Repository ufficiale Qwen/Qwen3.8-27B
Pesi originali del modello con licenza Apache 2.0, scheda tecnica completa e indicazioni del produttore sui compiti agentici a lungo orizzonte.
Apri fonteQwen3.8 nella libreria ufficiale di Ollama
Pagina ufficiale con i tag disponibili, le dimensioni del download e i comandi di lancio diretto per Hermes Agent, Claude Code, OpenCode e OpenClaw.
Apri fonteHermes Agent, sito ufficiale
Framework di agenti open source con licenza MIT: memoria persistente, competenze generate automaticamente e collegamento alle principali piattaforme di messaggistica.
Apri fonteDeepSeek Harness: configurazione dei provider
Documentazione ufficiale per aggiungere un fornitore personalizzato compatibile con l’API di OpenAI e per dichiarare le modalità di input del modello.
Apri fonteSto mettendo Qwen3.8 al lavoro come agente su compiti reali per una settimana intera. Quando avrò i numeri li pubblico: iscriviti alla newsletter settimanale su francescogruner.it per riceverli. E se lo colleghi al tuo setup e trovi una configurazione migliore, scrivimi.
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.