Un modello AI locale non si sceglie partendo dal nome. Si parte dal lavoro da fare, dall’hardware che possiedi e dal livello di controllo che vuoi sui dati. In questa guida non riscrivo i miei test: li uso come satelliti di un percorso decisionale. Se vuoi i comandi, le misure e gli errori, trovi i link alle prove complete.
La risposta breve è questa: per chat e automazioni strutturate partirei da un modello quantizzato compatibile con Ollama o llama.cpp; per codice sceglierei solo dopo una prova sul tuo repository; per immagini, audio o documenti verificherei che il modello e il runtime supportino davvero quella modalità. Se l’hardware locale non basta o il carico è occasionale, il cloud può essere un fallback, non un fallimento.
La matrice: use case → hardware → runtime → modello
Nota editoriale: le righe AMD riportano configurazioni realmente usate, non requisiti minimi. Non trasformo un banco prova in una regola generale e non presento velocità stimate come benchmark.
1. Prima domanda: cosa deve fare?
“Qual è il miglior LLM locale?” è una domanda troppo ampia. Una chat generalista, un agente che chiama strumenti, un assistente di coding e un modello multimodale possono premiare caratteristiche diverse. Lo stesso modello può quindi essere accettabile per un flusso e inadatto a un altro: il criterio deve essere il risultato sul task reale.
Definisci prima un set di prompt reali, il formato di output e un criterio di errore. Poi confronta due o tre candidati nelle stesse condizioni. Le classifiche pubbliche aiutano a restringere il campo, ma non sostituiscono la prova sul tuo lavoro.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
2. File scaricato e memoria runtime non sono la stessa cosa
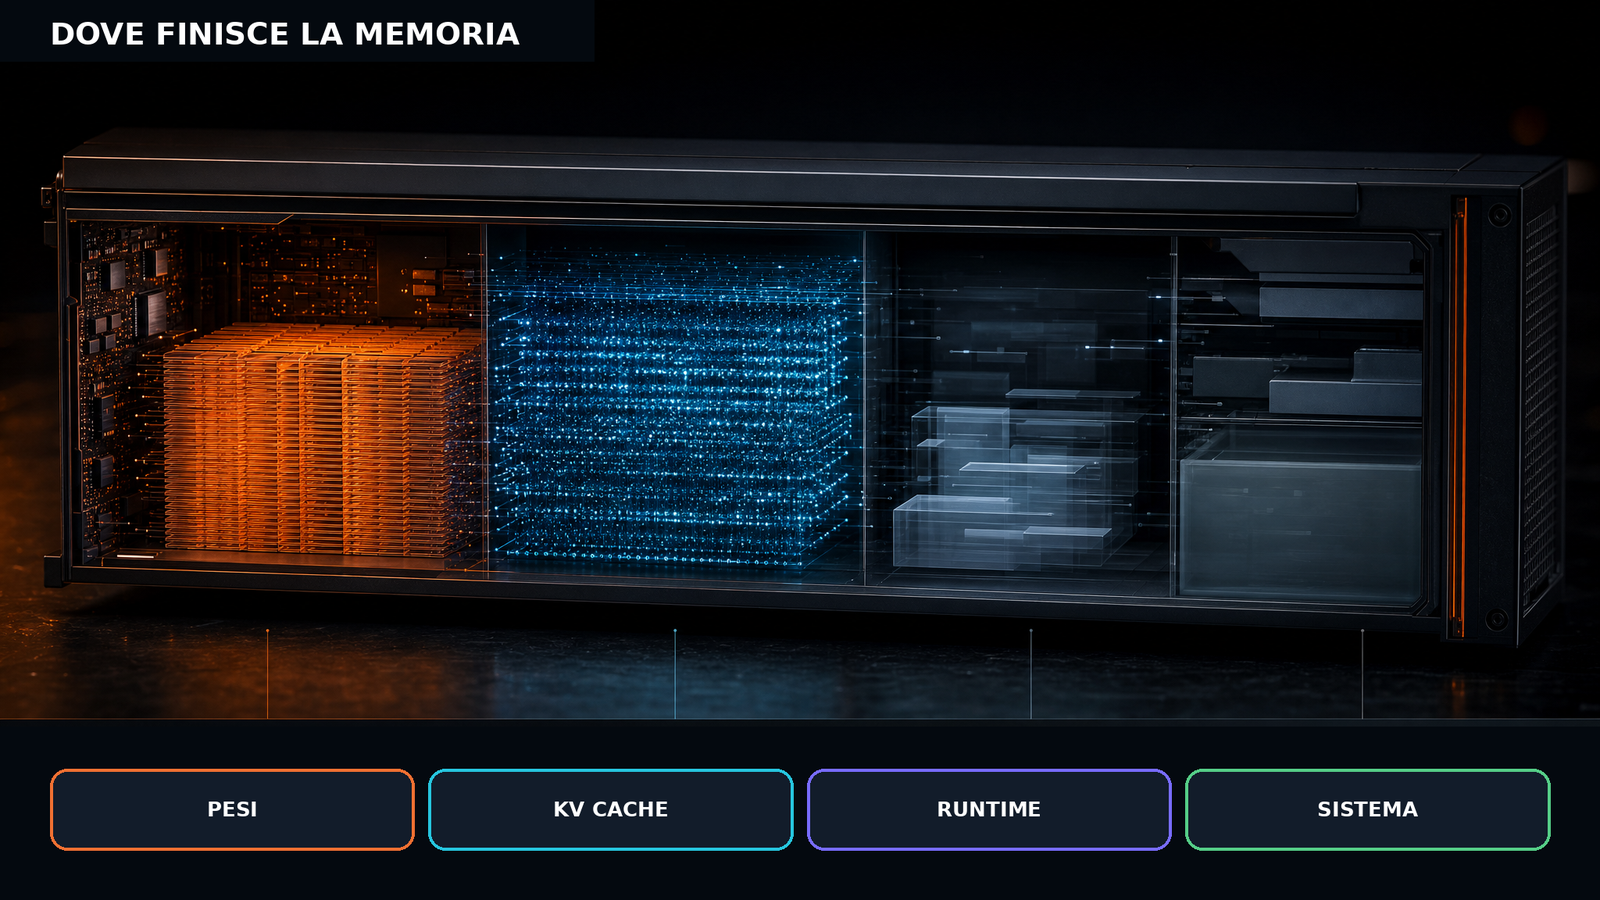
Il peso del file descrive soprattutto i pesi memorizzati. Quando avvii l’inferenza devi considerare anche KV cache, buffer del runtime, contesto e memoria lasciata al sistema. La documentazione di Hugging Face segnala che la KV cache può occupare una parte significativa della memoria nei contesti lunghi: il download, da solo, non descrive quindi la memoria runtime.
Per questo non pubblico una tabella “parametri → RAM minima” universale. Formato, quantizzazione, runtime, offload e lunghezza del contesto cambiano il conto. La procedura più sicura è impostare un contesto realistico, avviare il modello, osservare la memoria effettiva e lasciare margine al sistema operativo.
3. Context window e KV cache: il costo nascosto
Una finestra di contesto molto grande è una capacità massima, non un’impostazione da usare sempre. Più token mantieni attivi, più cresce la cache necessaria a ricordare chiavi e valori dell’attenzione. Se fai chat brevi, non ha senso prenotare automaticamente il massimo. Se lavori su repository o documenti lunghi, misura invece il punto in cui il contesto aggiuntivo migliora davvero il risultato.
4. CPU, GPU NVIDIA e AMD: come decidere senza slogan
- CPU: è il percorso più accessibile e può bastare per modelli piccoli o uso saltuario, ma va provato sul tempo di risposta accettabile per te.
- GPU NVIDIA: ha un ecosistema CUDA ampio; compatibilità e kernel dipendono comunque da runtime, modello e formato.
- GPU AMD: non è automaticamente esclusa. I test del sito su Radeon 8060S usano llama.cpp/Vulkan e mostrano che l’inferenza è possibile, ma quei risultati valgono per quella configurazione.
- Memoria unificata: permette di allocare modelli più grandi su alcune macchine, ma non elimina cache, buffer e memoria di sistema.
Prima di comprare hardware, prova il runtime sul computer che hai. Verifica che l’accelerazione sia realmente attiva e conserva versione, parametri di avvio, contesto e output grezzi: altrimenti due numeri non sono confrontabili.
5. Ollama, llama.cpp e Open WebUI non sono il modello
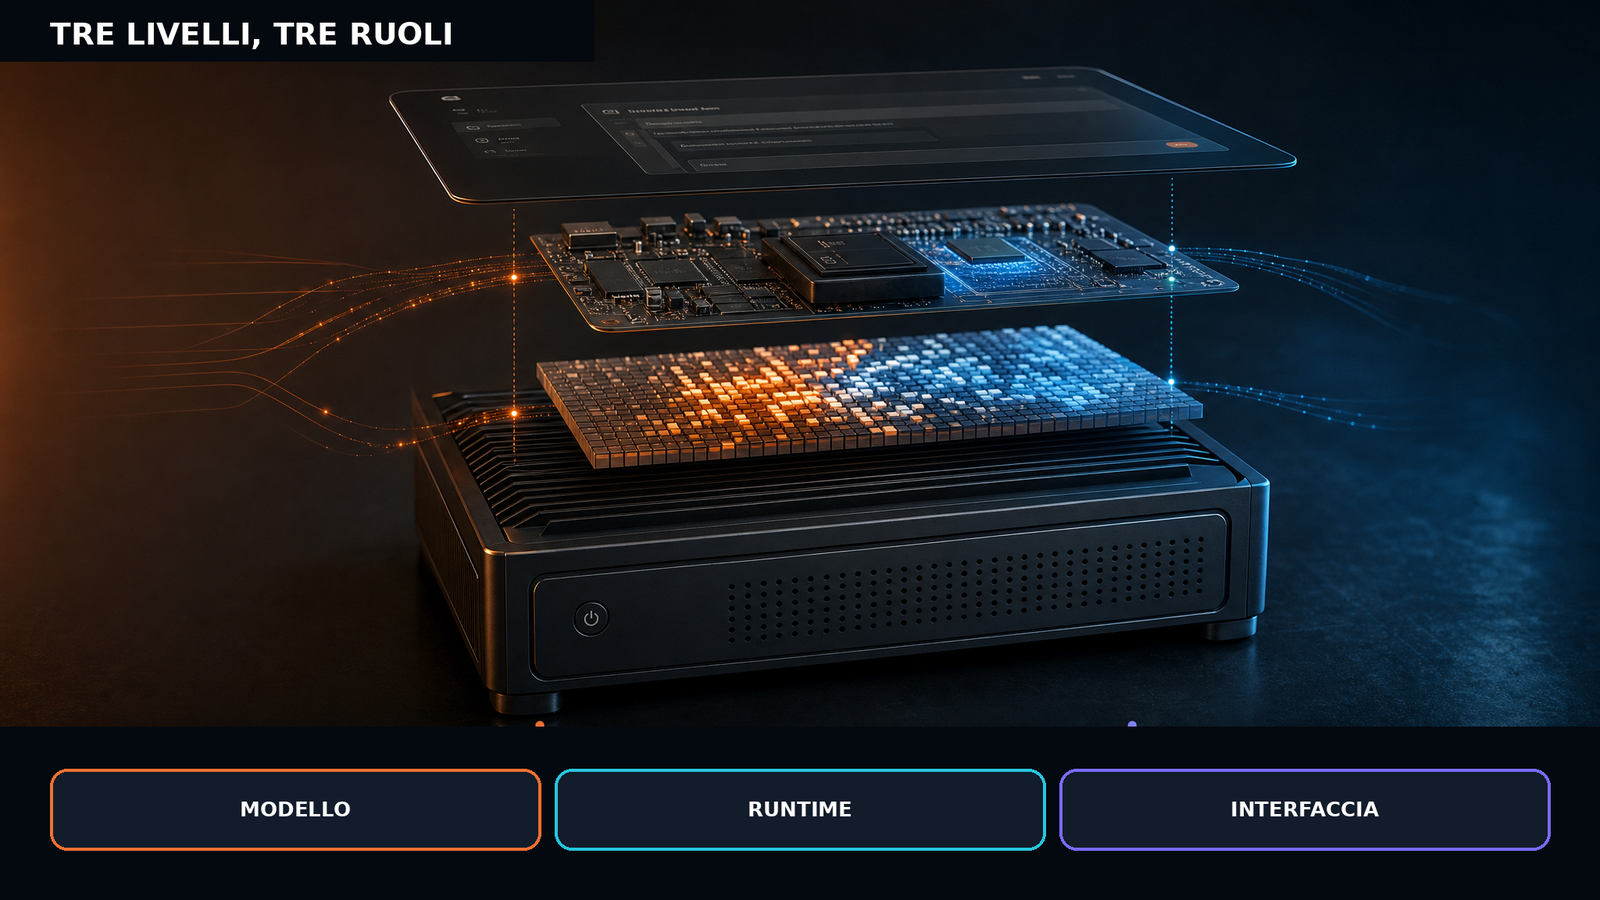
Il modello contiene i pesi; il runtime li esegue; l’interfaccia organizza chat e file; l’harness aggiunge strumenti, memoria e regole operative. Ollama semplifica download e servizio locale. llama.cpp offre controllo sui formati GGUF e sui parametri di inferenza. Open WebUI aggiunge un’interfaccia web. Hermes Agent e DeepSeek Harness trasformano il modello in un agente. Separare questi livelli evita di attribuire al modello un limite dell’interfaccia o una configurazione sbagliata del runtime.
6. Quantizzazione: partire dal task, non dalla sigla
Le sigle di quantizzazione non formano una classifica semplice. La documentazione di llama.cpp indica che ridurre la precisione restringe il file e può velocizzare l’inferenza, ma può introdurre perdita di accuratezza. FP8 è un formato distinto e il vantaggio dipende dal supporto effettivo dell’hardware e del software: per esempio, NVIDIA documenta il supporto FP8 dei Tensor Core H100. Confronta quindi qualità, memoria e velocità sul task reale; per coding, JSON e tool call, una risposta plausibile ma non parsabile resta un fallimento operativo.
7. Licenza e privacy: “locale” non basta
Controlla la licenza del checkpoint specifico, non soltanto il nome della famiglia: uso commerciale, modifica e redistribuzione possono avere condizioni diverse. Verifica anche la licenza dell’interfaccia e dei componenti collegati.
Locale migliora il controllo, ma non garantisce da solo la privacy dell’intero flusso. Interfacce, ricerca web, API esterne e modelli cloud possono introdurre trasferimenti remoti: la documentazione Ollama, per esempio, dichiara che i modelli cloud vengono eseguiti sul servizio Ollama. Per dati sensibili verifica quali componenti sono connessi, il traffico in uscita, i log, i permessi, le directory montate e la conservazione delle chat. OpenUI con Ollama può essere configurato local-first; la prova dedicata spiega limiti e punti da verificare.
8. Quando scegliere il cloud come fallback
Il cloud ha senso quando il modello non entra, il carico è raro, serve una capacità non disponibile localmente o vuoi evitare un acquisto hardware prima di validare il caso d’uso. Un flusso ibrido può usare il locale per bozze e dati controllati, poi un modello cloud per la revisione finale solo dopo aver rimosso informazioni riservate. Il costo corretto non è “API contro zero”: include hardware, energia, manutenzione, tempo e rischio operativo. Questa pagina non inventa un totale universale perché dipende dalla frequenza d’uso e dall’infrastruttura già posseduta.
La mia decisione, condizionata
Se avessi già hardware compatibile e dovessi gestire dati riservati, partirei locale con Ollama o llama.cpp, un contesto commisurato al task e un modello verificato sui miei prompt. Per agenti strutturati valuterei Qwen3.8 27B sulla base della prova pubblicata.
Se non avessi GPU, usassi il modello poche volte al mese o avessi bisogno di capacità elevate subito, partirei cloud e misurerei domanda e costi prima di comprare hardware. Se la privacy fosse il requisito dominante, bloccherei ogni fallback esterno e verificherei il traffico, non mi limiterei all’etichetta “locale”.
Domande frequenti
Quale modello AI locale scegliere per iniziare?
Scegli prima il task e il runtime. Parti da una quantizzazione compatibile, imposta un contesto realistico e prova prompt reali. Non esiste un modello migliore per chat, coding, strumenti e multimodalità insieme.
La dimensione del file indica quanta RAM serve?
No. Alla dimensione dei pesi devi aggiungere KV cache, buffer del runtime, contesto e memoria del sistema. La memoria effettiva va misurata durante l’esecuzione.
Un LLM locale funziona senza GPU?
Può funzionare su CPU, soprattutto con modelli piccoli o uso saltuario, ma la praticabilità dipende dal tempo di risposta richiesto. Questa guida non assegna velocità teoriche non misurate.
Ollama e Open WebUI sono modelli?
No. Ollama è un runtime/servizio per eseguire modelli; Open WebUI è un’interfaccia. Il modello è il checkpoint che scegli di caricare.
Un modello locale è sempre privato?
No. Devi controllare API, ricerca web, log, componenti connessi e modelli cloud. “Locale” descrive dove avviene l’inferenza principale, non certifica l’intero flusso.
Quando conviene il cloud?
Quando l’hardware non basta, l’uso è occasionale o serve una capacità subito. Puoi adottarlo come fallback, dopo aver definito quali dati possono uscire dalla macchina.
Fonti e riferimenti
Fonti primarie e approfondimenti utilizzati per verificare i concetti e le condizioni descritte nell’articolo.
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.