
L’ANALISI
GGUF in Transformers: cosa cambia davvero per l’AI locale
Transformers ora può eseguire GGUF riusando kernel llama.cpp. Analisi del perimetro iniziale, dei limiti e di come confrontarlo con llama.cpp.
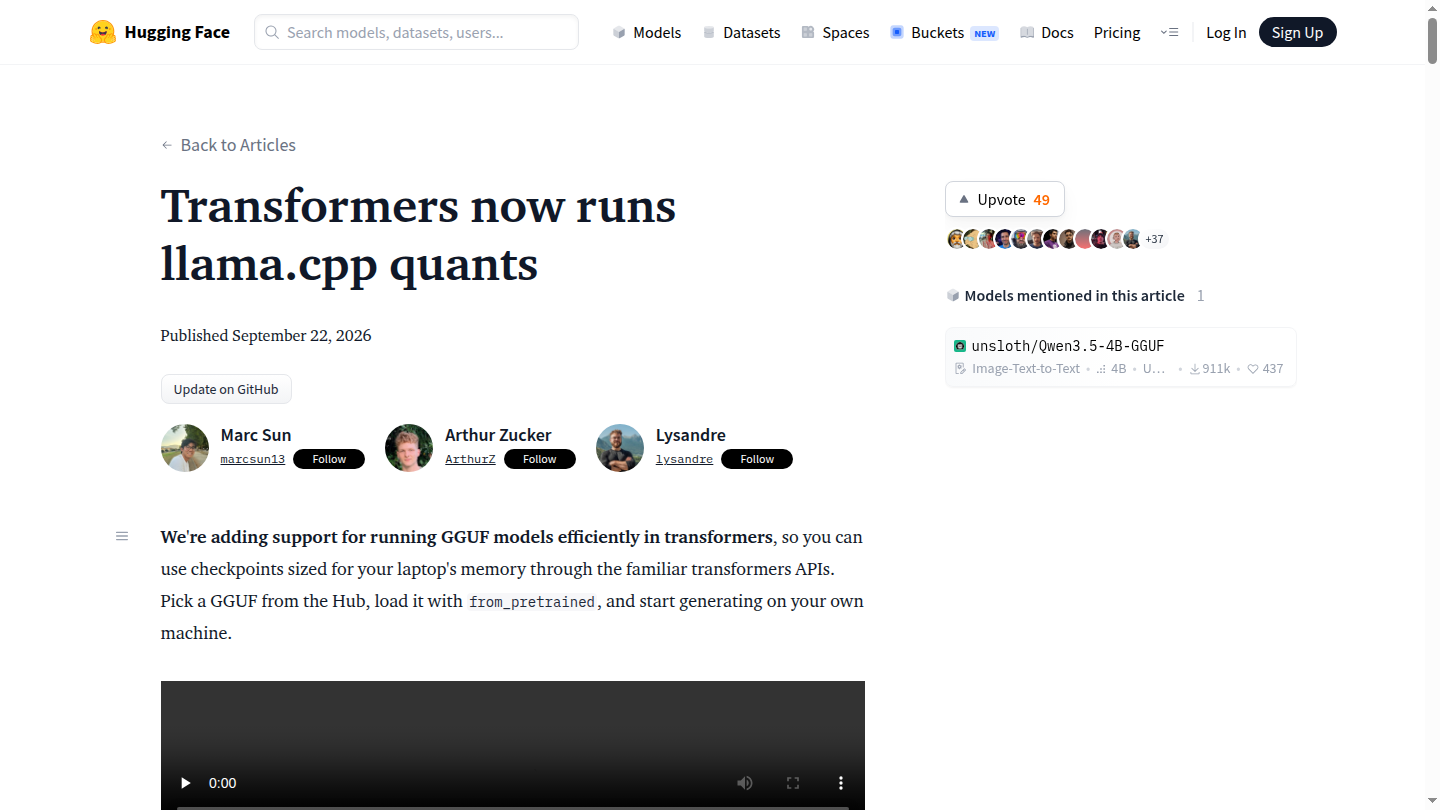
In breve: L’integrazione rende possibile usare checkpoint GGUF direttamente nel flusso Transformers senza convertirli in pesi PyTorch completi, riusando kernel ggml per l’esecuzione. È utile per prototipi Python su Apple Silicon, ma non sostituisce automaticamente llama.cpp: il primo perimetro dichiarato è Qwen3.5 e ogni modello va misurato.
Che cosa è cambiato
Il nuovo percorso carica un file GGUF dal Hub tramite from_pretrained e usa la libreria kernels per richiamare componenti ggml. A differenza del supporto GGUF già usato per dequantizzare e continuare training, qui l’obiettivo dichiarato è l’inferenza efficiente senza espandere l’intero checkpoint in memoria.
Perimetro iniziale
Hugging Face concentra la prima implementazione su Apple Silicon e sull’architettura Qwen3.5. Questo delimita la notizia: non tutte le architetture GGUF, le GPU o le funzioni del server llama.cpp risultano coperte nello stesso modo.
Perché può essere utile
Chi lavora già con tokenizer, pipeline e generate di Transformers può provare quantizzazioni locali senza cambiare completamente interfaccia. Il vantaggio operativo è l’integrazione nel codice Python; per applicazioni servite, tool multimodali o backend diversi, llama.cpp e i runtime specializzati restano confronti necessari.
Prestazioni e qualità
Hugging Face indica Q4_K_M come punto di partenza pratico e ricorda che quantizzazioni più aggressive riducono memoria ma possono cambiare la qualità. I risultati vanno verificati sul compito reale, mantenendo uguali prompt, contesto, sampling e versione del modello.
Checklist pratica
- Verificare che modello e architettura siano coperti dal percorso runtime, non solo leggibili dal loader GGUF.
- Registrare versione di Transformers, kernels, file GGUF e hash del checkpoint.
- Misurare tempo al primo token, token al secondo, memoria e qualità con prompt identici.
- Confrontare lo stesso GGUF con llama.cpp sul medesimo dispositivo.
- Provare chat template, stop token e batch usati dall’applicazione reale.
- Conservare il runtime precedente e un test minimo per il rollback.