
IL PUNTO SULL’AI
1 ottobre 2026
Cloudflare Clef porta decisioni multimodali tipizzate su pesi aperti e Workers AI, accanto ai nuovi artefatti K2-Horizon e Olmo-core 3.
In questa edizione 4 notizie
Google ha annunciato Gemini 4 Argon e avviato il rollout a un gruppo di cyber defender tramite Fairwind. Dichiara un limite di output da un milione di token e un prezzo introduttivo di 2 dollari per milione di token in input e 10 in output, ma l’accesso generale non è ancora aperto.
Limiti da conoscere
Limite: Benchmark, risparmi interni e risultati cyber sono dichiarazioni Google o dei partner citati. Non sono ancora disponibili accesso pubblico, model card completa o prove indipendenti sul comportamento reale, sui costi di traiettorie molto lunghe e sull’efficacia delle salvaguardie.
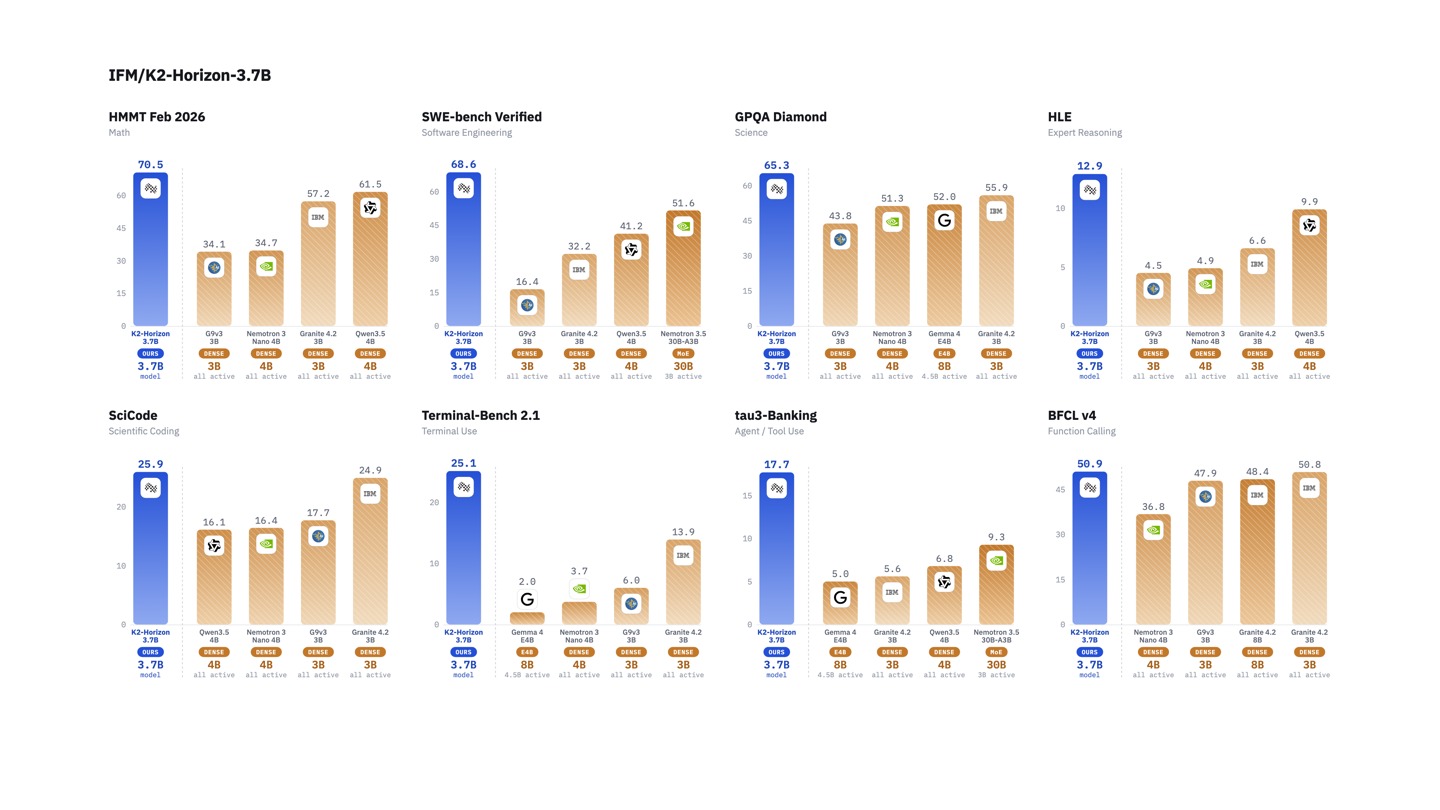
IFM ha completato la famiglia K2-Horizon con il modello denso 7B: 36 shard Safetensors, contesto nativo di 524.288 token, checkpoint intermedi e ricette documentate per vLLM e SGLang. È un delta separato dal 3.7B già coperto e dalle conversioni MLX della community.
Limiti da conoscere
Limite: I benchmark sono del produttore e BrowseComp usa un protocollo che può differire dalle baseline. La ricetta vLLM parte da 131.072 token, richiede trust-remote-code e non dimostra qualità, memoria o velocità sul contesto massimo; mancano ancora prove indipendenti in italiano.
Ai2 ha rilasciato Olmo-core 3, una revisione open source del framework di training con parallelismo dedicato ai mixture-of-experts. Nei test ufficiali su otto NVIDIA B300, il nuovo stack dichiara 52.000 token al secondo per GPU contro 19.400 della precedente implementazione.
Limiti da conoscere
Limite: Prestazioni e scalabilità sono misure del produttore su hardware B300 difficilmente accessibile. Il rilascio rende codice e ricette ispezionabili, ma non dimostra lo stesso vantaggio su cluster più piccoli, GPU diverse o workload reali.
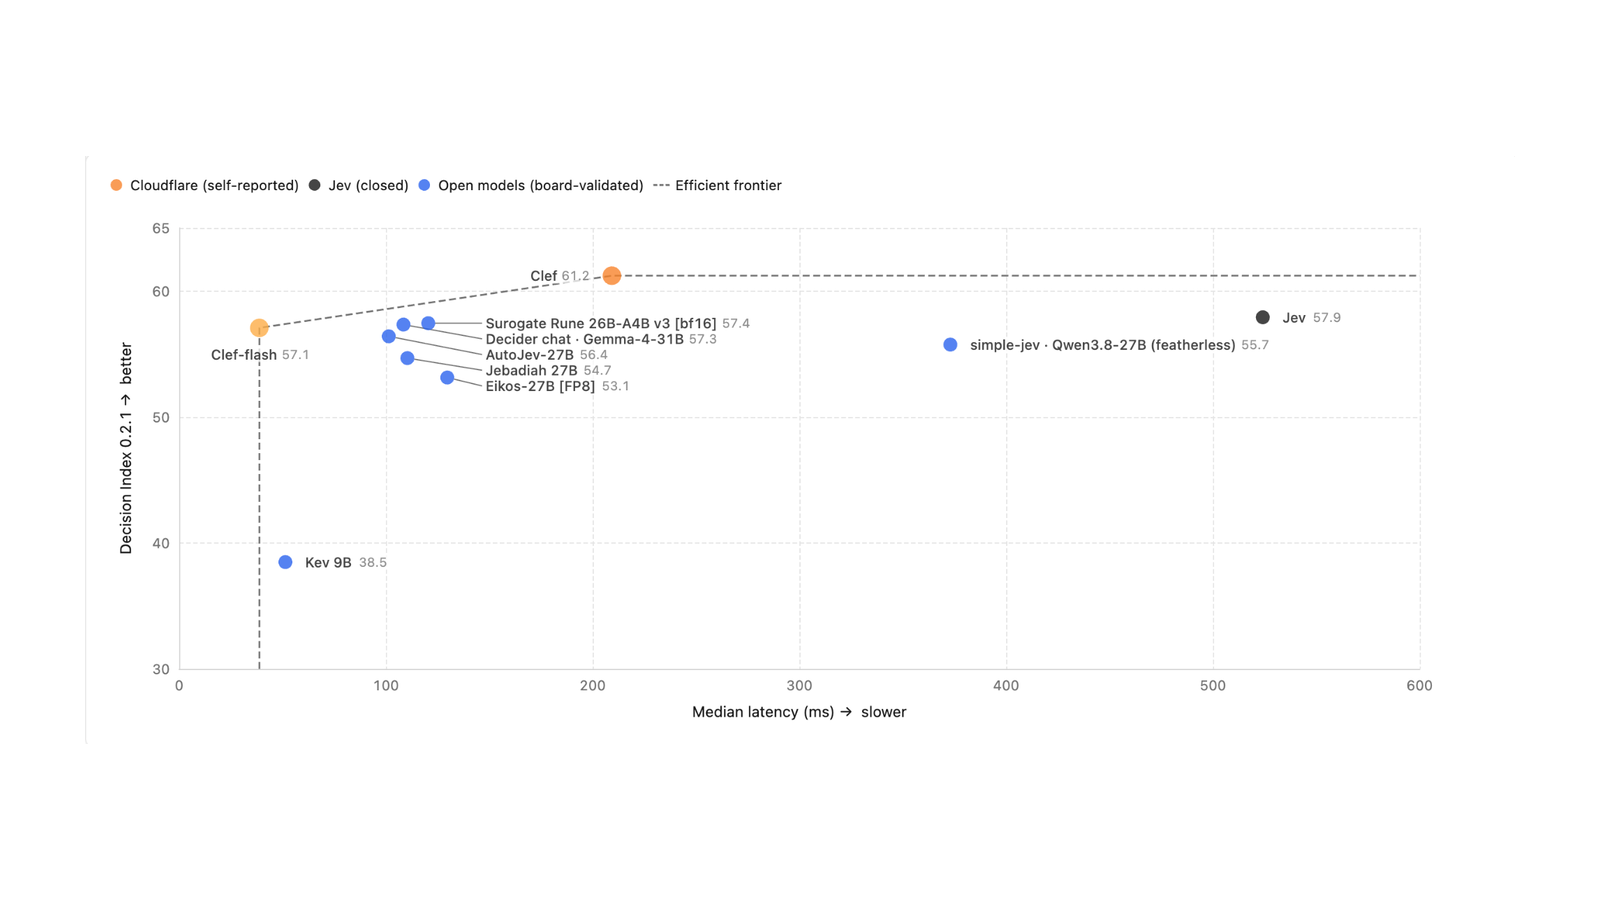
Cloudflare ha rilasciato Clef 27B e Clef-Flash 9B: modelli multimodali che valutano domande tipizzate e restituiscono probabilità senza generare testo. I pesi Apache-2.0 sono scaricabili da Hugging Face e gli stessi modelli sono disponibili su Workers AI con API compatibile Jev/SystemOne.
Limiti da conoscere
Limite: I benchmark e i confronti di latenza sono eseguiti dal produttore. La model card locale indica test su una singola H200 e non dimostra calibrazione, costi o affidabilità sul proprio dominio; una probabilità del modello non sostituisce policy e approvazioni per azioni sensibili.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.