
L’ANALISI
Ling 3.0 VL in llama.cpp: cosa verificare nella build b11156
La build b11156 porta Ling 3.0 VL in llama.cpp. Analisi del supporto iniziale, degli artefatti disponibili e del test locale da eseguire.
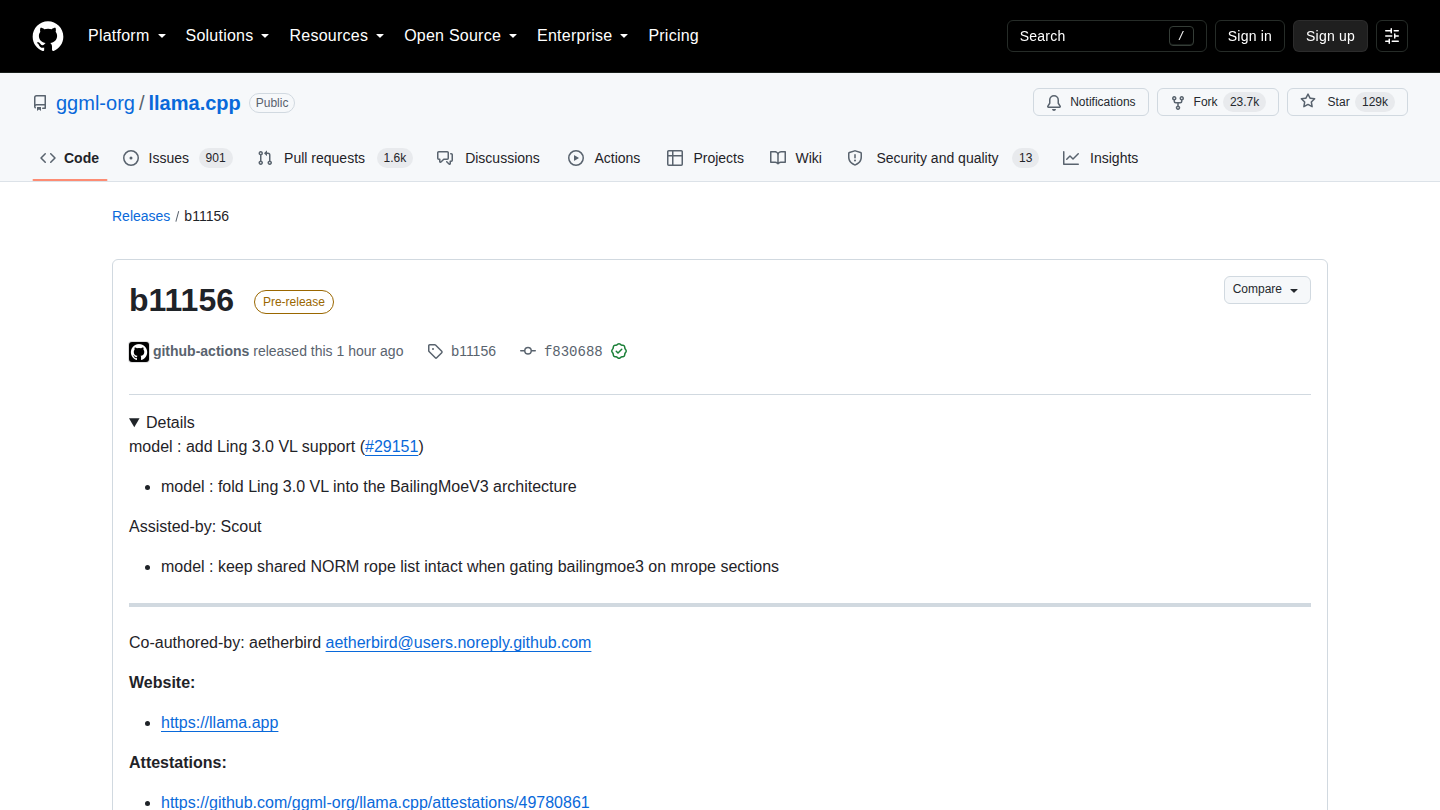
In breve: La build b11156 aggiunge a llama.cpp il riconoscimento di Ling 3.0 VL dentro l’architettura BailingMoeV3 e distribuisce binari per i principali sistemi desktop e mobile. È un delta pratico per chi vuole provare il modello in locale, ma resta una pre-release senza benchmark ufficiali: prima dell’uso reale vanno verificati template, input visivi, memoria e backend.
Che cosa cambia nella build
Il commit incluso nella pre-release aggiunge Ling 3.0 VL e lo riconduce all’implementazione BailingMoeV3. Una seconda correzione conserva la lista NORM e RoPE condivisa quando la configurazione usa sezioni mRoPE, un dettaglio rilevante per la componente visiva e il posizionamento multimodale.
Dove si può provare
La pagina della build offre artefatti per macOS Apple Silicon e Intel, Linux CPU e diversi backend accelerati, Windows, Android e iOS. La disponibilità del binario riduce il lavoro iniziale, ma non dimostra da sola che il percorso visione-linguaggio sia equivalente su ogni piattaforma.
Perché è un delta pratico
Il supporto nel runtime cambia ciò che si può eseguire oggi: un checkpoint Ling 3.0 VL compatibile può essere portato nel flusso GGUF di llama.cpp senza attendere un’integrazione separata. Per applicazioni locali significa poter misurare OCR, descrizione immagini e dialogo visuale nello stesso stack già usato per altri modelli.
Limiti e condizioni
La release è marcata come pre-release ed è generata automaticamente. Non contiene misure di accuratezza, throughput o memoria, né una matrice di test multimodali per backend. Il risultato va quindi trattato come supporto iniziale da qualificare, non come compatibilità produttiva già dimostrata.
Checklist pratica
- Scaricare l’artefatto b11156 adatto al backend e conservarne nome e checksum.
- Usare un checkpoint GGUF Ling 3.0 VL dichiarato compatibile e registrare il relativo commit o hash.
- Provare almeno un’immagine semplice, un documento con testo e un caso con più dettagli visivi.
- Verificare chat template, token immagine, mRoPE e arresto della generazione.
- Misurare memoria, tempo di prompt e token al secondo sul dispositivo reale.
- Confrontare l’output con il runtime di riferimento e mantenere una build precedente per il rollback.