
L’ANALISI
llama.cpp b11160 su AMD RDNA: come provare il nuovo matmul Vulkan int8
La build b11160 introduce matmul quantizzato Vulkan int8 per AMD RDNA 3 e RDNA 4. Formati supportati, limiti e protocollo di verifica.
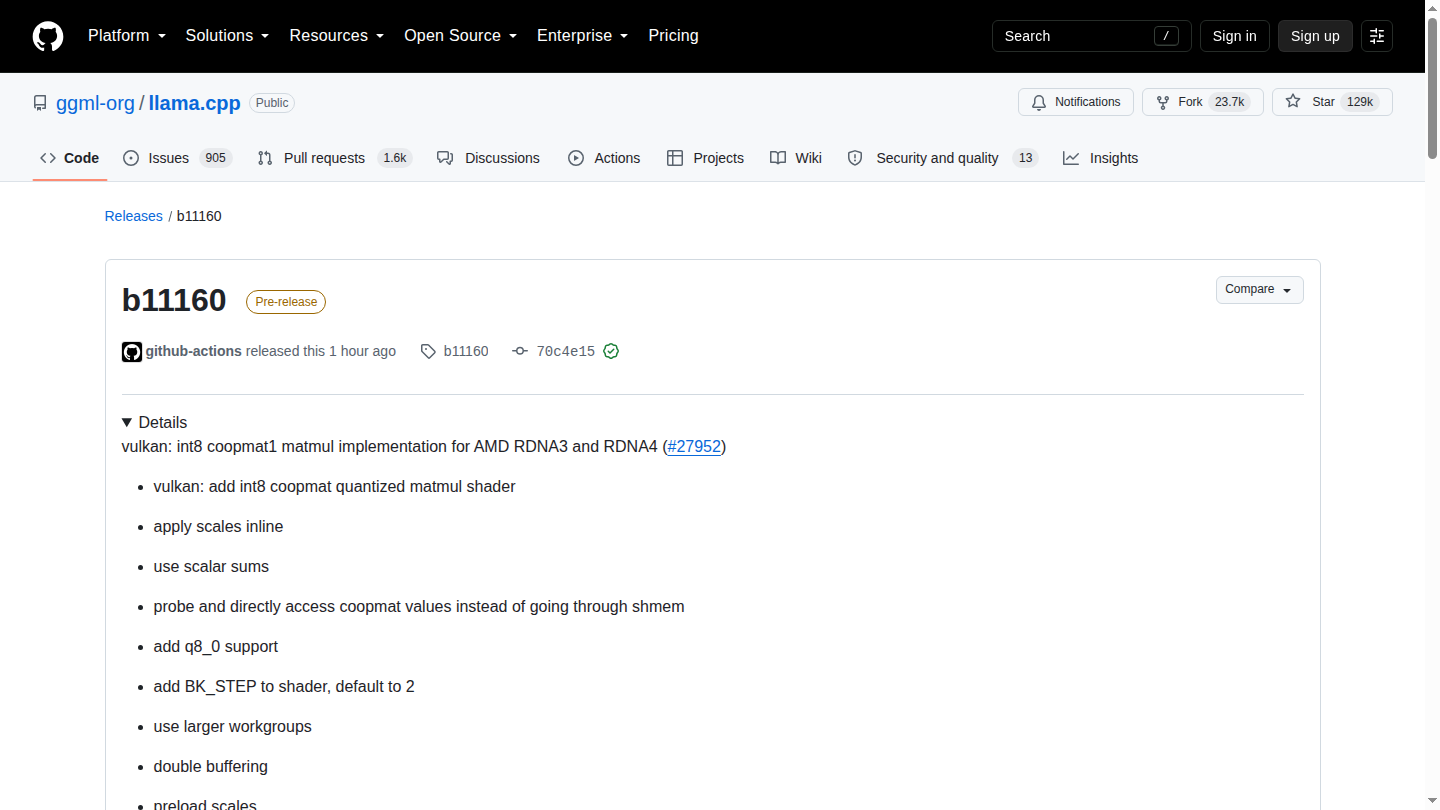
In breve: Il delta pratico è un nuovo shader Vulkan cooperative-matrix per il matmul quantizzato int8, limitato nel changelog ad AMD RDNA 3 e RDNA 4. La build elenca supporto per diverse quantizzazioni e offre pacchetti Vulkan per Linux e Windows, ma non fornisce benchmark pubblici: il vantaggio va misurato sulla propria GPU contro una build precedente.
Che cosa cambia nel backend Vulkan
b11160 introduce uno shader matmul quantizzato int8 che usa cooperative matrix sulle architetture AMD RDNA 3 e RDNA 4. Il lavoro comprende caricamento diretto dei valori, applicazione inline delle scale, wave32, double buffering e scheduling orientato alla prossimità della cache.
Quali quantizzazioni risultano coperte
Il changelog cita Q8_0, Q4_1, Q5_0, Q5_1, IQ4_NL, MXFP4, Q3_K, Q4_K, Q5_K, Q6_K, NVFP4 e IQ4_XS. La presenza nell’implementazione non significa che ogni formato abbia lo stesso profilo prestazionale: modello e quantizzazione devono essere registrati nel test.
Che cosa si può scaricare oggi
La pagina della release offre build Vulkan x64 per Ubuntu e Windows, oltre agli altri backend. Questo consente di provare il percorso senza compilare il progetto, conservando comunque il pacchetto della build precedente per un confronto e un rollback immediati.
Limiti e condizioni
b11160 è marcata pre-release e il changelog non include GPU, driver, modelli, token al secondo o consumo di memoria. Il percorso è dichiaratamente limitato a RDNA 3 e RDNA 4; risultati osservati su una scheda non vanno generalizzati a tutte le GPU AMD o ad altri backend.
Checklist pratica
- Identificare modello GPU, architettura RDNA e versione del driver Vulkan.
- Scaricare la build Vulkan b11160 e verificare nome e checksum del pacchetto.
- Conservare una build precedente funzionante per confronto e rollback.
- Usare lo stesso GGUF, quantizzazione, contesto, batch e prompt in entrambi i test.
- Registrare prompt processing, token al secondo, memoria VRAM, consumi e crash.
- Ripetere il test per almeno tre esecuzioni dopo il warm-up.
- Controllare l’output del runtime per verificare che il backend Vulkan e il nuovo percorso siano realmente attivi.