
L’ANALISI
llama.cpp 0.5.0: cosa cambia e come provarlo senza regressioni
La release 0.5.0 estende modelli, backend e server. Ecco i cambiamenti verificabili, i limiti e una checklist pre e post upgrade.
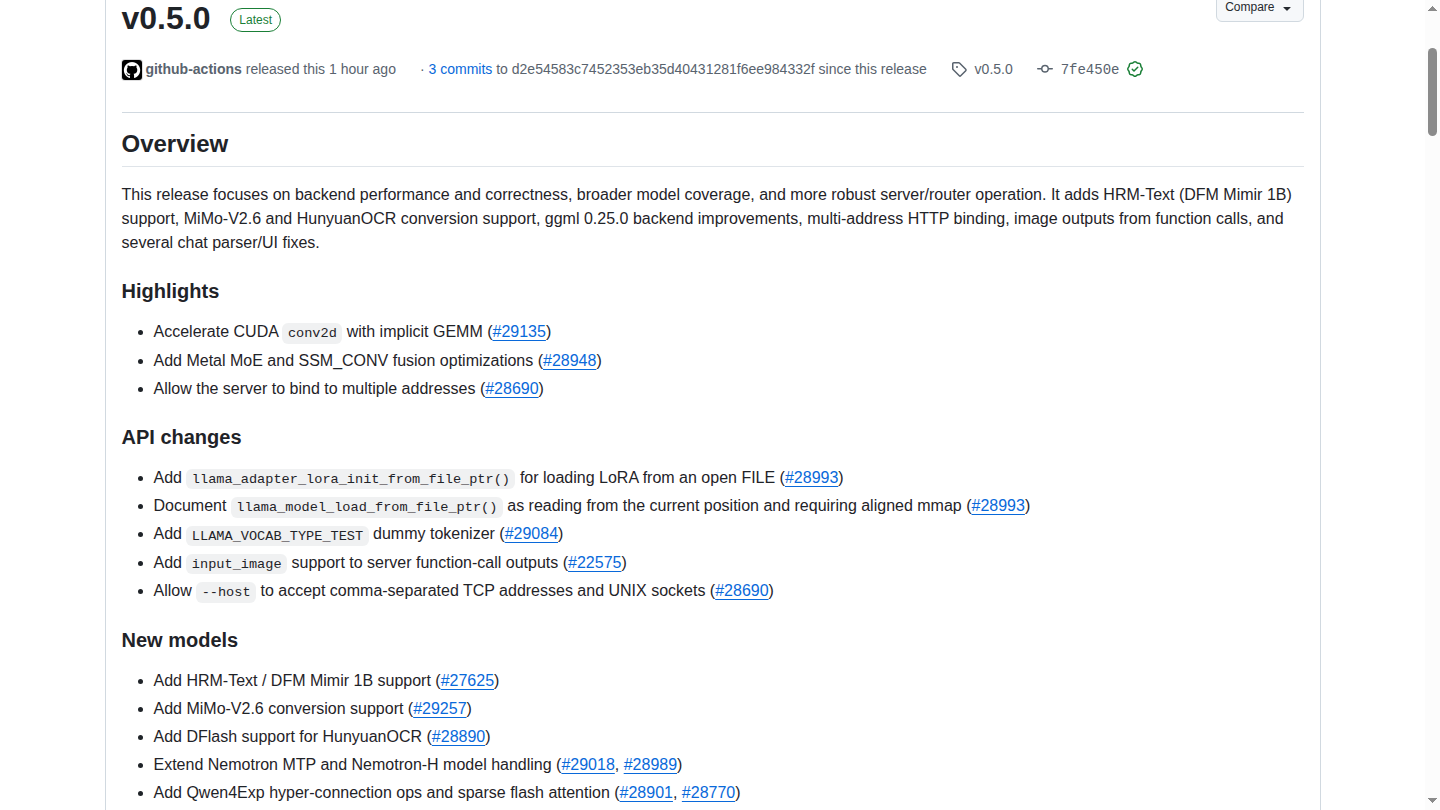
In breve: llama.cpp 0.5.0 è un aggiornamento operativo rilevante perché combina supporto a nuovi modelli, correzioni del server e modifiche trasversali ai backend. Conviene aggiornare solo dopo un test ripetibile: la release non dimostra che ogni configurazione diventi più veloce o stabile.
Che cosa porta la release
La versione 0.5.0 raggruppa supporto per HRM-Text, conversione MiMo-V2.6 e HunyuanOCR, estensioni Nemotron e operazioni per Qwen4Exp. Il valore pratico dipende dalla combinazione di modello e backend, quindi il numero di modifiche non è una misura di prestazione.
Server e API da ricontrollare
Il server può ascoltare su più indirizzi TCP o socket UNIX, accetta contenuti OpenAI-compatible video_url e data URI video e gestisce immagini negli output delle function call. Sono cambiamenti utili, ma ampliano anche la superficie da verificare per autenticazione, routing e compatibilità client.
Backend: ottimizzazioni non universali
Le note includono conv2d CUDA via implicit GEMM, fusioni Metal, AllReduce ROCm, kernel Vulkan e OpenCL, oltre a interventi SYCL e Hexagon. Ogni percorso ha prerequisiti diversi: un guadagno dichiarato su un kernel non implica un miglioramento per qualsiasi modello o dispositivo.
Correzioni di robustezza
La release corregge race nell’eviction del router, gestione dei processi figli, controlli multimodali e overflow dei buffer SigLIP per immagini molto alte o larghe. Chi usa il server in produzione deve testare concorrenza, riavvii, tool call e input multimodali, non soltanto i token al secondo.
Checklist pratica
- Salvare commit, build flags, driver, modello, quantizzazione e parametri della versione attuale.
- Eseguire llama-bench prima e dopo con prompt, batch, context e thread identici.
- Provare avvio, streaming, tool call, JSON schema e arresto del server.
- Verificare i binding multipli e non esporre indirizzi o socket non necessari.
- Testare immagini e video solo se fanno parte del flusso reale.
- Controllare RAM, VRAM, latenza iniziale, throughput e qualità dell’output.
- Conservare binario e configurazione precedenti per un rollback immediato.