
L’ANALISI
Google Antigravity con Gemma 4 locale: requisiti e limiti dell’SDK
Antigravity SDK supporta Gemma 4 26B A4B locale tramite LiteRT-LM e server OpenAI-compatible. Requisiti, demo ibrida e limiti dell’offline.
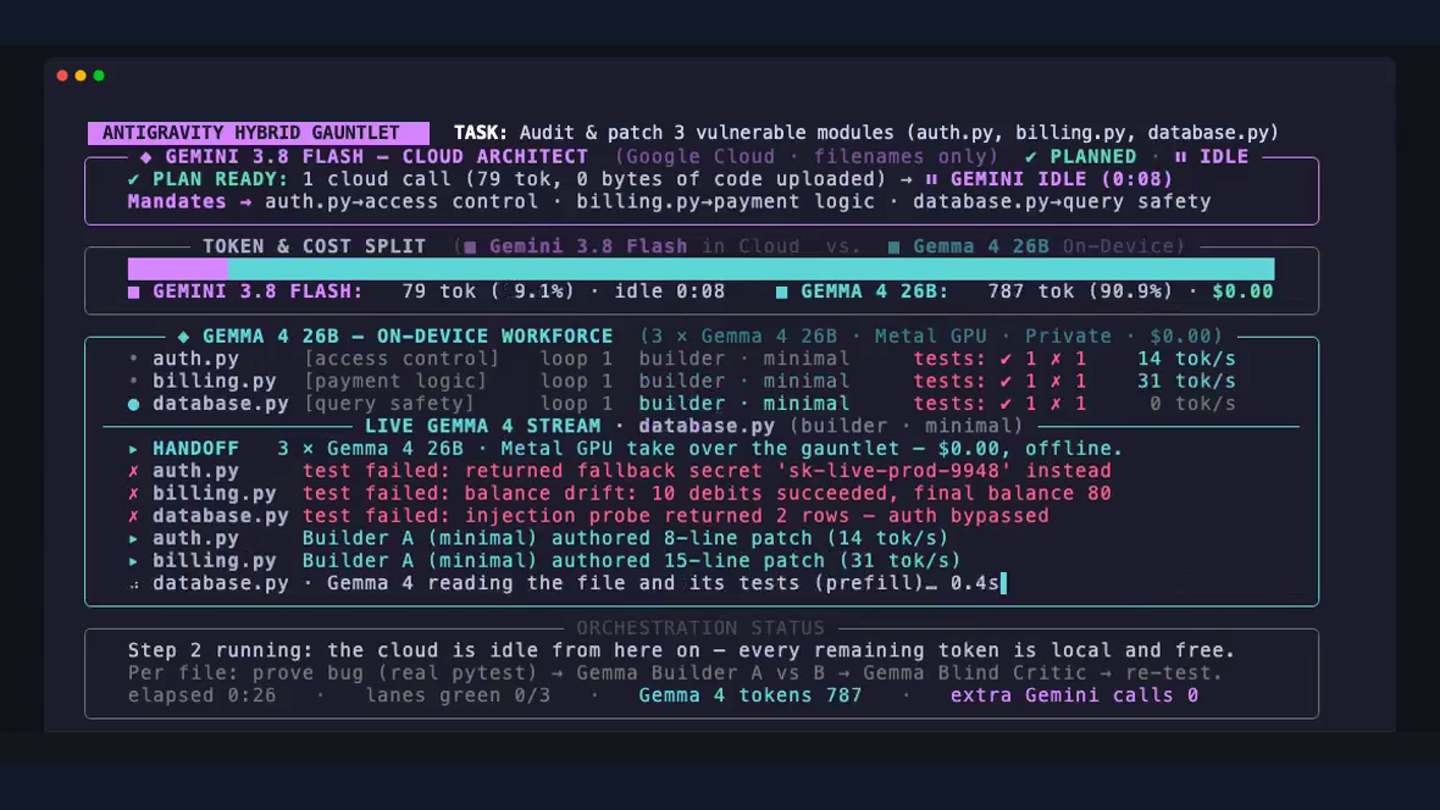
In breve: Il supporto è reale e già disponibile nel pacchetto Python google-antigravity. Il percorso LiteRT-LM raccomandato usa Gemma 4 26B A4B e almeno 24 GB di VRAM o memoria unificata; in alternativa l’SDK può collegarsi a server locali OpenAI-compatible. “Offline” vale per inferenza e orchestrazione già installate, non automaticamente per ogni funzione, tool o servizio esterno.
Che cosa è disponibile
L’SDK è pubblico come pacchetto Python google-antigravity e richiede Python 3.10 o successivo. Il repository è Apache 2.0, ma il runtime compilato viene distribuito nelle wheel PyPI: il clone del repository da solo non sostituisce l’installazione del pacchetto.
Il percorso LiteRT-LM
L’integrazione raccomandata usa gemma-4-26B-A4B-it-gpu.litertlm. Google indica almeno 24 GB di VRAM o memoria unificata e un contesto da 64K. Altri file .litertlm possono funzionare, ma il README avverte che oggi questo checkpoint è il percorso meglio supportato.
Ollama, LM Studio e vLLM
LocalOpenAIAgentConfig consente di usare server locali compatibili con l’API OpenAI, inclusi Ollama, LM Studio e vLLM. Questo amplia la scelta del runtime, ma compatibilità, tool calling e qualità dipendono dal modello e dalla configurazione.
Che cosa mostra la demo ibrida
La demo ufficiale usa Gemini 3.8 Flash per pianificare nel cloud senza ricevere il codice sorgente e Gemma 4 26B per audit, patch e verifica in locale. Il video mostra 3.321 token locali, costo API dichiarato di 0 dollari e 97,7% dei token elaborati localmente; il blog riporta 3.322 token e 97,2%. Sono risultati della demo del fornitore, non una replica indipendente.
Limiti dell’offline
Il supporto riguarda l’SDK Python, non tutte le funzioni dell’app Antigravity. Installazione e download iniziali richiedono rete; anche tool, MCP e API esterne possono uscire dal dispositivo. La conversione LiteRT-LM indicata è text-only: immagini, audio e multi-token prediction sono annunciati per aggiornamenti futuri.
Checklist pratica
- Verificare GPU o memoria unificata disponibile: Google raccomanda almeno 24 GB.
- Scaricare pacchetto, runtime e checkpoint prima del test offline.
- Provare il flusso senza rete e monitorare le connessioni in uscita.
- Registrare modello, quantizzazione, contesto, RAM/VRAM e token al secondo.
- Eseguire il test in una workspace isolata e revisionare ogni patch.
- Separare inferenza locale da tool, MCP e API che richiedono servizi remoti.
- Confrontare qualità, tempi e consumo con lo stesso task su un modello cloud.