
IL PUNTO SULL’AI
15 ottobre 2026
K2-Horizon aggiunge GGUF per quattro taglie, mentre Matrix-Game 4.0 separa fisica e rendering neurale.
In questa edizione 13 notizie
IBM ha aggiornato la Granite RAG Library con sei adapter LoRA per query rewrite, chiarimento, rilevanza del contesto, answerability, rilevamento delle allucinazioni e citazioni. Il repository include varianti per Granite 4.0 Micro e Granite 4.1 da 3B, 8B e 30B, quattro versioni aLoRA, file Safetensors e GGUF, Modelfile e script per Ollama e vLLM.
Limiti da conoscere
Limite: Le accuratezze e i confronti sono misure pubblicate dal team IBM su dataset e prompt propri. La model card avverte che i prompt dei decision model non sono stati ottimizzati per questi compiti; inoltre l’integrazione locale richiede di abbinare correttamente adapter, modello base e runtime.
StepFun ha reso pubblico e non gated il repository ufficiale BF16 di Step 5 Preview, il modello MoE da 600B parametri totali e 27B attivi annunciato il 20 settembre. Sono disponibili 24 shard principali, pesi per visione e multi-token prediction, codice di inferenza e istruzioni per vLLM, SGLang e Transformers.
Limiti da conoscere
Limite: Open weight non significa modello leggero né licenza permissiva: la scheda usa una licenza StepFun personalizzata. Il deployment FP8 indicato richiede quattro GPU B300 su un nodo; i benchmark restano dichiarazioni del produttore e non sono stati riprodotti in questo aggiornamento.
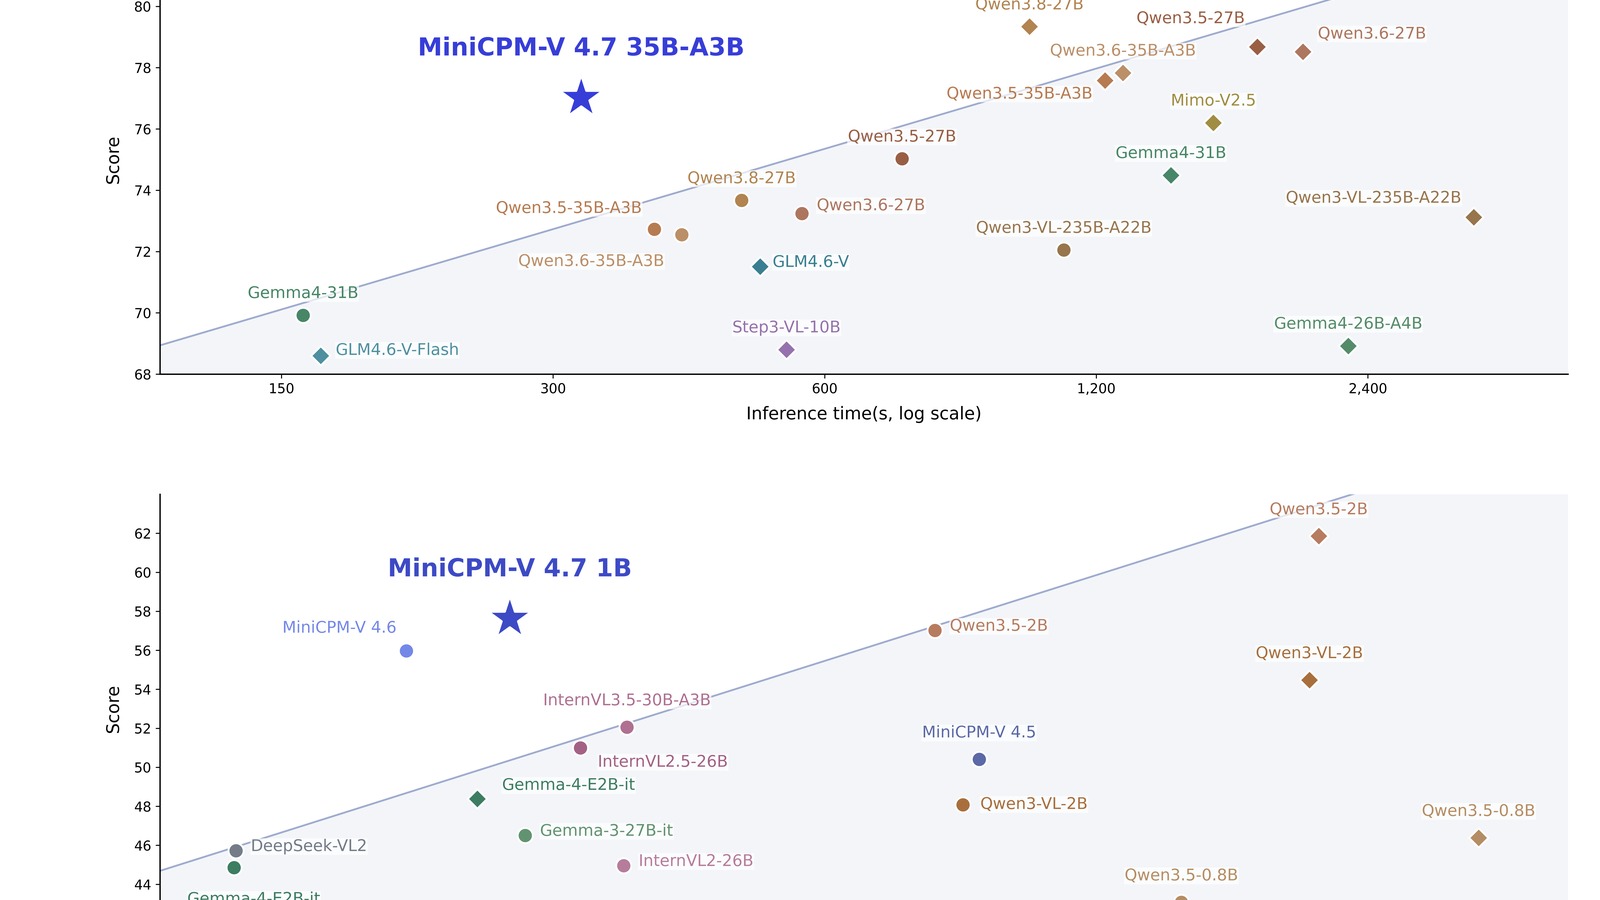
OpenBMB ha pubblicato i draft checkpoint DSpark BF16 per MiniCPM-V 4.7 1B e 35B-A3B, addestrati per l’abbinamento esatto con modello target e tokenizer. Entrambi propongono fino a 15 token speculativi per passaggio e includono ricette vLLM; per il 35B-A3B sono disponibili anche GGUF e comandi llama.cpp.
Limiti da conoscere
Limite: I valori di acceptance length sono misure dichiarate da OpenBMB, non benchmark indipendenti, e non equivalgono direttamente a un aumento di token al secondo. Ogni draft funziona solo con il target MiniCPM-V corrispondente; il percorso llama.cpp richiede una build con architettura dflash e DSpark Markov head.
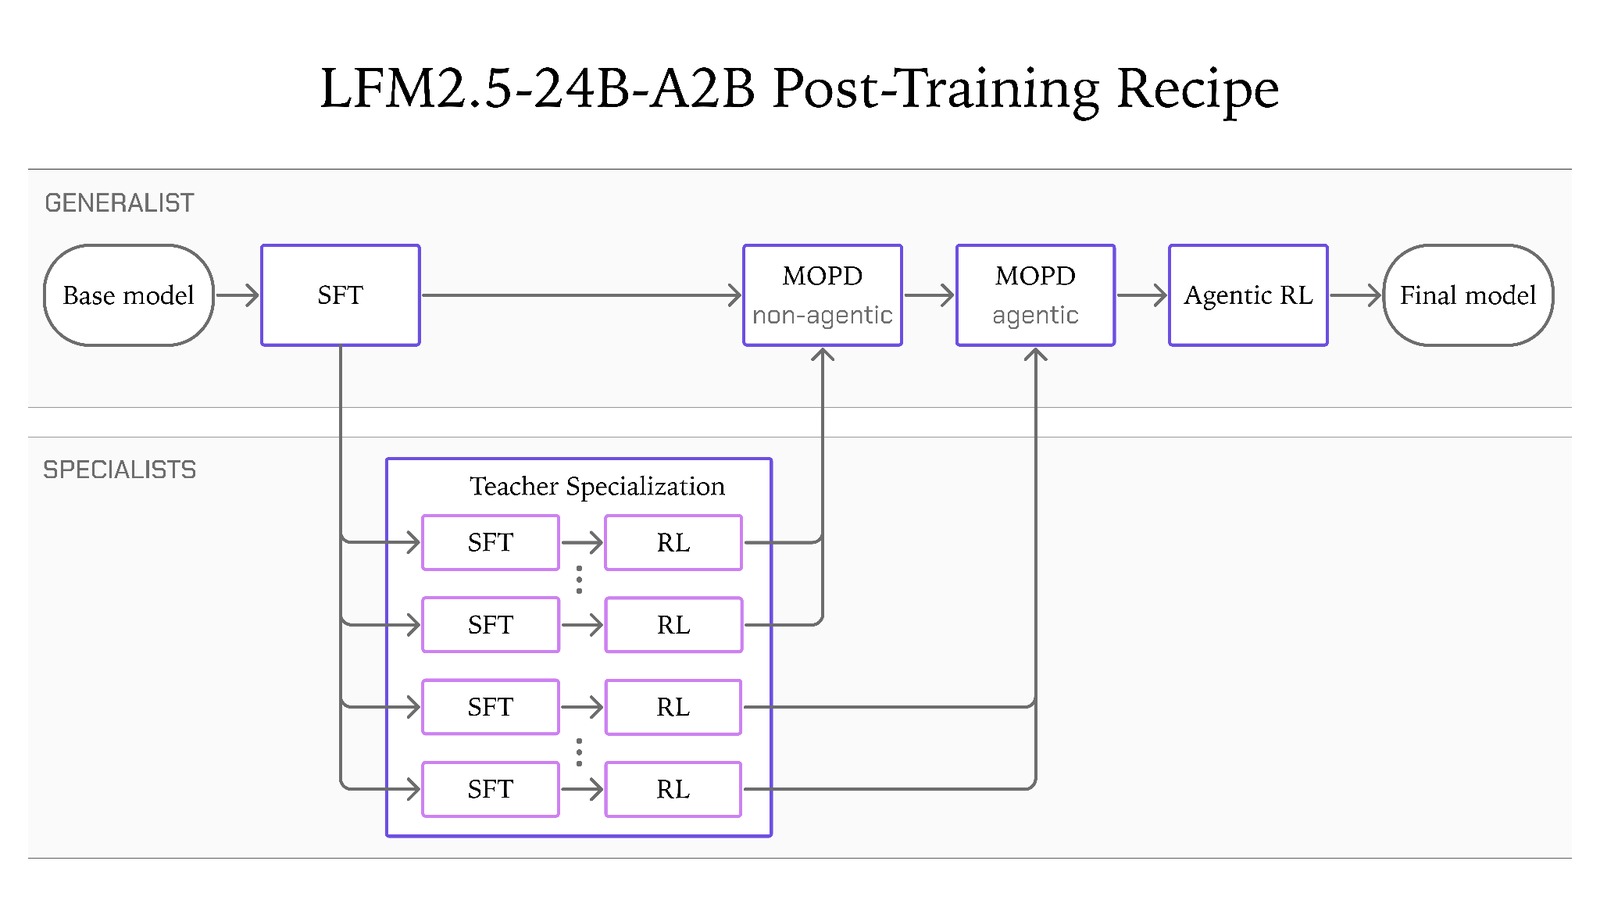
Liquid AI ha rilasciato LFM2.5-24B-A2B, un MoE open-weight da 24 miliardi di parametri totali e 2 miliardi attivi, con contesto fino a 131.072 token. I pesi base e post-trained sono disponibili, insieme a percorsi per llama.cpp, MLX, vLLM, SGLang e ONNX; il training agentico cita anche Hermes Agent, OpenClaw, Pi e OpenCode.
Limiti da conoscere
Limite: Velocità e benchmark sono misure del produttore, non test indipendenti. I 184 token/s su Apple M5 Max e 114 token/s su AMD Ryzen AI Max+ 395 usano quantizzazione Q4_K_M e contesto di input da 4K; sul coding dichiarato il modello resta sotto Qwen3.6-35B-A3B in SWE-Bench Verified. La licenza LFM va verificata per il proprio uso.
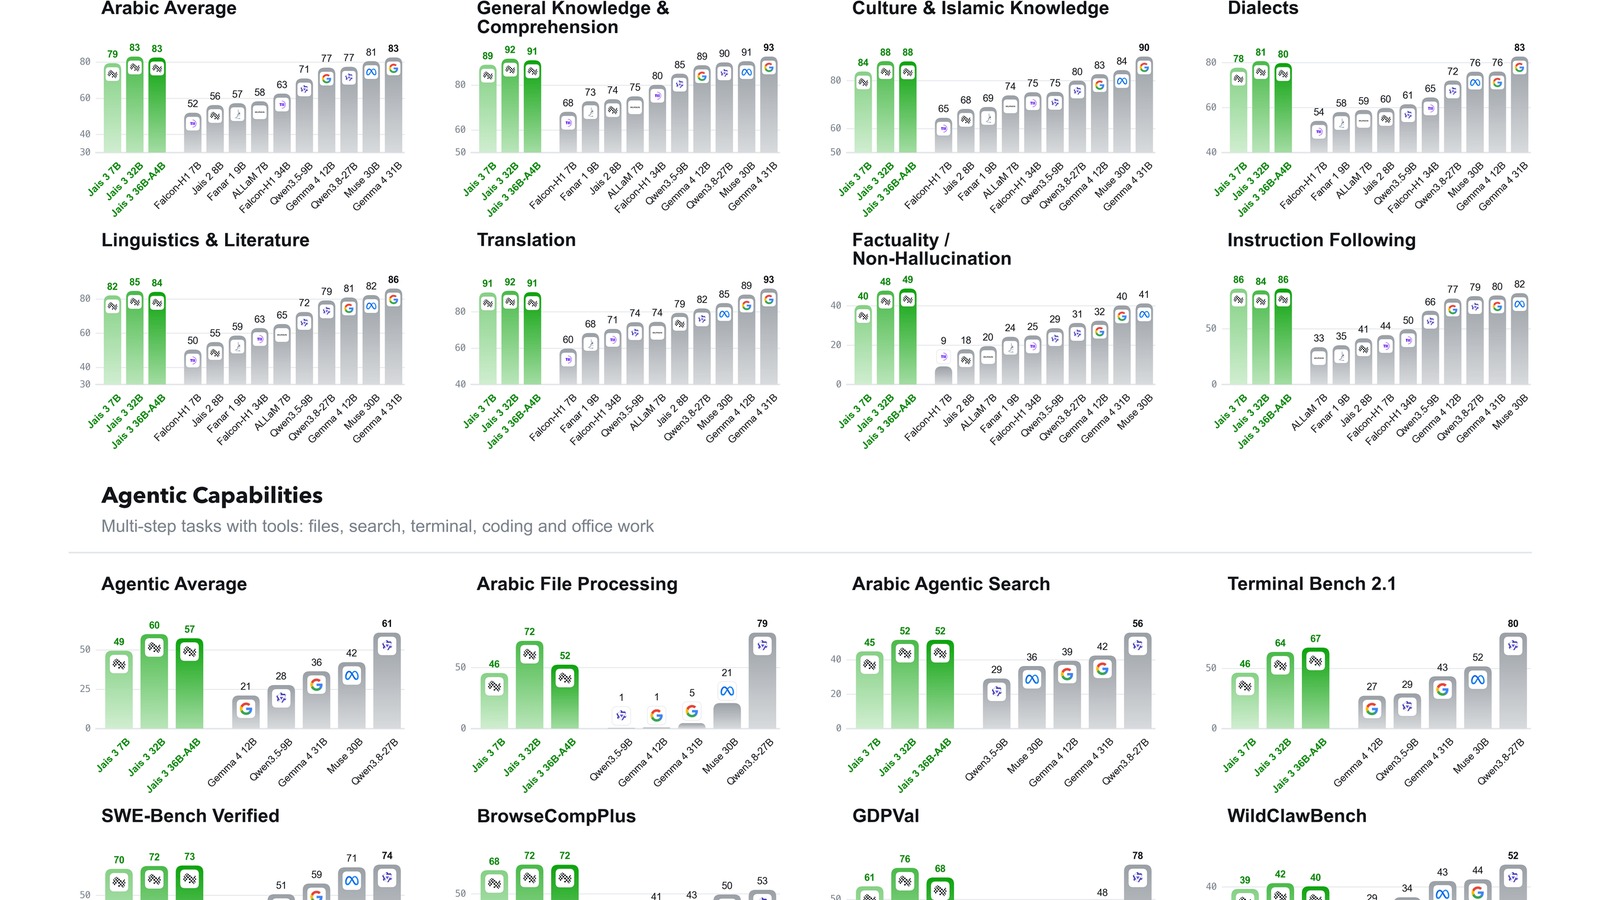
IFM ha pubblicato Jais 3, una famiglia di sei modelli arabo-inglesi open weight da 0,9B a 375B parametri. Sono disponibili pesi, checkpoint, formati GGUF e MLX, ricette per vLLM e SGLang e una finestra fino a 512K token; i modelli sono addestrati anche per tool use, MCP e lavoro su file.
Limiti da conoscere
Limite: Prestazioni e confronti arrivano dal produttore e non sono ancora prove indipendenti. Il modello 375B richiede un nodo multi-GPU, mentre anche le varianti 32B e 36B richiedono hardware importante; 512K indica la finestra dichiarata, non qualità uniforme su tutto il contesto. Il report tecnico e il repository del codice risultano ancora indicati come in arrivo.
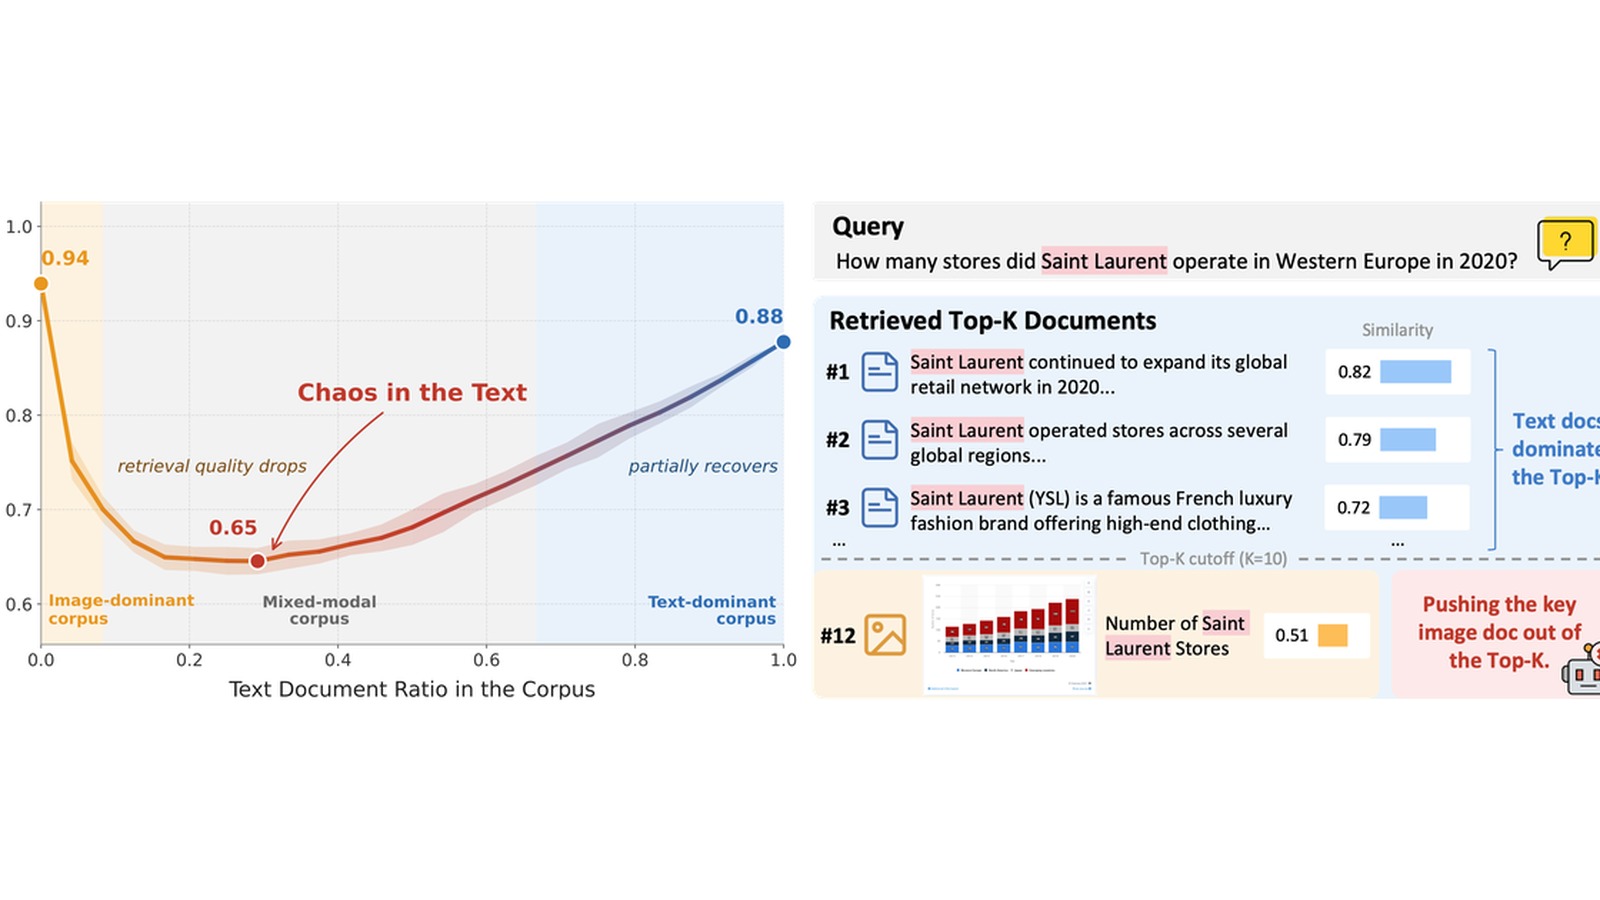
OpenBMB ha pubblicato i pesi BF16 di Trident-Qwen3VL-2B, insieme a codice, dati di training ed evaluation per retrieval su corpus misti. Il modello produce embedding confrontabili per testo, immagini e documenti fusi, con adapter LoRA già integrato e una procedura riproducibile per misurare il divario tra corpus originali e multimodali.
Limiti da conoscere
Limite: I risultati arrivano dagli autori e non sono stati riprodotti in questo aggiornamento. Il quickstart richiede CUDA, il training dichiarato usa otto A100 da 80 GB e immagini, query e annotazioni derivate conservano le licenze dei dataset originali. La scheda non indica un provider di inferenza gestito.
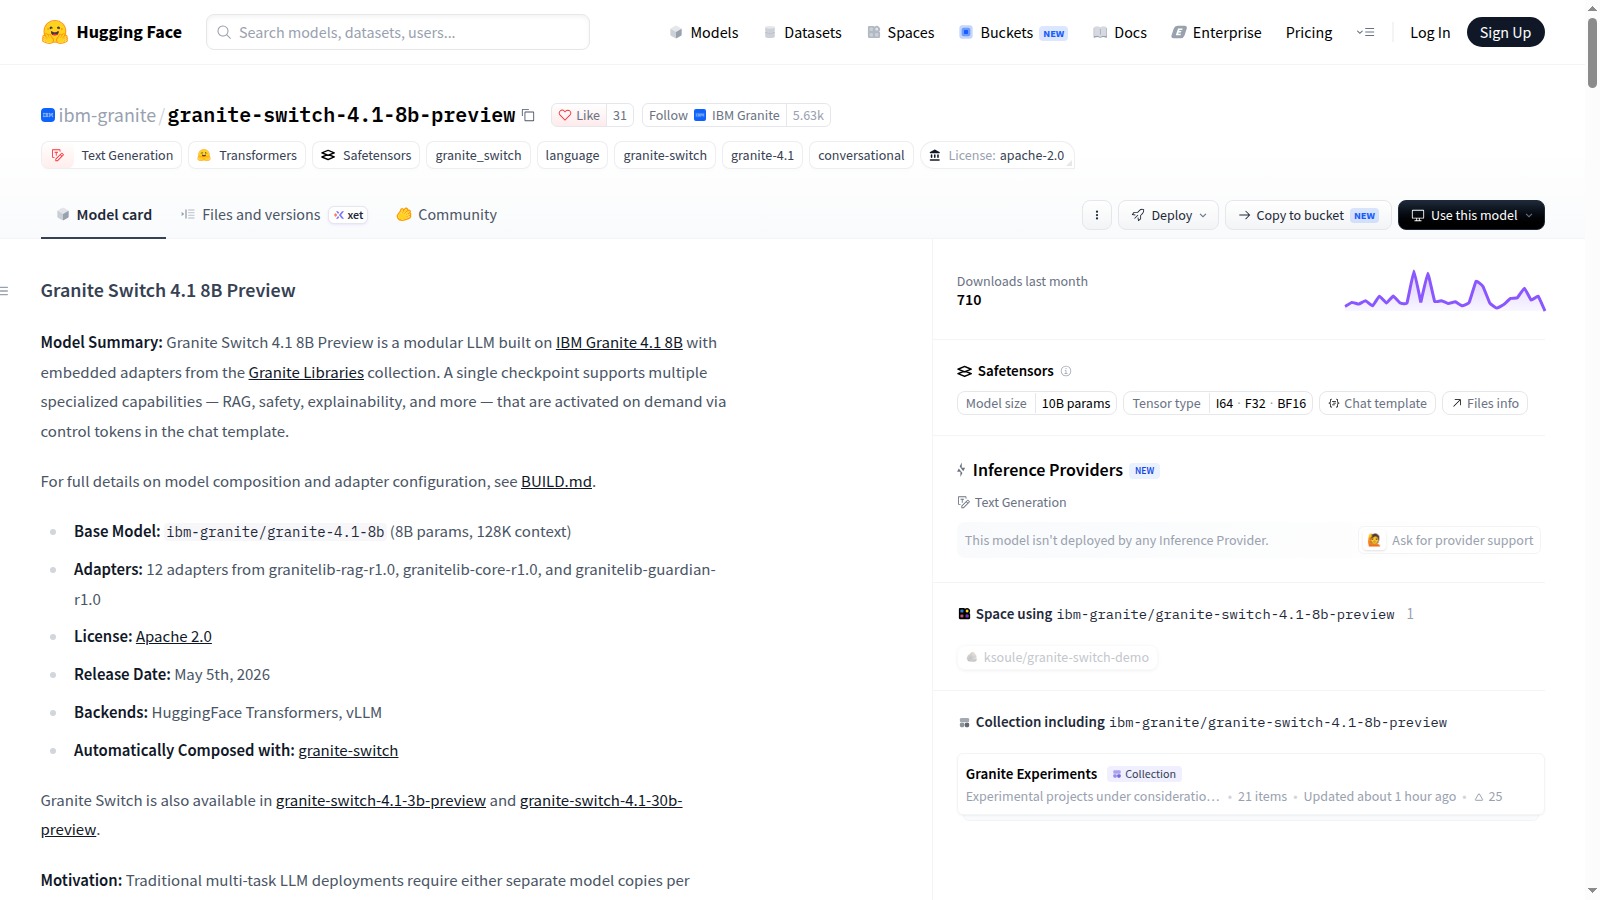
IBM ha aggiornato i pesi di Granite Switch 4.1 8B Preview, un checkpoint Apache 2.0 che incorpora 12 adapter per RAG, sicurezza, factuality, incertezza e controllo dei requisiti. Gli adapter si attivano con token dedicati nello stesso modello e il pacchetto include configurazione, template, indice degli adapter, firma e avvio con Transformers o vLLM.
Limiti da conoscere
Limite: La model card mantiene la data originaria del 5 maggio 2026: la novità del 15 ottobre è la revisione dei pesi e delle tre librerie di adapter, non il primo annuncio del progetto. È ancora una preview, i risultati sono del progetto e ogni adapter va validato sul proprio dominio; il checkpoint composto sale a circa 9,57 miliardi di parametri.
Swiss AI ha pubblicato il rapporto tecnico di Apertus 1.5 e un inventario ampio degli artefatti: dati e ricette, checkpoint intermedi per base, SFT, RLVR e DPO, evaluation card, pesi 8B e 70B Apache 2.0. Il modello accetta testo, immagini e audio, offre thinking opzionale, tool use e contesto fino a 262.144 token.
Limiti da conoscere
Limite: I pesi 8B e 70B erano già disponibili dal 24 luglio: il delta del 15 ottobre è la documentazione tecnica e riproducibile. L’audio è sperimentale, tool calling e thinking non vanno combinati, l’integrazione richiede ancora fork specifici di vLLM e Transformers e i benchmark del progetto non sostituiscono test locali.
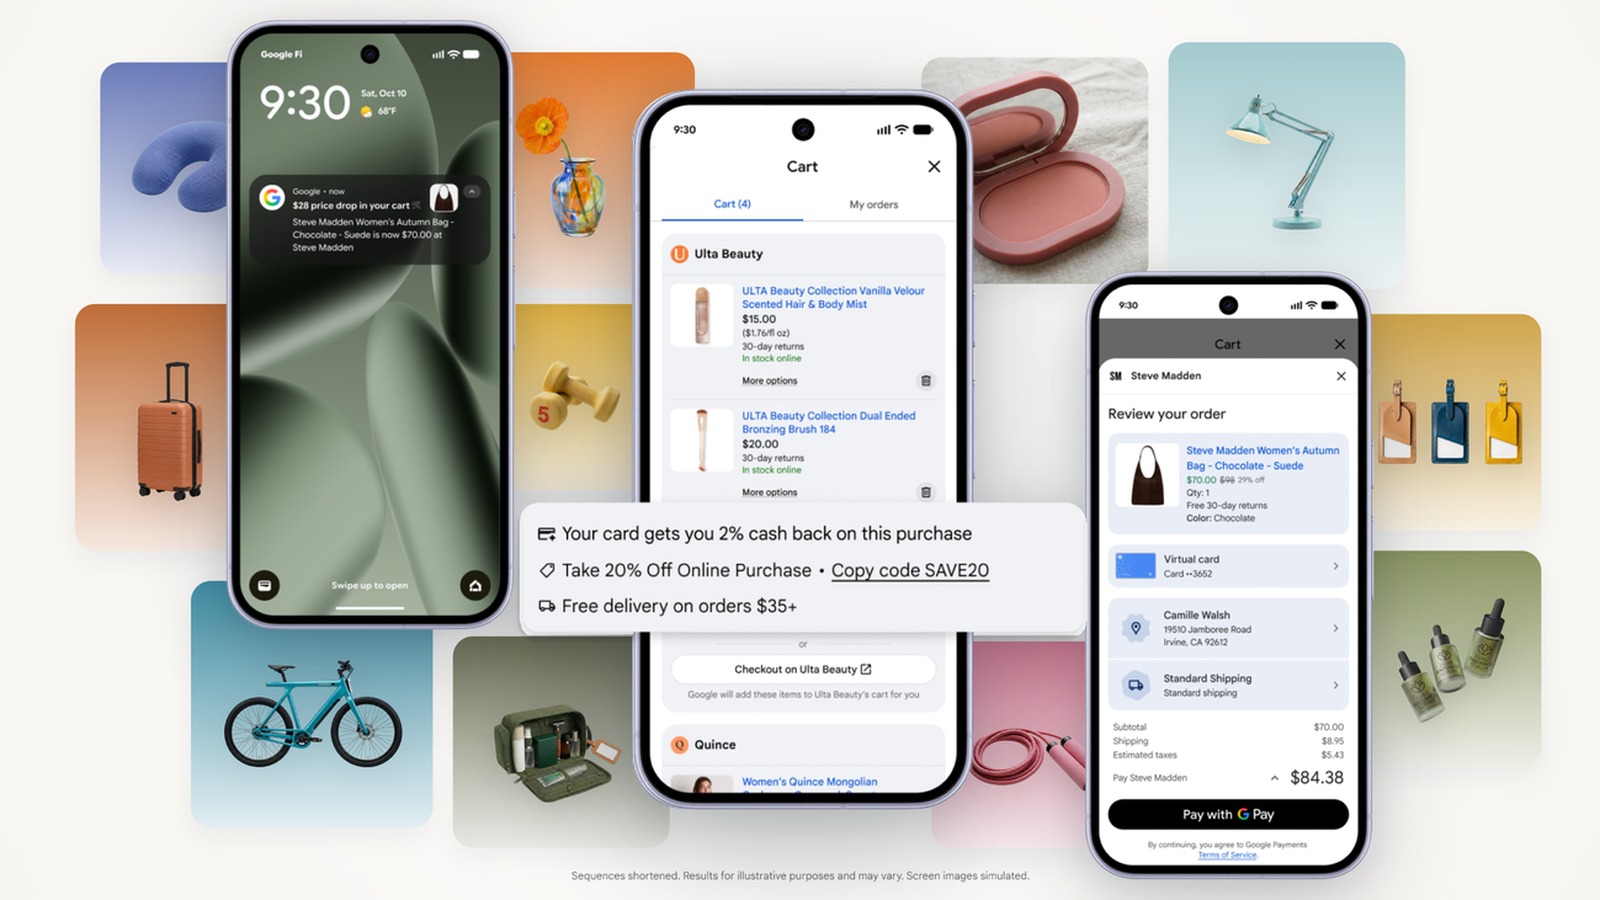
Google ha avviato negli Stati Uniti Universal Cart in Search e nell’app Gemini. Il carrello raccoglie prodotti di più retailer, segnala cali di prezzo e ritorni in stock, propone codici promozionali e vantaggi delle carte in Wallet, poi consente il checkout con Google Pay presso i merchant supportati o il passaggio al sito del venditore.
Limiti da conoscere
Limite: Il rollout è limitato agli Stati Uniti e non è stato provato dall’Italia. Google distingue questa funzione dagli agenti che agiscono per conto dell’utente: il controllo resta alla persona e il merchant resta seller of record. Disponibilità, promo e checkout dipendono dai retailer partecipanti.
Mistral ha pubblicato Timestral in quattro taglie da 5M, 28M, 123M e 209M parametri. I modelli producono previsioni probabilistiche multivariate, accettano covariate storiche e future note, lavorano fino a 32.768 passi e possono essere eseguiti localmente su CPU o GPU tramite il repository ufficiale.
Limiti da conoscere
Limite: I primati su GIFT-Eval, TIME e fev-bench sono dichiarazioni del produttore e non sono stati riprodotti su dati aziendali o hardware locale. Il rapporto tecnico completo deve ancora arrivare; codice e pesi hanno licenze distinte e il valore reale dipende da backtest senza leakage contro baseline semplici.
Black Forest Labs ha pubblicato FLUX.3 Image Klein, un modello open weight da 5,6B per text-to-image, editing e composizione fino a dieci riferimenti. I prompt possono includere bounding box su una griglia 0-1000; sono disponibili checkpoint distilled e base, BF16, FP8 e NVFP4, supporto Diffusers e script LoRA.
Limiti da conoscere
Limite: Le bounding box guidano posizione e scala ma non sono maschere rigide. I 5,6B non includono il text encoder separato; la model card misura 25-31 GB di picco su B200 senza prompt upsampler, che aggiunge circa 28 GB. La FLUX Kommunity License non è una licenza permissiva e il modello non è stato provato sul nostro hardware.
Skywork AI ha pubblicato Matrix-Game 4.0 con codice di inferenza, demo browser, tre giochi e checkpoint BF16 per castello medievale, antico Egitto e guida urbana. Il motore conserva fisica, input e regole, mentre un modello video causale trasforma in streaming i frame low-poly in immagini dettagliate.
Limiti da conoscere
Limite: I tre checkpoint sono specializzati per scene e profili di camera specifici, circa 10 GB ciascuno, e non sono pipeline Diffusers intercambiabili. Il percorso documentato richiede Linux, GPU NVIDIA e dipendenze CUDA; la cadenza di acquisizione non garantisce throughput o latenza. Training code e dati di addestramento non sono inclusi.
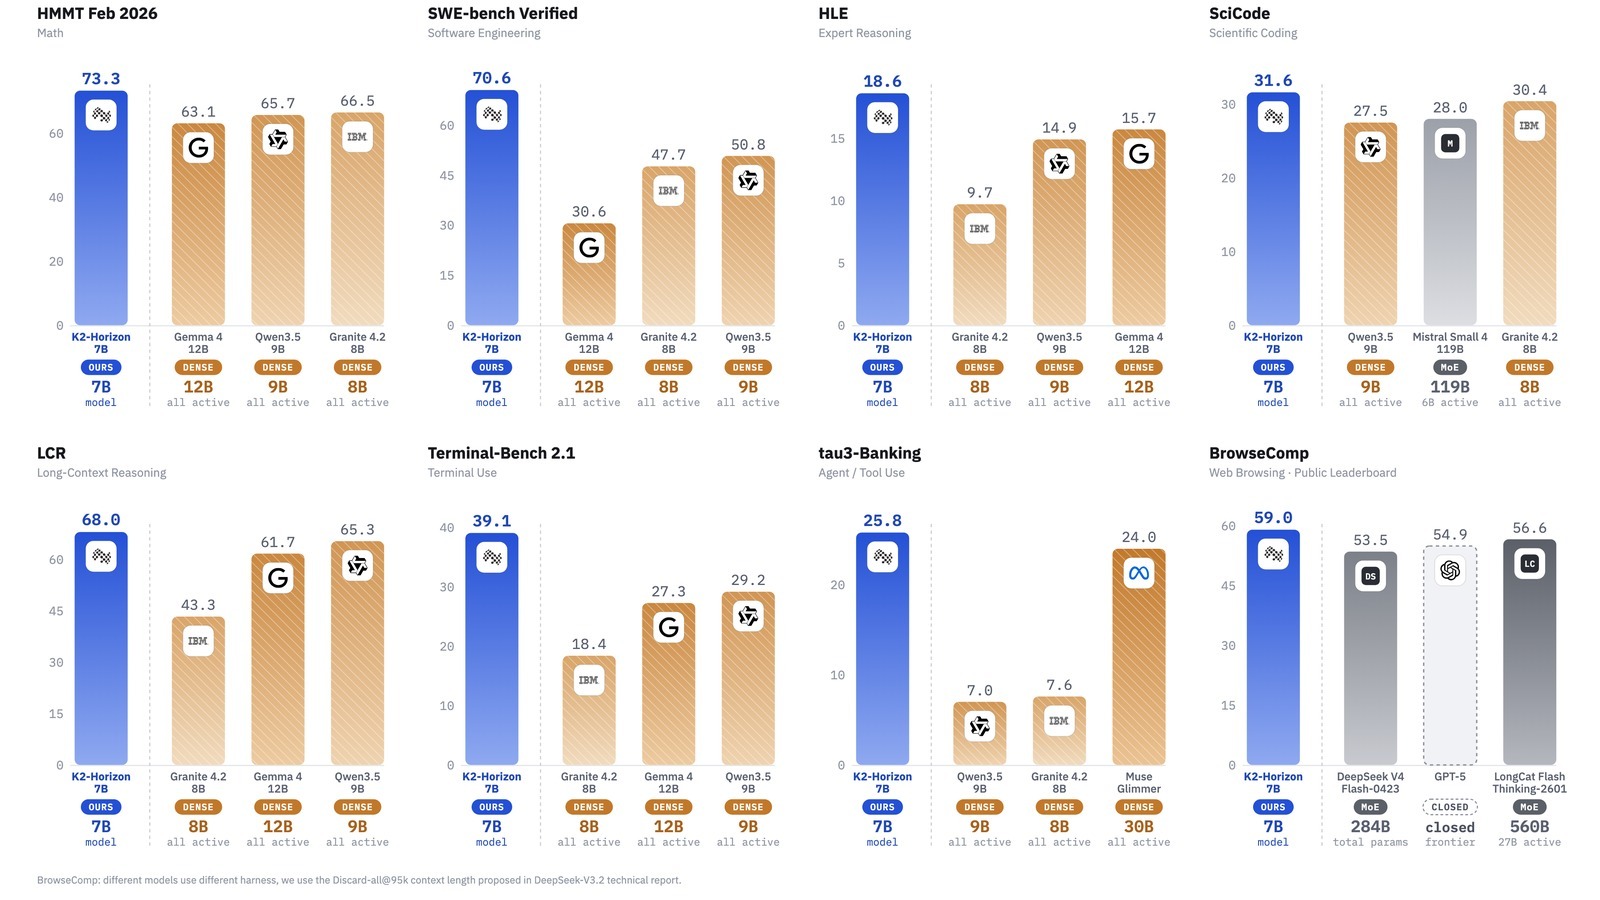
IFM ha pubblicato file GGUF per K2-Horizon 0,9B, 3,7B, 7B e MoVA 36B-A4B, nelle varianti BF16, Q8_0, Q6_K, Q5_K_M, Q5_0 e Q4_K_M. I file includono metadati del tokenizer e chat template, ma il supporto dell’architettura K2 Horizon non è ancora nel ramo principale di llama.cpp: per ora serve il fork MBZUAI-IFM.
Limiti da conoscere
Limite: La disponibilità dei GGUF non equivale ancora a compatibilità immediata con una build standard di llama.cpp. I benchmark e i confronti di qualità delle quantizzazioni sono dichiarati dal progetto; non ho riprodotto inferenza, memoria, velocità o tenuta del contesto lungo su hardware locale.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.