
IL PUNTO SULL’AI
14 ottobre 2026
Ollama 0.40.4 amplia i flussi locali con modelli decisionali, MLX ed embedding multimodali, accanto ad agenti persistenti e sicurezza AI.
In questa edizione 7 notizie
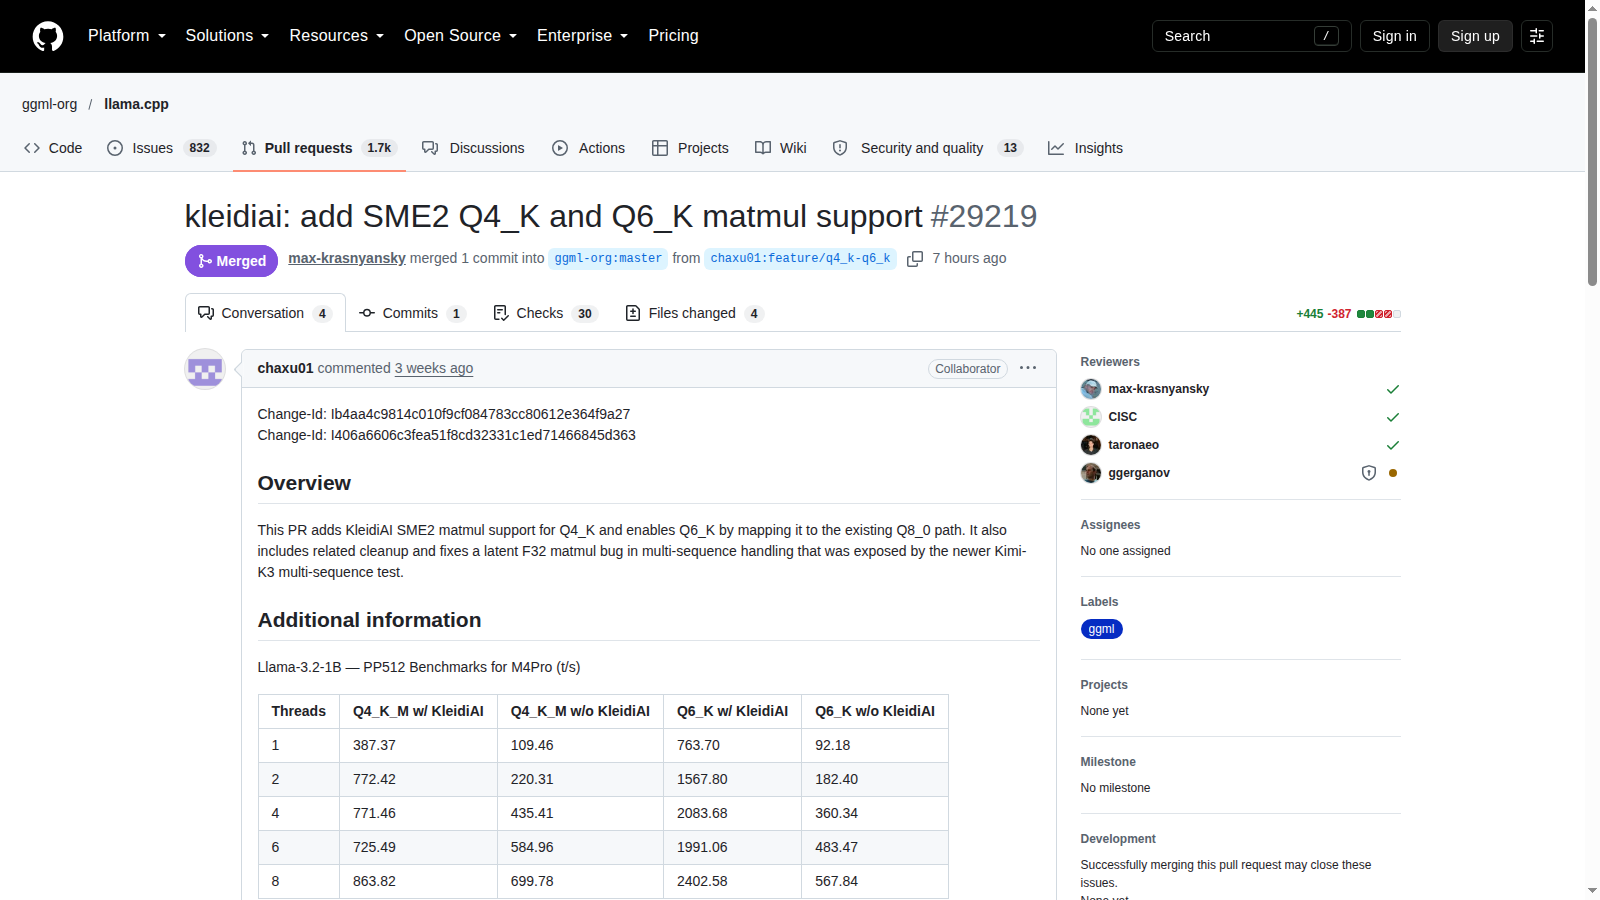
La build pre-release b11604 di llama.cpp integra kernel KleidiAI SME2 per la moltiplicazione di matrici Q4_K e abilita Q6_K attraverso il percorso Q8_0. La modifica interessa CPU Arm con SME2, corregge anche un bug F32 emerso nei test multi-sequenza e include binari Arm64 scaricabili per Linux, Android e Windows.
Limiti da conoscere
Limite: È una build pre-release e non un rilascio stabile. I benchmark della pull request sono misure dei contributori su M4 Pro: mostrano forti guadagni nel test Llama 3.2 1B, ma un maintainer segnala che su prompt lunghi il percorso può restare inferiore ai kernel MM_INT8. Hardware, modello, lunghezza del prompt e build vanno quindi verificati separatamente.
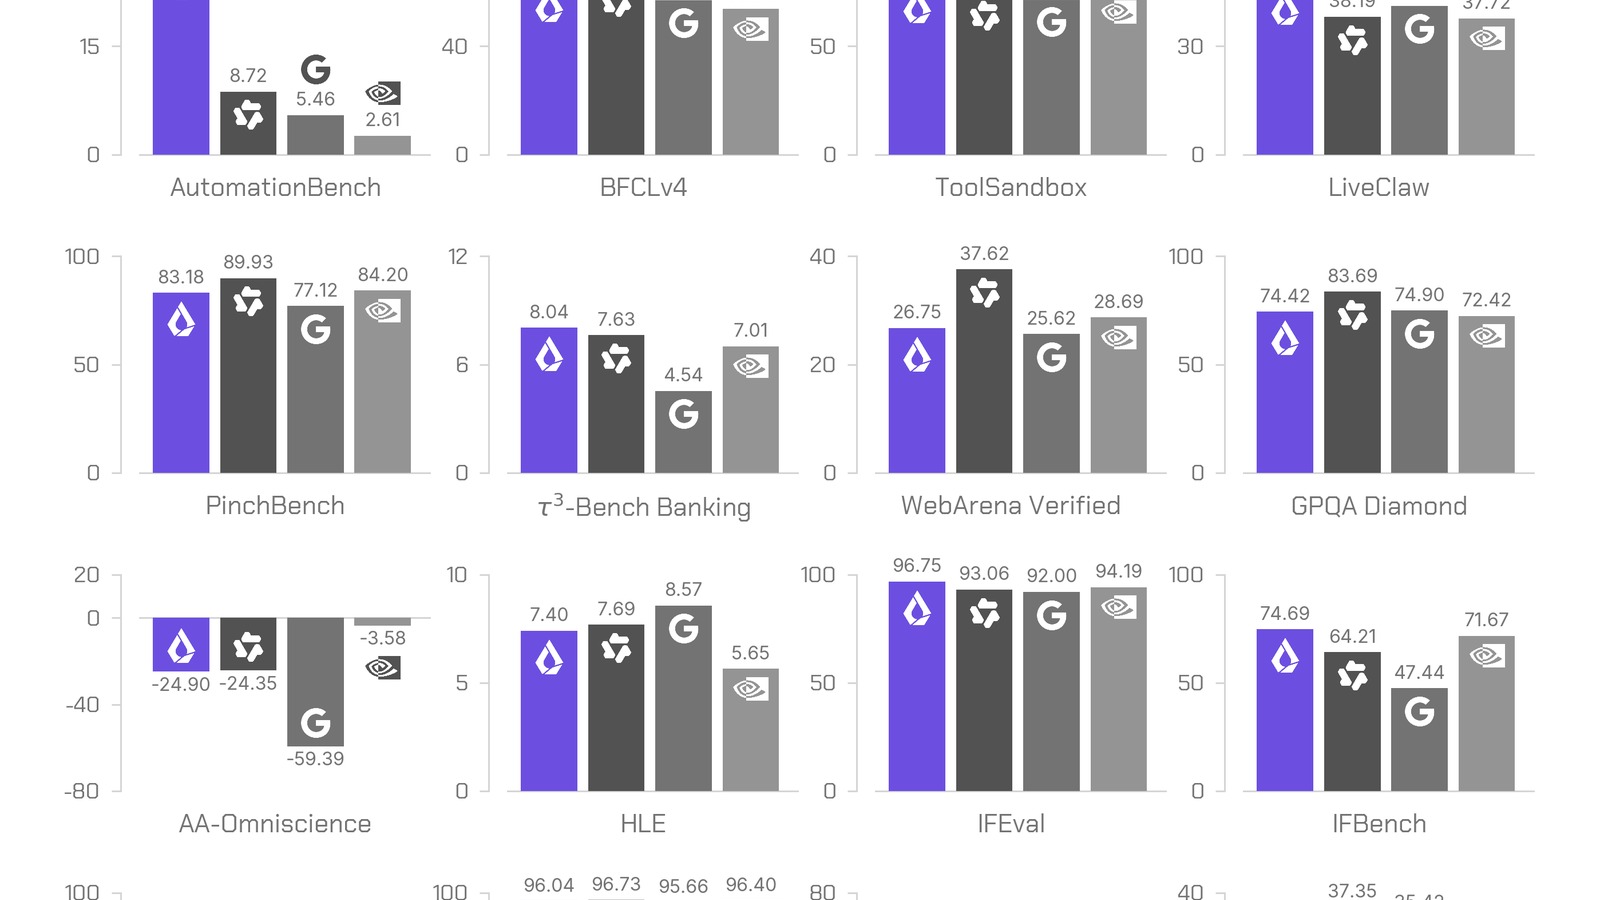
Liquid AI ha rilasciato i pesi base e post-addestrati di LFM2.5-24B-A2B, un modello testuale da 24 miliardi di parametri con 2 miliardi attivi per token. Il pacchetto include checkpoint nativo, FP8, GGUF, ONNX e MLX 4-bit, contesto da 131K token e configurazioni per collegarlo a harness locali tramite backend compatibili OpenAI.
Limiti da conoscere
Limite: Prestazioni, velocità e confronti agentici provengono dai test di Liquid AI e non da una verifica indipendente. Open-weight non significa assenza di vincoli: la licenza LFM va letta prima dell’uso, 24B di pesi richiedono comunque memoria adeguata e il modello è text-only.
In un caso cliente pubblicato da OpenAI, Higgsfield dichiara di essere passata da video limitati a circa un minuto a contenuti oltre i 10 minuti. Il workflow usa agenti basati su GPT-6 Astra, chiamate a strumenti esterni e asset generati o modificabili per assemblare tutorial lunghi, mentre GPT-Image-2.5 viene impiegato per immagini e infografiche.
Limiti da conoscere
Limite: È una testimonianza congiunta del fornitore e del cliente, non un benchmark indipendente. Non sono pubblicati costo per video, tempi completi, numero di tentativi, tasso di errore o minuti di lavoro umano; oltre dieci minuti descrive la durata dell’output assemblato, non dieci minuti generati in una singola inferenza continua.
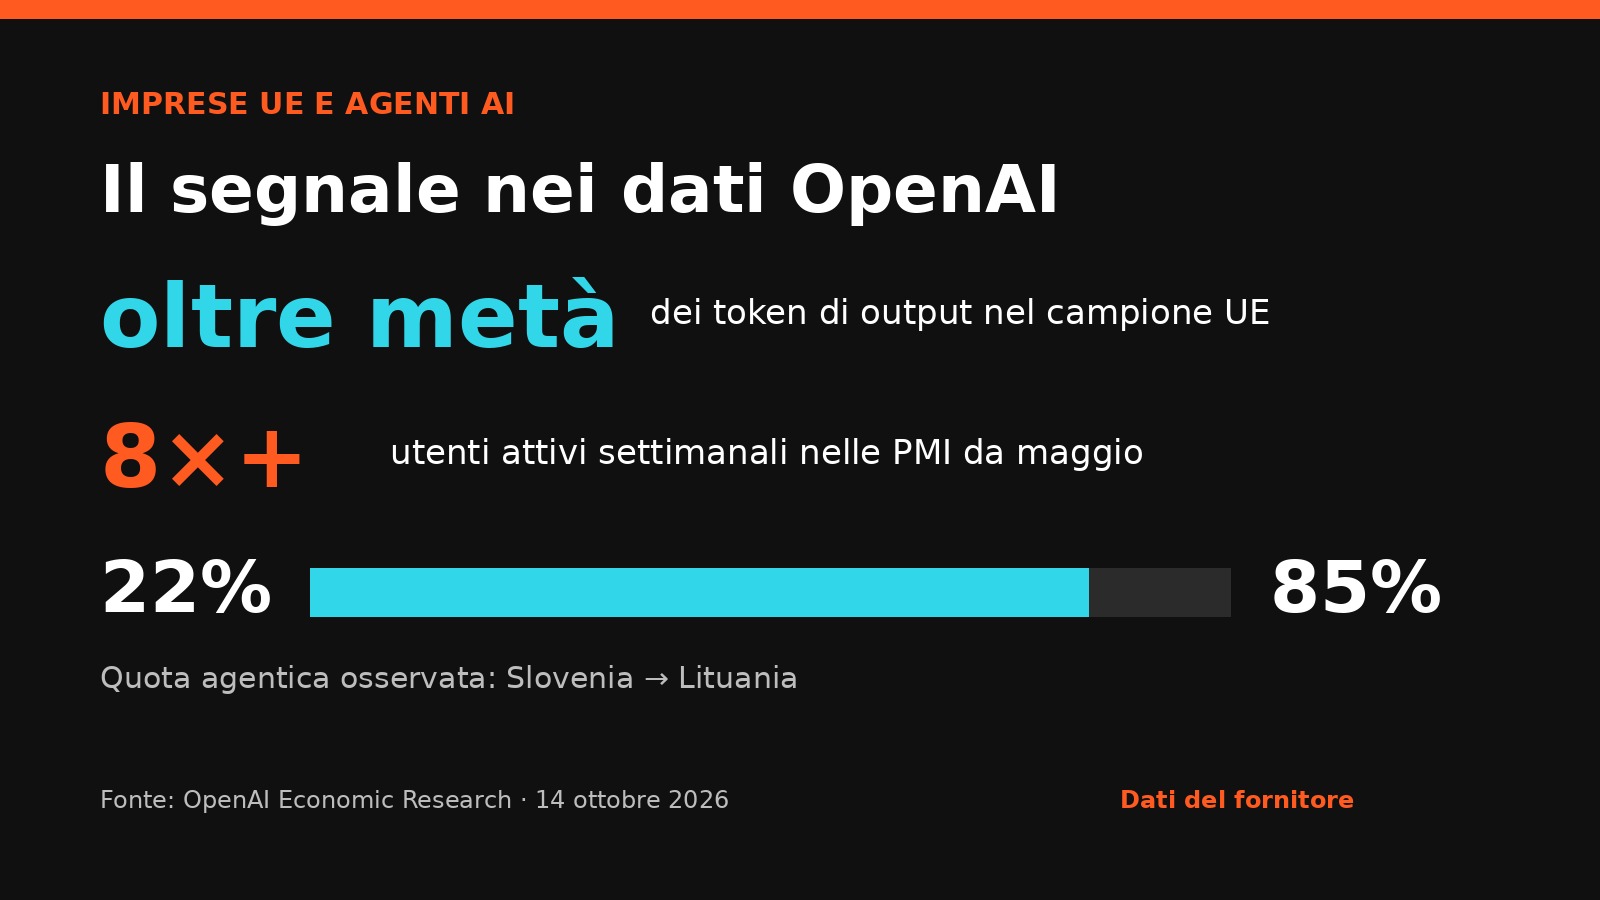
Nel campione europeo di clienti ChatGPT Enterprise analizzato da OpenAI, Codex e ChatGPT Work generano oltre metà dei token di output. Tra le PMI europee, gli utenti attivi settimanali dei due strumenti sono cresciuti di oltre otto volte da maggio 2026; la quota agentica varia però dal 22% in Slovenia all’85% in Lituania.
Limiti da conoscere
Limite: Sono dati osservazionali interni di OpenAI su propri clienti, non una misura rappresentativa di tutte le imprese UE e non una prova di produttività. Token prodotti, utenti attivi e valore economico sono metriche diverse; il confronto tra Paesi può riflettere composizione del campione, settore e maturità degli account.
Anthropic ha eseguito un esperimento controllato sulla replica autonoma: modelli fino a 30B completano già molti passaggi separati, mentre GLM-5.2 e modelli più forti riescono nella catena semplificata end-to-end. Un modello 9B ha avviato l’inferenza su 8 dei 9 tipi di hardware provati.
Limiti da conoscere
Limite: Il test semplifica la fase di exploit, usa dispositivi acquistati e messi in rete dai ricercatori e non dimostra un worm autonomo attivo nel mondo reale. La previsione secondo cui piccoli modelli potrebbero raggiungere questa capacità entro fine 2026 è un’estrapolazione, non un risultato già osservato.
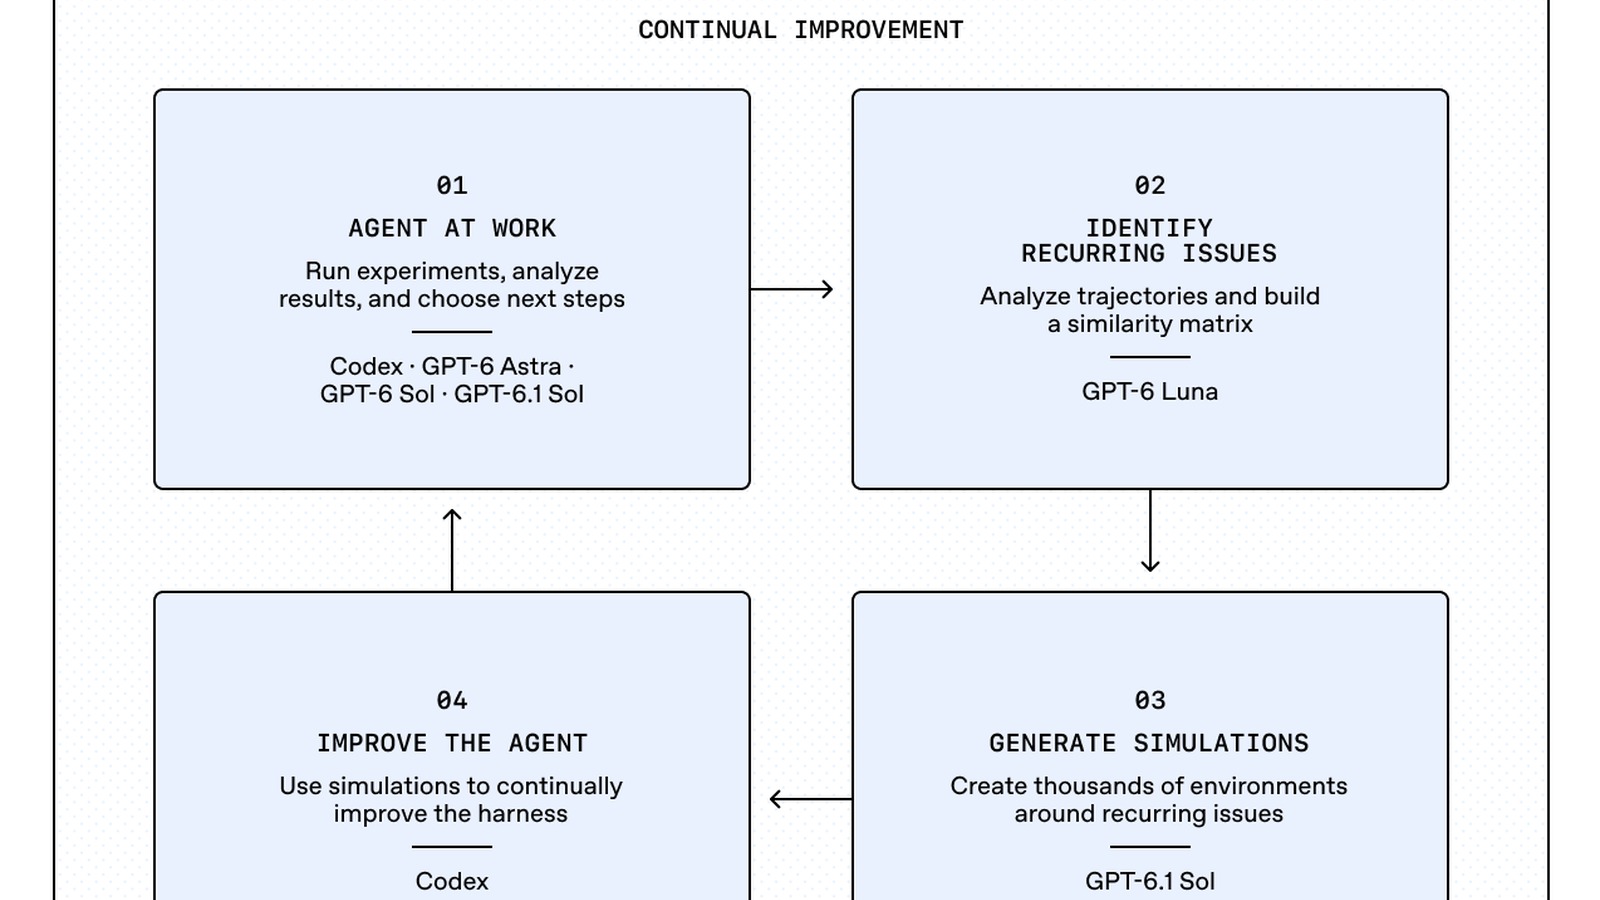
OpenAI racconta che Third Moment esegue fino a 10.000 agenti concorrenti in sessioni da 36–48 ore. Il dato operativo più utile è l’architettura: ambienti Docker isolati, un harness esterno che decide retry, stop o escalation e test di breakout prima delle simulazioni.
Limiti da conoscere
Limite: È un caso cliente pubblicato da OpenAI, non un benchmark indipendente. Non sono disponibili costo totale, tasso di errore, log completi, frequenza degli interventi umani o un confronto controllato con altri modelli.
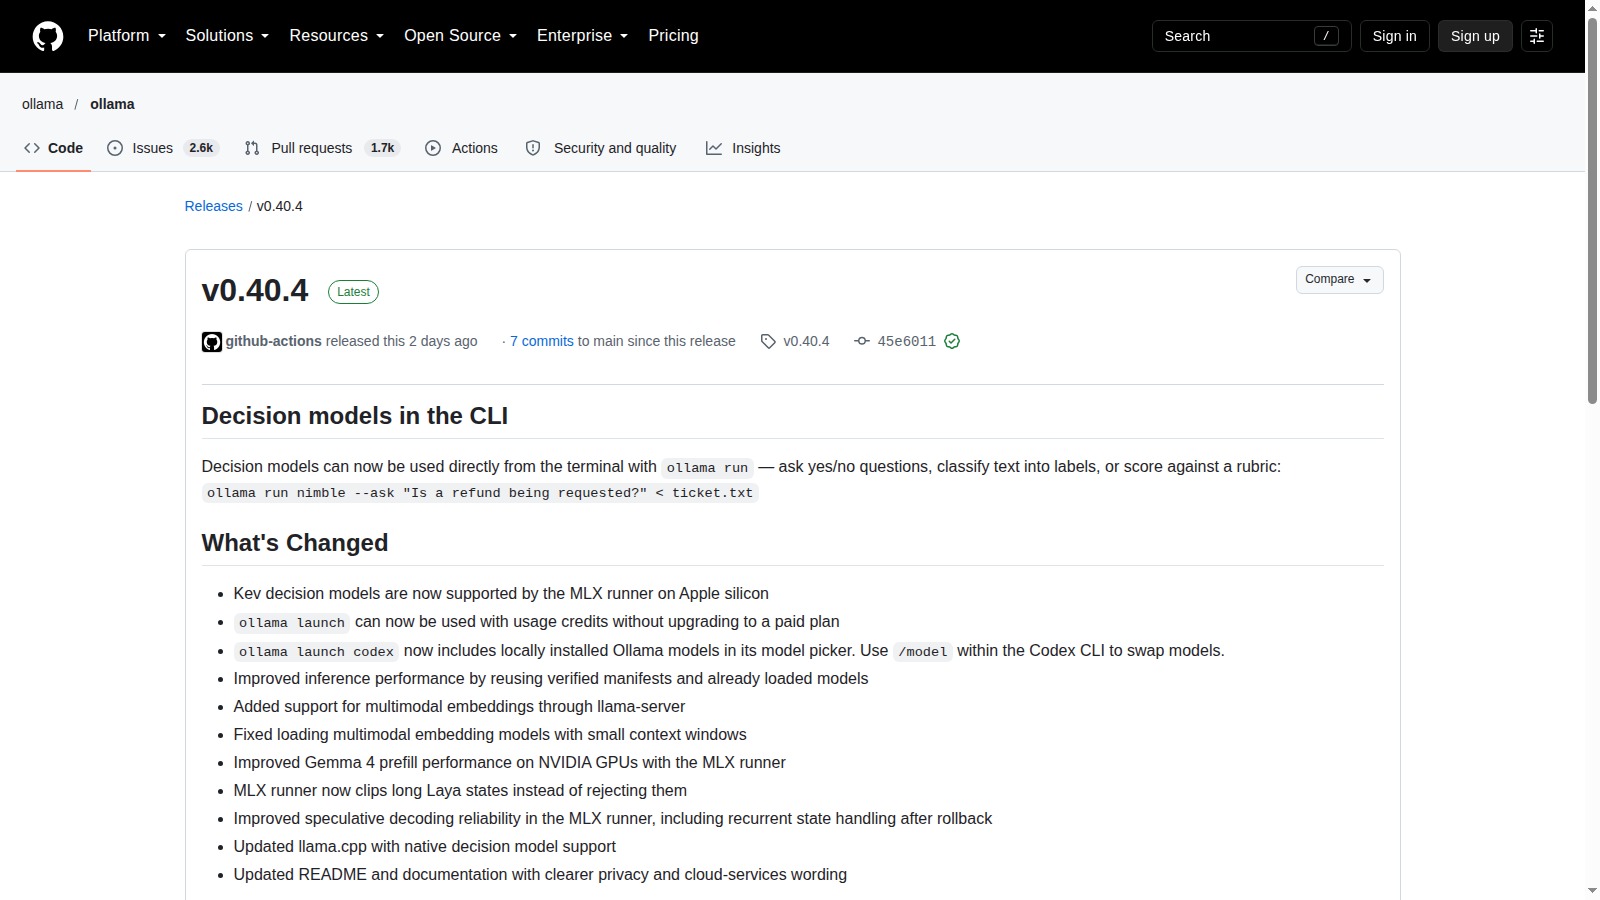
Ollama 0.40.4 è una release stabile che consente di usare i modelli decisionali direttamente con ollama run per classificazioni, risposte sì/no e rubriche. Aggiunge inoltre il supporto MLX ai modelli decisionali Kev su Apple silicon, embedding multimodali tramite llama-server e modelli locali nel selettore di Codex CLI.
Limiti da conoscere
Limite: Le prestazioni e l’affidabilità dipendono dal modello, dall’hardware e dal runner. La release non pubblica benchmark comparativi completi; classificazioni, rubriche ed embedding vanno quindi verificati su dati reali prima di automatizzare decisioni.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.