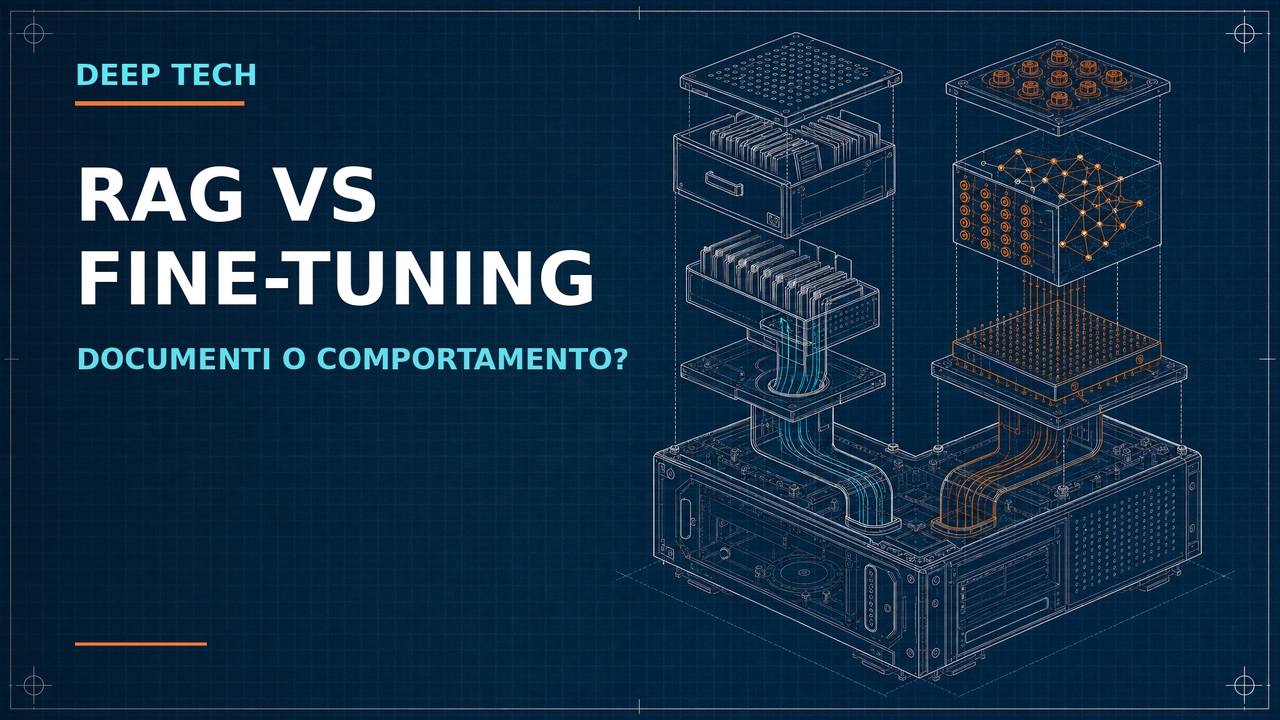
Risposta diretta: se devi far rispondere un LLM su documenti privati, aggiornabili e citabili, parti dal RAG. Se devi cambiare in modo stabile comportamento, formato o stile su un compito ripetitivo, valuta il fine-tuning. Prima di entrambi, misura quanto riesci a ottenere con prompting, esempi e output strutturato. RAG e fine-tuning non sono rivali: risolvono problemi diversi e, solo quando la mini-eval lo giustifica, possono convivere.
La differenza in una frase
Il RAG porta la conoscenza al modello al momento della richiesta; il fine-tuning modifica i pesi del modello usando esempi. Il lavoro originale sul RAG lo descrive come una combinazione di memoria parametrica e memoria non parametrica esterna, nata anche per affrontare aggiornamento della conoscenza e provenienza delle risposte.
Questa distinzione evita l’errore più costoso: addestrare un modello per “fargli sapere i miei PDF”. Se quei PDF cambiano, stai trasformando un problema di indicizzazione in un ciclo di training. Per dati freschi e verificabili, la mia priorità è quindi: prompting → RAG → fine-tuning, non il contrario.
Prompting, RAG o fine-tuning: tabella decisionale
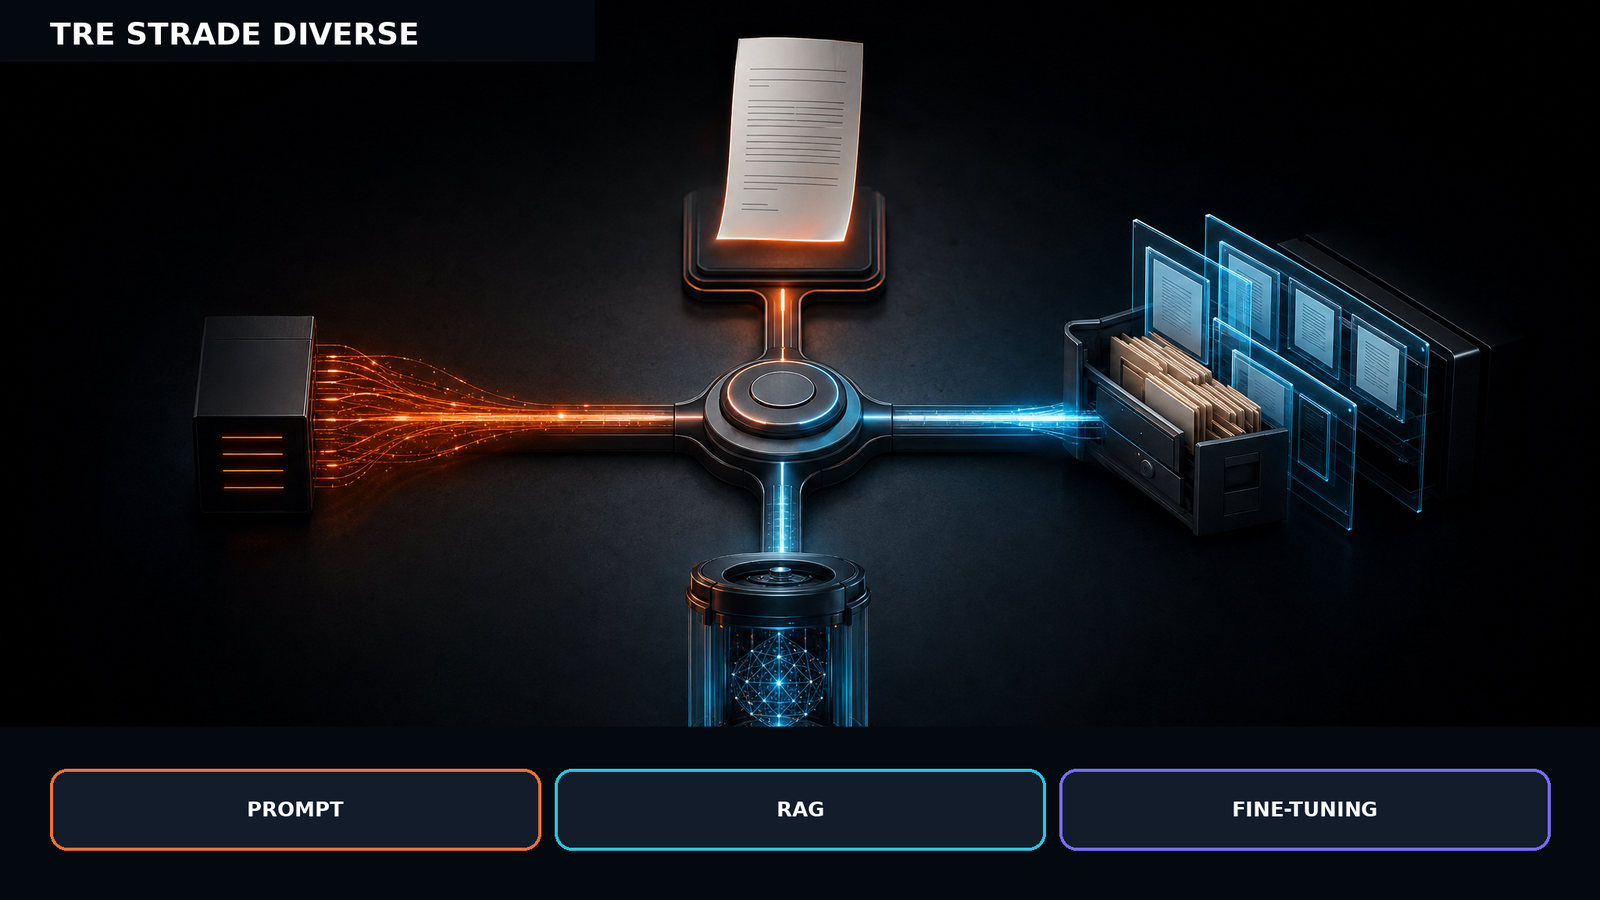
Google descrive il RAG come ricerca di informazioni rilevanti nei propri dati e passaggio di quel contesto al prompt; indica invece il supervised fine-tuning per compiti ben definiti come classificazione e output strutturati. OpenAI, nella propria documentazione SFT, raccomanda esplicitamente di costruire prima le eval e poi decidere se investire nel fine-tuning.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Costi e manutenzione: niente numeri universali
Dire “RAG costa meno” o “il fine-tuning abbatte i costi” senza carico, provider e modello è marketing, non progettazione. Il costo totale va calcolato sul tuo traffico e include lavoro umano.
- Prompting: token delle istruzioni e degli esempi, eval, osservabilità e correzioni.
- RAG: parsing, chunking, embedding iniziali e incrementali, storage, ricerca/reranking, token del contesto, latenza aggiunta, ACL, aggiornamento indici e valutazione del retrieval.
- Fine-tuning: raccolta e pulizia esempi, labeling, training, esperimenti falliti, hosting/inferenza del modello supportato, regressioni, retraining e nuova validazione.
Formula minima: TCO = setup + (costo_query × volume) + manutenzione + costo_errori. Per il RAG, separa retrieval e generazione. Per il fine-tuning, ammortizza dataset e training sul volume utile, ma non assumere che la conoscenza incorporata resti aggiornata. I servizi gestiti possono cambiare il conto: per esempio, File Search automatizza chunking, embedding e indicizzazione, ma pricing e limiti sono contratti del provider da ricontrollare alla data del progetto.
Failure mode che contano davvero
- Prompt corretto, contesto assente: nessun fine-tuning recupera un documento che il sistema non gli rende disponibile.
- Retrieval sbagliato: chunk troppo grandi, query ambigua, embedding inadatti o ranking debole portano al modello la prova sbagliata.
- Contesto corretto, risposta infedele: il generatore ignora o mescola le fonti; misura citation precision e coverage, non solo “sembra giusto”.
- Dati duplicati o in conflitto: policy vecchie e nuove possono entrambe finire nei top-k. Versioni e metadata non sono optional.
- Leakage ACL: un indice condiviso senza filtri può recuperare documenti che l’utente non dovrebbe vedere.
- Overfitting del fine-tuning: migliora sugli esempi noti e peggiora su input reali o rari.
- Dataset che insegna errori: il modello replica incoerenze, tono e omissioni presenti nelle dimostrazioni.
- Drift operativo: modello base, API, corpus e distribuzione delle richieste cambiano; la vecchia eval non basta.
Decision tree pratico
- Il modello deve conoscere fatti privati o aggiornabili? Sì → prova RAG, misuralo e poi prosegui al punto 2 per verificare se esiste anche un bisogno comportamentale. No → vai direttamente al punto 2.
- Il problema comportamentale è risolvibile con istruzioni, schema e 3-10 esempi? Sì → resta sul prompting (eventualmente insieme al RAG) e misura. No → vai al punto 3.
- Hai un compito stretto, ripetitivo, una metrica e dimostrazioni affidabili? Sì → candidato fine-tuning. No → migliora specifica, dati ed eval.
- Servono sia fatti freschi sia comportamento specializzato? Valuta RAG + fine-tuning, ma solo contro le baseline separate.
- Non puoi spiegare il fallimento? Non addestrare ancora: aggiungi tracing di retrieval, output e costi.
Mini-eval italiana: come confrontare senza inventare benchmark
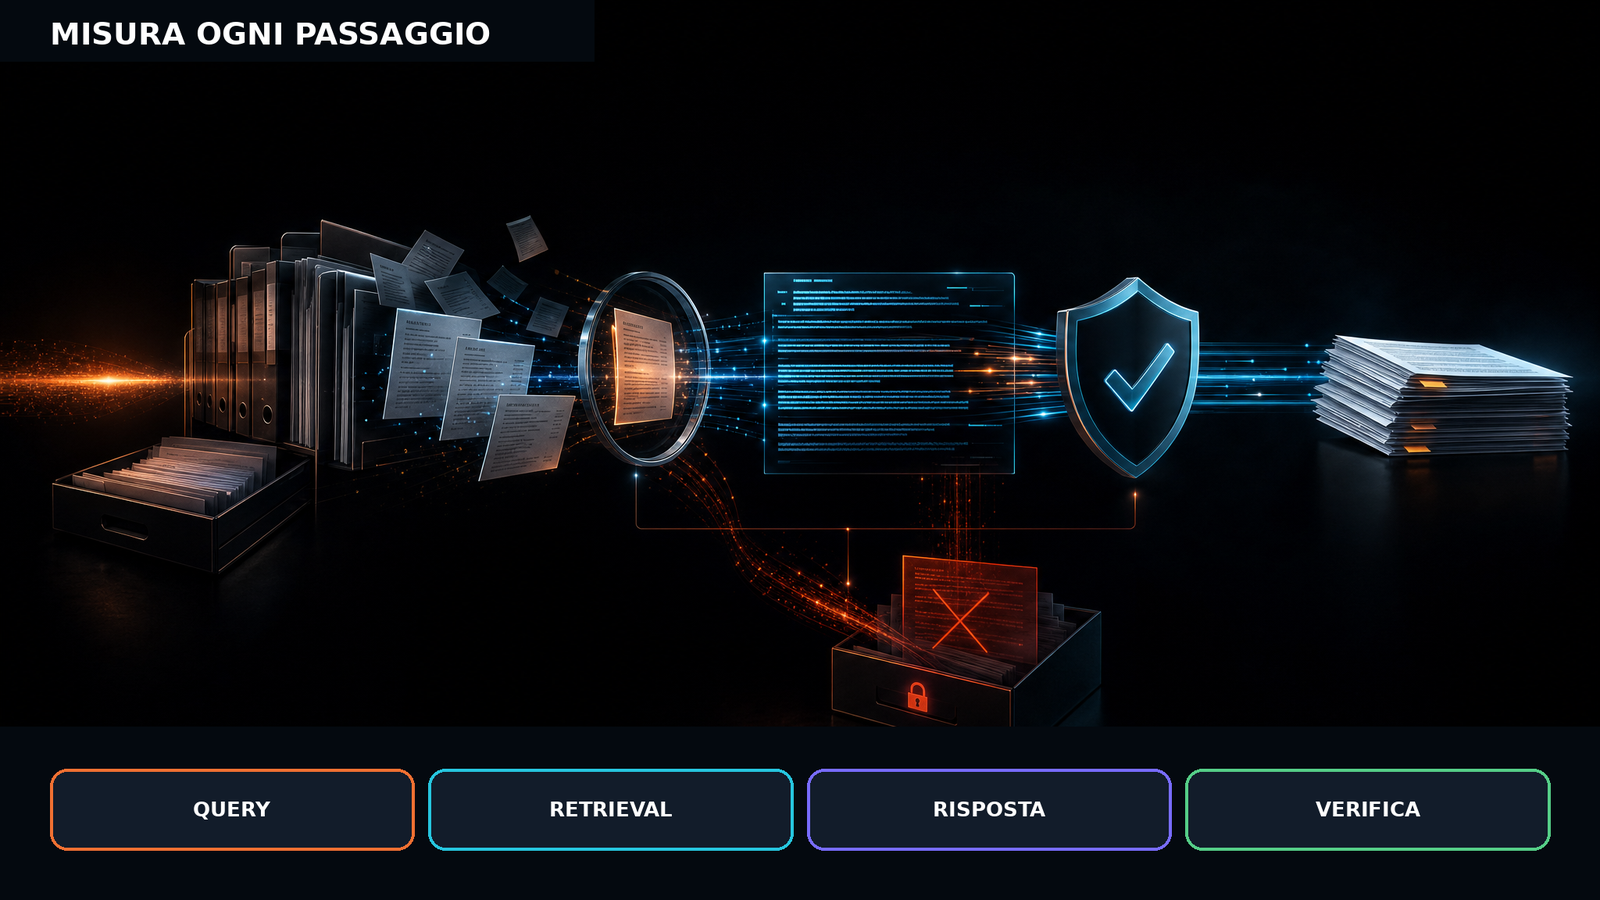
Qui non pubblico un vincitore finto: il risultato è pendente. Ho preparato un dataset di test parziale e una bozza di protocollo con casi italiani su policy versionate, procedure, conflitti, astensione, JSON e ACL. Il pacchetto non è eseguibile nello stato attuale: mancano corpus versionato e split train/dev. Una futura esecuzione dovrà usare lo stesso modello base e quattro bracci possibili: prompting, RAG, fine-tuning e ibrido.
- Congela modello, data, temperatura, corpus, chunking, top-k e reranker.
- Non usare gli item di test nel training.
- Misura correttezza, citazioni, astensione, validità del formato e leakage.
- Registra p50/p95, token, costo effettivo e ore uomo.
- Conserva output, chunk recuperati ed error ledger, anche quando il risultato è brutto.
La documentazione OpenAI sul retrieval conferma che i vector store indicizzano i file tramite chunk ed embedding e che strategia di chunking e filtri sono parametri osservabili, non magia. Il dataset test-only parziale e la bozza di protocollo accompagnano questo candidato editoriale; corpus, train/dev e configurazioni versionate vanno completati prima che la prova possa essere eseguita e revisionata.
Un caveat pratico: il RAG non è un database con la verità incorporata
Il caveat che vedo saltare più spesso è questo: aggiungere documenti a un vector store non significa aver costruito una fonte autorevole. Se non gestisci identità del documento, versione, data di validità, ACL e conflitti, hai solo reso ricercabile il caos. Prima del tuning del modello, sistema il lifecycle dei contenuti.
Per vedere un’implementazione gestita puoi partire dalla guida su Gemini File Search. Se vuoi controllare la pipeline e il tracing, guarda Datapizza AI per agenti e RAG. Per documenti scansionati, il collo di bottiglia può essere prima del retrieval: ho raccolto il percorso nell’articolo sull’OCR locale per PDF e immagini. E se il corpus contiene istruzioni ostili, serve anche il threat model sulla prompt injection.
Domande frequenti
Il RAG addestra il modello?
Non necessariamente. In una pipeline comune recupera contenuti esterni e li inserisce nel contesto della richiesta; il modello base può restare invariato.
Il fine-tuning serve per insegnare documenti aziendali?
Di norma non è il primo strumento. Se i documenti cambiano o devono essere citati, il RAG è una baseline più adatta. Il fine-tuning può essere utile per comportamento, classificazione, formato o tono.
Posso usare RAG e fine-tuning insieme?
Sì. Il modello fine-tuned può specializzare il comportamento mentre il RAG porta conoscenza aggiornata. Va però dimostrato che l’ibrido supera entrambe le baseline e giustifica la complessità.
Qual è più economico?
Dipende da volume, modello, dataset, latenza, storage, retrieval e manutenzione. Calcola il TCO sul tuo carico; non esiste un verdetto universale.
Quanti esempi servono per il fine-tuning?
Non c’è una soglia universale. Come riferimento provider-specifico, la guida OpenAI SFT suggerisce di iniziare con 50 dimostrazioni ben costruite e valutare; non è una garanzia trasferibile a ogni modello o task.
Come capisco se il RAG funziona?
Separa retrieval e generazione: misura se recupera la prova corretta, se la risposta la usa fedelmente, se cita bene, se si astiene quando manca la prova e se rispetta le ACL.
Fonti e riferimenti
Fonti primarie e approfondimenti utilizzati per verificare i concetti e le condizioni descritte nell’articolo.
Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
paper primario, NeurIPS 2020.
Apri fonteGoogle Cloud, To tune or not to tune?
confronto ufficiale tra prompting, RAG e SFT.
Apri fonteOpenAI, Supervised fine-tuning
casi d’uso, dataset ed eval-first; pagina verificata il 28 agosto 2026.
Apri fonteAggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.