Google AI Edge Gallery porta gli LLM sullo smartphone senza trasformare il telefono in un piccolo data center miracoloso. È una app sperimentale e open source di Google: scarico un modello compatibile, lo eseguo sul dispositivo e posso provare chat, analisi di immagini e trascrizione audio anche senza connessione. Il punto interessante non è lo slogan “AI privata”, ma la possibilità di misurare sul proprio hardware quanto un modello locale sia davvero utile.
Non presento questo articolo come il resoconto di un test fisico già svolto: non ho eseguito queste prove su uno smartphone specifico. Ho invece verificato procedura, requisiti, funzioni e dimensioni nelle fonti ufficiali Google e nel repository del progetto. Qui trovi quindi una guida riproducibile, con una prova in modalità aereo pensata per separare i fatti dal marketing.
Su questo blog avevo già parlato di Gemma 3n in locale, compresi testo, immagini e audio. Qui il tema è diverso: non il singolo modello o l’installazione su PC, ma l’app ufficiale che permette di scaricare e confrontare più modelli direttamente su Android, vedere le metriche del proprio telefono e verificare l’esecuzione offline senza configurare Ollama, Python o LM Studio.
Che cos’è Google AI Edge Gallery
Google la definisce una app sperimentale che mostra esperienze di AI generativa eseguite interamente in locale. Il progetto è pubblicato con licenza Apache 2.0 e il codice è consultabile su GitHub. La versione Android richiede Android 12 o successivo ed è disponibile su Google Play; chi non può usare il Play Store trova anche gli APK nelle release ufficiali del repository.
La parola “Gallery” è importante: non è un sostituto universale di Gemini, ChatGPT o Claude. È un laboratorio pronto all’uso per confrontare modelli, prompt e acceleratori sul telefono. L’app espone anche metriche e benchmark, così la discussione può passare da “sembra veloce” a tempo al primo token e velocità di generazione sul dispositivo reale.
Installazione su Android: cosa serve davvero
- Verifica di avere Android 12 o una versione successiva.
- Controlla RAM e spazio libero. Il requisito dell’OS non garantisce da solo che ogni modello funzioni bene.
- Installa Google AI Edge Gallery dal Play Store e verifica che lo sviluppatore indicato sia Research at Google/Google.
- Apri l’app con la connessione attiva e scegli un modello dall’elenco.
- Attendi il download completo prima di tentare la prova offline.
L’app occupa solo una parte dello spazio: il peso vero arriva dai modelli. La allowlist ufficiale Android pubblicata nel repository mostra esempi molto diversi: Gemma 3 1B quantizzato int4 pesa circa 584 MB e richiede almeno 6 GB di memoria; Qwen 2.5 1.5B circa 1,60 GB; Gemma 4 E2B circa 2,58 GB con minimo 8 GB; Gemma 4 E4B circa 3,65 GB con minimo 12 GB. Gemma 3n E4B arriva a circa 4,92 GB e indica 12 GB di memoria minima. I valori sono quelli del file modello, non una promessa sul consumo totale durante l’inferenza: consulta la allowlist ufficiale.
Io terrei libero più spazio del solo file dichiarato. Download temporanei, aggiornamenti e più modelli possono saturare rapidamente uno smartphone. Anche RAM minima e spazio di archiviazione sono grandezze diverse: un file da 2,6 GB che entra nella memoria interna non implica automaticamente un’esperienza fluida con 6 GB di RAM.
Quale modello scegliere per iniziare
L’elenco può cambiare con le versioni dell’app. Non leggere quindi questa tabella come catalogo eterno: controlla sempre dimensione, memoria minima, modalità supportate e formato mostrati dalla versione installata. L’app può anche importare modelli compatibili, ma per il primo giro resterei nella lista proposta da Google: riduce le variabili e rende più semplice capire se un problema dipende dal telefono, dal runtime o dal modello.
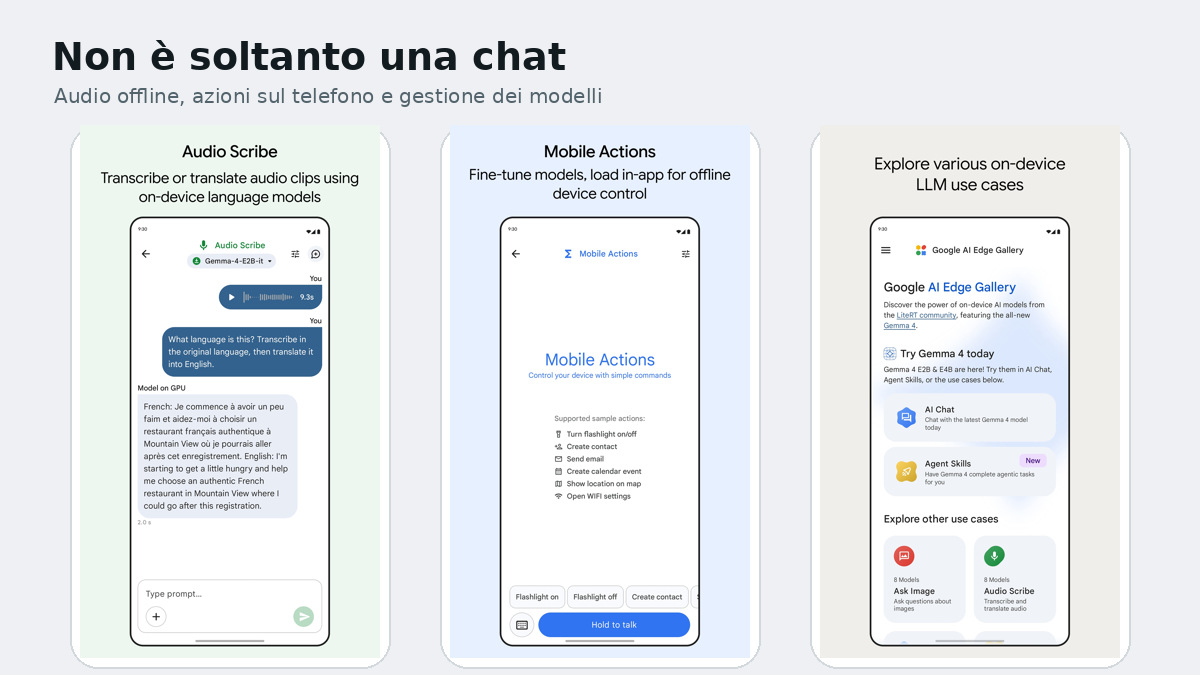
Le tre prove utili: chat, immagini e audio
1. AI Chat e Prompt Lab
Per la chat userei tre prompt brevi e ripetibili: un riassunto, una trasformazione strutturata e una domanda che richiede ragionamento. Annoterei modello, backend CPU/GPU, temperatura, tempo al primo token e token al secondo. Prompt Lab permette di modificare parametri come temperatura e top-k; cambiare tutto insieme, però, rende il confronto inutile.
2. Ask Image
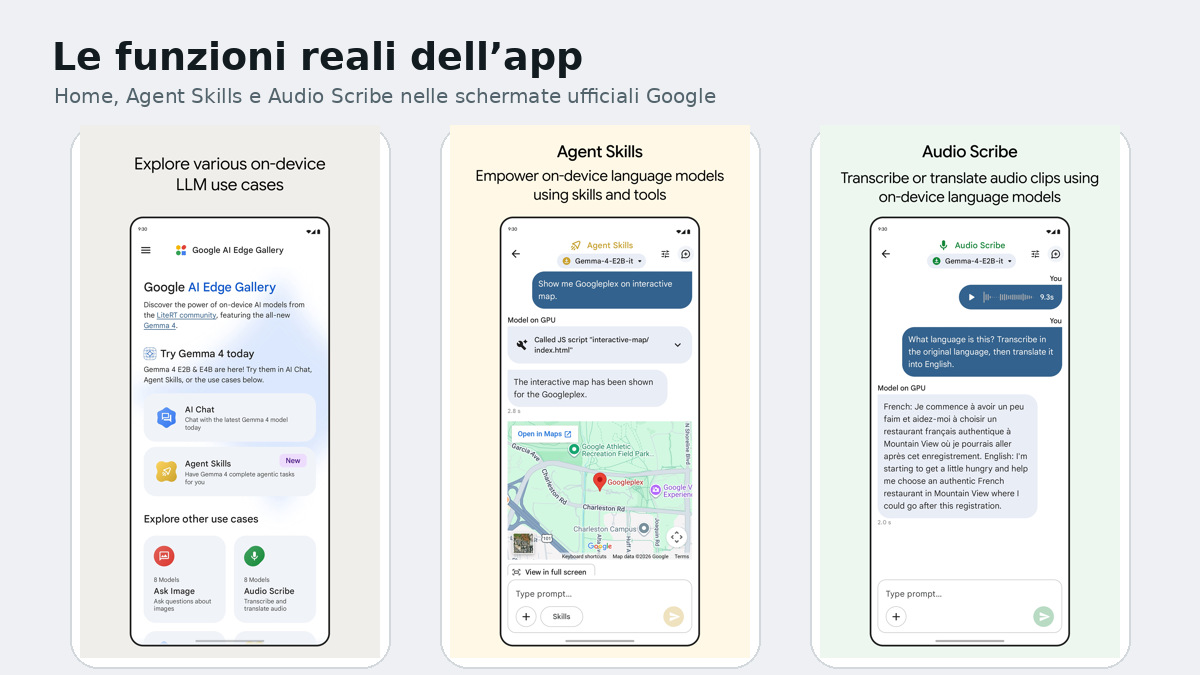
Ask Image consente di scegliere una foto o usare la fotocamera e fare domande sul contenuto. Serve un modello con supporto visivo: la allowlist segnala esplicitamente questa capacità. Userei un’immagine non sensibile, poi chiederei prima una descrizione oggettiva e dopo una domanda puntuale. “Ha visto l’immagine” non significa “ha interpretato tutto correttamente”: testi piccoli, dettagli e relazioni spaziali restano buoni punti di rottura.
3. Audio Scribe
Audio Scribe permette di caricare o registrare audio per trascriverlo localmente. Google ha presentato la funzione con Gemma 3n e, nel lancio iniziale, indicava inferenza batch per clip fino a 30 secondi; l’articolo ufficiale spiega anche trascrizione e traduzione del parlato. Poiché l’app evolve, verificherei nell’interfaccia i limiti della release corrente prima di progettare un flusso di lavoro. La fonte di lancio è il Google Developers Blog.
La prova in modalità aereo: il test che conta
“On-device” va verificato, non ripetuto. Dopo aver scaricato completamente il modello e preparato una foto e un breve audio locali, farei così:
- chiudo l’app e disattivo Wi-Fi e rete mobile, oppure attivo la modalità aereo;
- riapro Gallery e seleziono il modello già scaricato;
- eseguo una chat breve, una domanda su un’immagine e una trascrizione audio;
- controllo che arrivino risultati e che l’app non chieda un download;
- registro modello, telefono, RAM, versione Android, backend, tempo al primo token, velocità e temperatura percepita;
- riattivo la rete solo alla fine.
Questa prova dimostra che quella specifica inferenza può avvenire offline. Non dimostra che ogni funzione dell’app sia sempre priva di rete: download dei modelli, import da Hugging Face, link esterni, aggiornamenti e alcune Agent Skills richiedono o possono usare connettività. Per un test di privacy serio disattiverei anche le funzioni con strumenti esterni e distinguerei l’inferenza di base dalle integrazioni.
Privacy: meglio, ma non magica
La scheda Play dichiara che l’inferenza dei modelli avviene sul dispositivo e che per prompt, immagini e dati sensibili non è richiesta una connessione. Nella sezione “Sicurezza dei dati”, però, Google Play riporta anche che l’app può raccogliere attività dell’app e informazioni su app e prestazioni, pur dichiarando che non condivide dati con terze parti. Le due affermazioni non sono necessariamente in contraddizione: input del modello locale e telemetria dell’app sono categorie diverse.
Per questo non userei la formula “privacy totale” come assoluto. Direi piuttosto: l’architettura locale riduce l’esposizione dei contenuti perché l’inferenza non richiede l’invio a un server, ma restano da valutare permessi, telemetria dichiarata, backup del dispositivo, file salvati, tastiera, screenshot e integrazioni di rete. Per dati davvero riservati, la modalità aereo è un buon test funzionale, non una certificazione di sicurezza.
Prestazioni: il telefono decide più del logo del modello
Google avverte nella scheda Play che le prestazioni dipendono dall’hardware CPU/GPU. Un modello che parte può comunque generare lentamente, scaldare il dispositivo o venire chiuso dal sistema sotto pressione di memoria. Anche “GPU” non significa automaticamente più veloce in ogni fase: prefill, primo token e decode sono misure diverse.
La documentazione di LiteRT-LM pubblica benchmark per dispositivo e backend, ma non li trasferirei al mio telefono. I risultati ufficiali dimostrano che hardware e acceleratore cambiano molto le prestazioni; non prevedono ciò che otterrà un modello diverso su un SoC diverso, con un altro contesto e una diversa temperatura.
Il test minimo dovrebbe quindi riportare almeno: modello e quantizzazione, dimensione, RAM del telefono, SoC, backend, lunghezza del prompt, lunghezza della risposta, tempo al primo token e velocità di decode. Senza queste condizioni, “velocissimo” e “inutilizzabile” sono entrambi giudizi poveri.
Google AI Edge Gallery non è LiteRT-LM
La distinzione evita molta confusione. Google AI Edge Gallery è l’applicazione dimostrativa: interfaccia, download e gestione modelli, chat, immagini, audio, Prompt Lab e benchmark. LiteRT-LM è il livello software di inferenza/orchestrazione pensato per gli sviluppatori che vogliono integrare LLM on-device nelle proprie applicazioni.
Google descrive LiteRT-LM come un livello production-ready, open source e multipiattaforma per eseguire LLM con LiteRT, con API per Kotlin, Python, C++ e altre piattaforme, accelerazione CPU/GPU/NPU e supporto multimodale. Gallery lo usa per offrire una prova pronta. Se vuoi capire “come si comporta un modello sul mio telefono”, parti da Gallery. Se vuoi costruire il tuo prodotto, gestire pipeline e includere l’inferenza nel codice, studia LiteRT-LM.
Il mio verdetto anti-hype
Google AI Edge Gallery è utile perché rende concreta una domanda che di solito resta astratta: quanta AI generativa posso eseguire davvero sul dispositivo che ho in tasca? Non elimina i compromessi. I modelli occupano da centinaia di megabyte a diversi gigabyte, la RAM conta, la qualità dei modelli piccoli resta limitata e il calore può cambiare la velocità nel tempo.
La consiglierei a sviluppatori, tecnici e curiosi che vogliono un laboratorio senza dover compilare un’app. Non la presenterei come sostituto garantito dei modelli cloud. Il valore sta nel fare una prova controllata: iniziare piccolo, scaricare tutto, passare in modalità aereo, misurare e decidere con numeri propri.
FAQ su Google AI Edge Gallery
Google AI Edge Gallery funziona senza internet?
Sì, l’inferenza con un modello già scaricato è progettata per funzionare on-device e offline. Serve però internet per installare l’app, scaricare i modelli e usare eventuali integrazioni o Agent Skills collegate a servizi esterni.
Quale versione di Android serve?
Il repository ufficiale indica Android 12 o successivo. La compatibilità dell’OS non garantisce che tutti i modelli siano adatti alla RAM e all’hardware del telefono.
Quanto spazio occupano i modelli?
Dipende dal modello: gli esempi verificati nella allowlist Android vanno da circa 289-584 MB per modelli piccoli e specializzati fino a circa 4,92 GB. Conviene lasciare margine oltre alla dimensione dichiarata del file.
Posso usare immagini e audio?
Sì, con un modello multimodale compatibile. Ask Image analizza foto o input della fotocamera; Audio Scribe trascrive o traduce registrazioni. Le capacità disponibili dipendono dal modello selezionato e dalla versione dell’app.
I prompt restano davvero sul telefono?
L’inferenza di base è dichiarata on-device e non richiede rete. Questo non equivale a dire che l’intera app non scambi mai dati: la scheda Play menziona possibile raccolta di attività dell’app e informazioni su app e prestazioni, mentre funzioni con servizi esterni possono richiedere rete.
Gallery e LiteRT-LM sono la stessa cosa?
No. Gallery è l’app dimostrativa pronta all’uso. LiteRT-LM è il framework/livello di orchestrazione per eseguire e integrare LLM on-device in applicazioni e piattaforme diverse.
Qual è il modello migliore?
Non esiste un migliore assoluto. Per iniziare scegli il più piccolo compatibile con il compito; passa a un modello multimodale o più grande solo se qualità e funzione giustificano maggiore spazio, RAM, calore e latenza.
Fonti ufficiali
Repository Google AI Edge Gallery
Requisiti Android, installazione, funzioni, licenza e stato beta sperimentale.
Google Play
Scheda ufficiale dell’app, funzioni, note sulle prestazioni e dichiarazioni di sicurezza dei dati.
Allowlist modelli Android
Modelli, byte del file, memoria minima, modalità e configurazioni dichiarate.
Annuncio audio e Play Store
Audio Scribe, Gemma 3n, inferenza locale e disponibilità in beta.
LiteRT-LM Overview
Ruolo del runtime, piattaforme, backend, modelli e benchmark ufficiali.
Codice LiteRT-LM
Framework open source, funzionalità e guide di integrazione.
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.