
IL PUNTO SULL’AI
16 novembre 2026
OpenAI firma con quattro valutatori esterni; Hugging Face cambia routing con OpenRouter e Hy4 Flash distingue listino e promozione Vercel.
In questa edizione 14 notizie
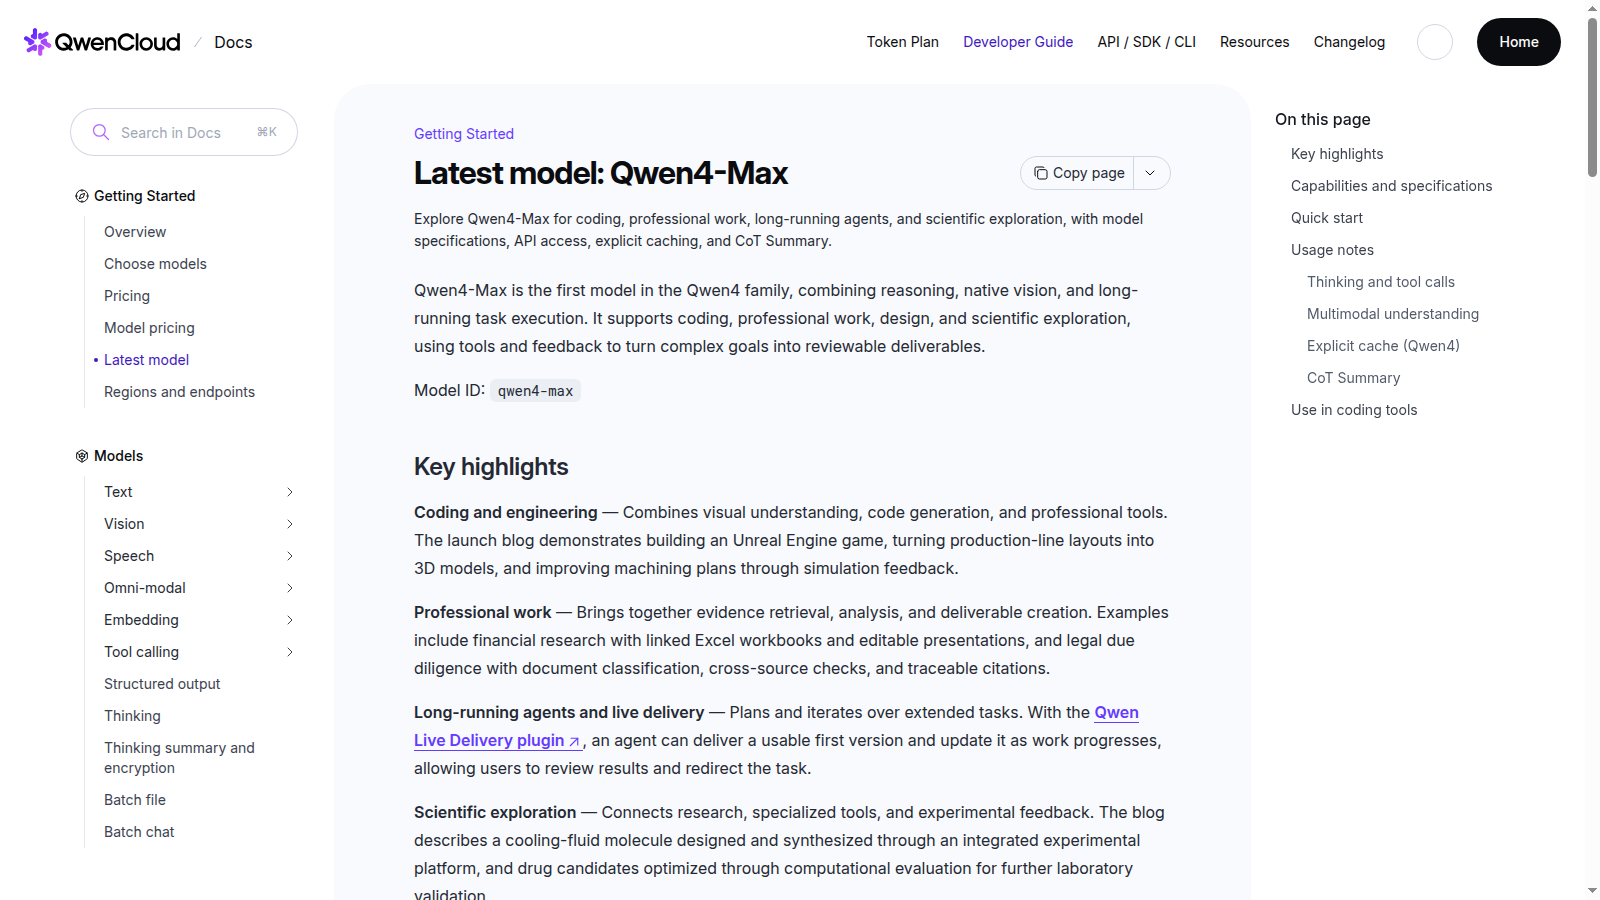
Il changelog QwenCloud registra qwen4-max il 16 novembre, dopo qwen4-max-preview dell’11 novembre. La guida corrente documenta un milione di token di contesto, function calling e output strutturati, con accesso tramite Token Plan Personal, Team o API pay-as-you-go. La distinzione utile è operativa: modello, credenziali ed endpoint vanno verificati insieme.
Limiti da conoscere
Limite: Verifica documentale, non prova operativa: accesso dell’account, costo effettivo, prestazioni e qualità non verificati. Orario esatto del lancio non indicato.
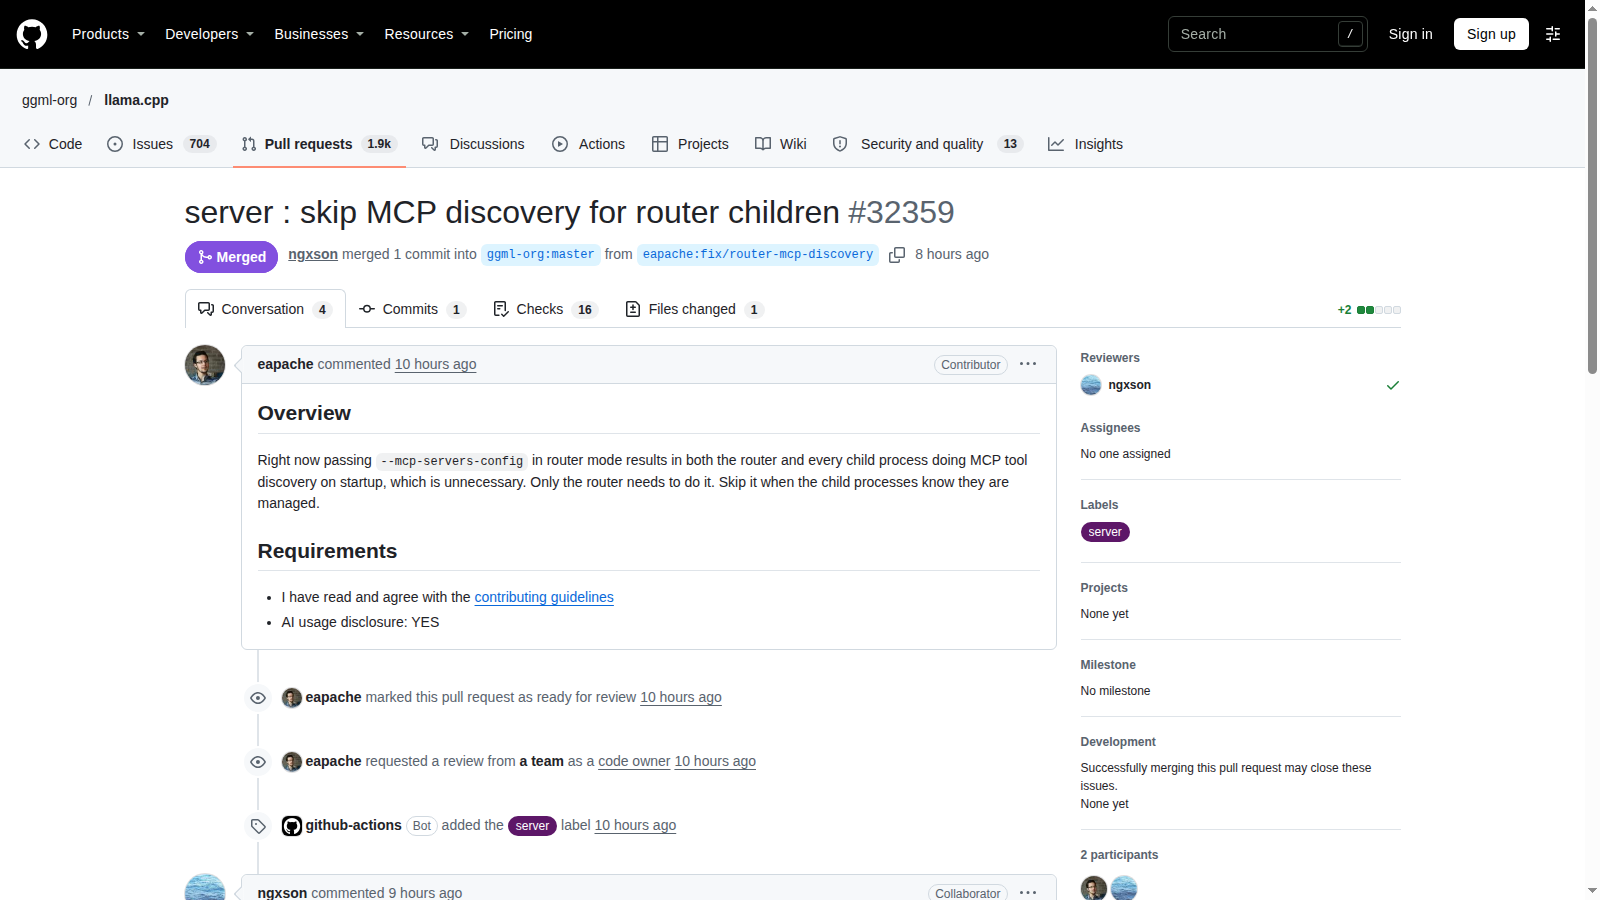
La prerelease b12427 evita che router e processi figli ripetano la discovery degli strumenti MCP all’avvio. La PR 32359 rimuove dai preset dei figli le opzioni LLAMA_ARG_MCP_SERVERS_CONFIG e LLAMA_ARG_MCP_SERVERS_JSON. Il delta riguarda l’inizializzazione: non aggiunge permessi né dimostra un aumento di velocità nell’inferenza.
Limiti da conoscere
Limite: Prerelease e verifica del diff, non test end-to-end. Discovery, autorizzazione ed esecuzione dei tool restano verifiche separate; nessun guadagno misurato.
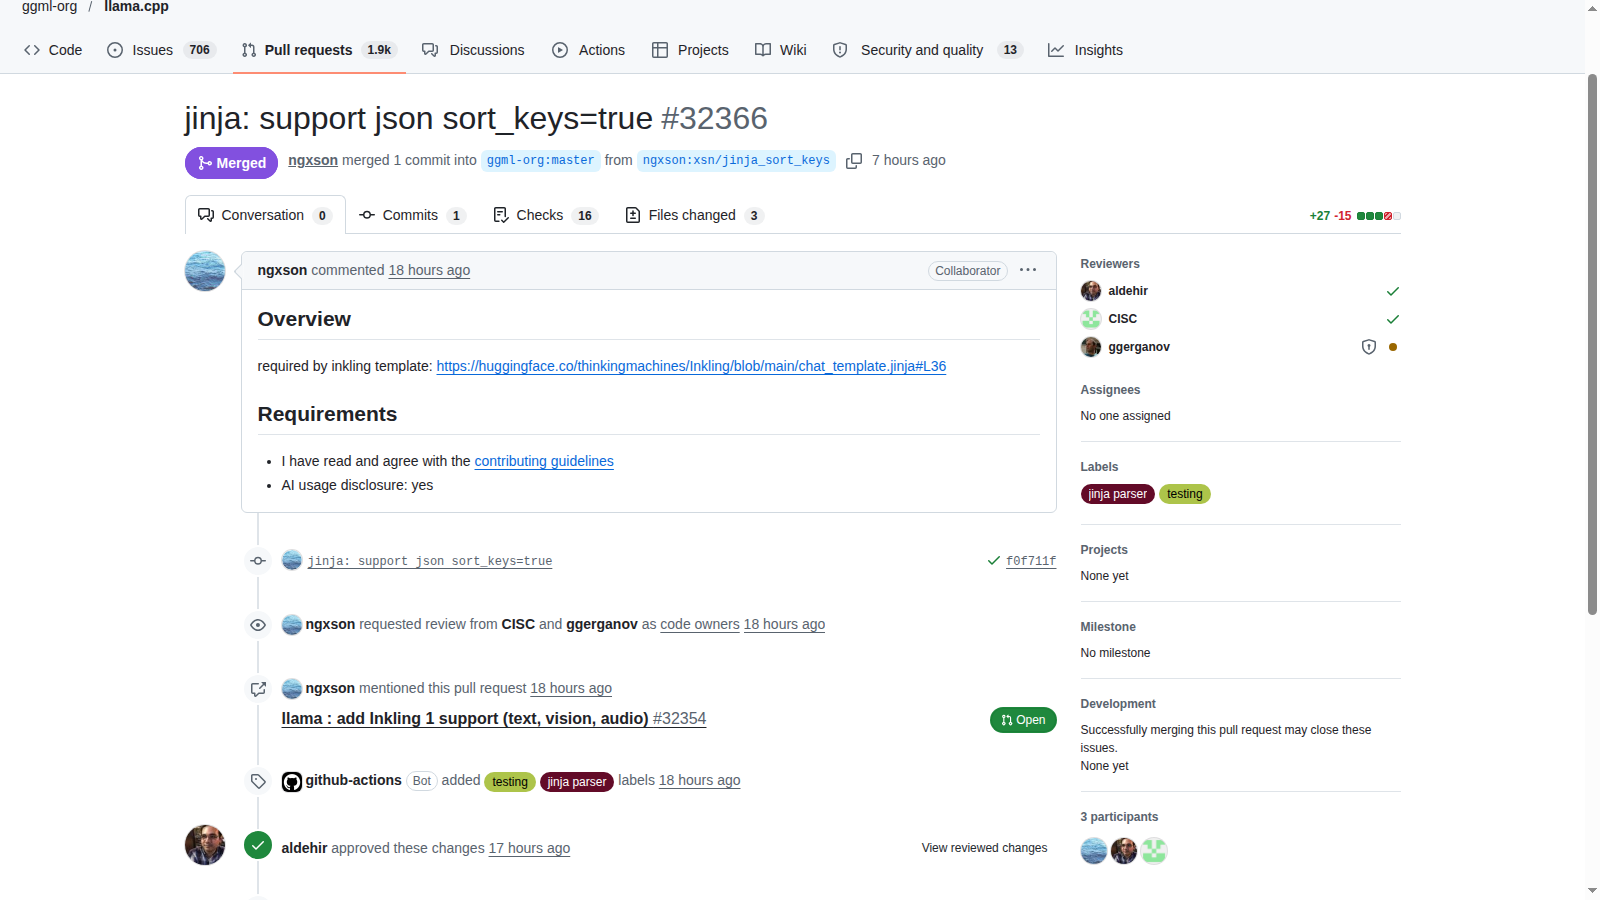
Dopo le quattro funzioni introdotte da b12428 per i template, la prerelease b12438 supporta tojson(sort_keys=true). La PR 32366 collega il cambiamento al template Inkling; il diff ordina le chiavi degli oggetti anche nelle strutture annidate e aggiunge un caso di test. È un nuovo delta di compatibilità Jinja, integrato qui senza creare una seconda notizia quasi identica.
Limiti da conoscere
Limite: Entrambi i rilasci sono prerelease. Diff e casi di test letti, non eseguiti; nessuna pipeline Kokoro o Inkling, qualità audio, inferenza o risparmio misurato in questo ciclo.
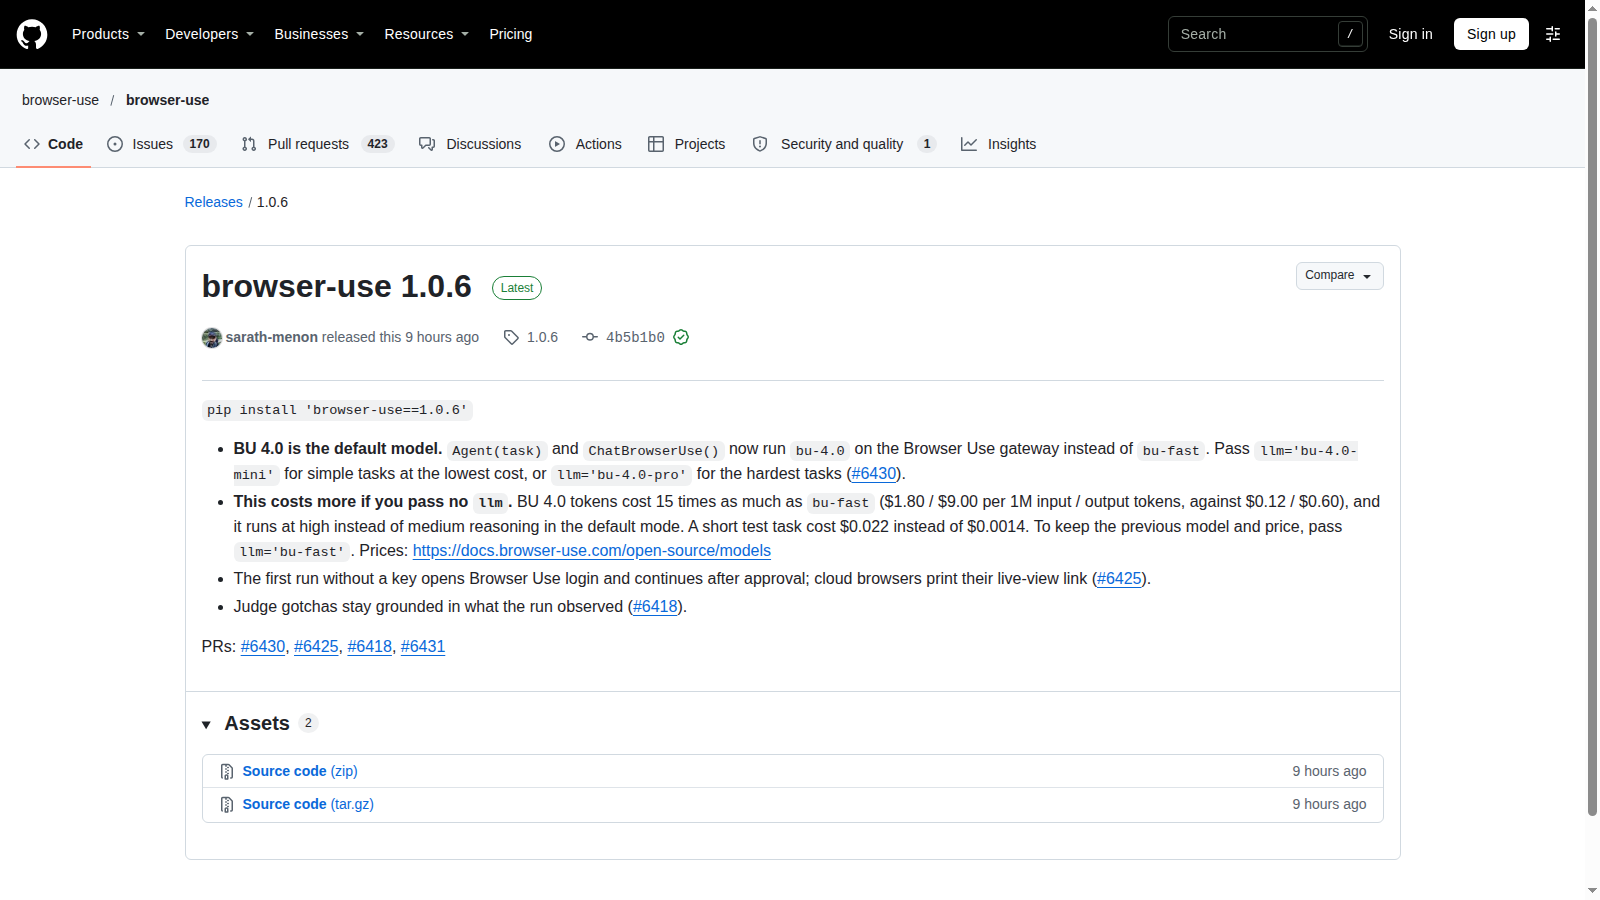
Browser Use 1.0.6 imposta bu-4.0 al posto di bu-fast quando non si specifica il modello. Le note indicano 1,80 e 9,00 USD per milione di token input/output, contro 0,12 e 0,60 USD: il rapporto 15 riguarda le tariffe token, non il costo garantito di ogni attività. Il sorgente dei tag conferma il cambio; la pagina Models mostra ancora il default precedente.
Limiti da conoscere
Limite: Tariffe attribuite alle note di release; pagina Models non allineata. Nessun costo reale, qualità o disponibilità dell'account verificati.
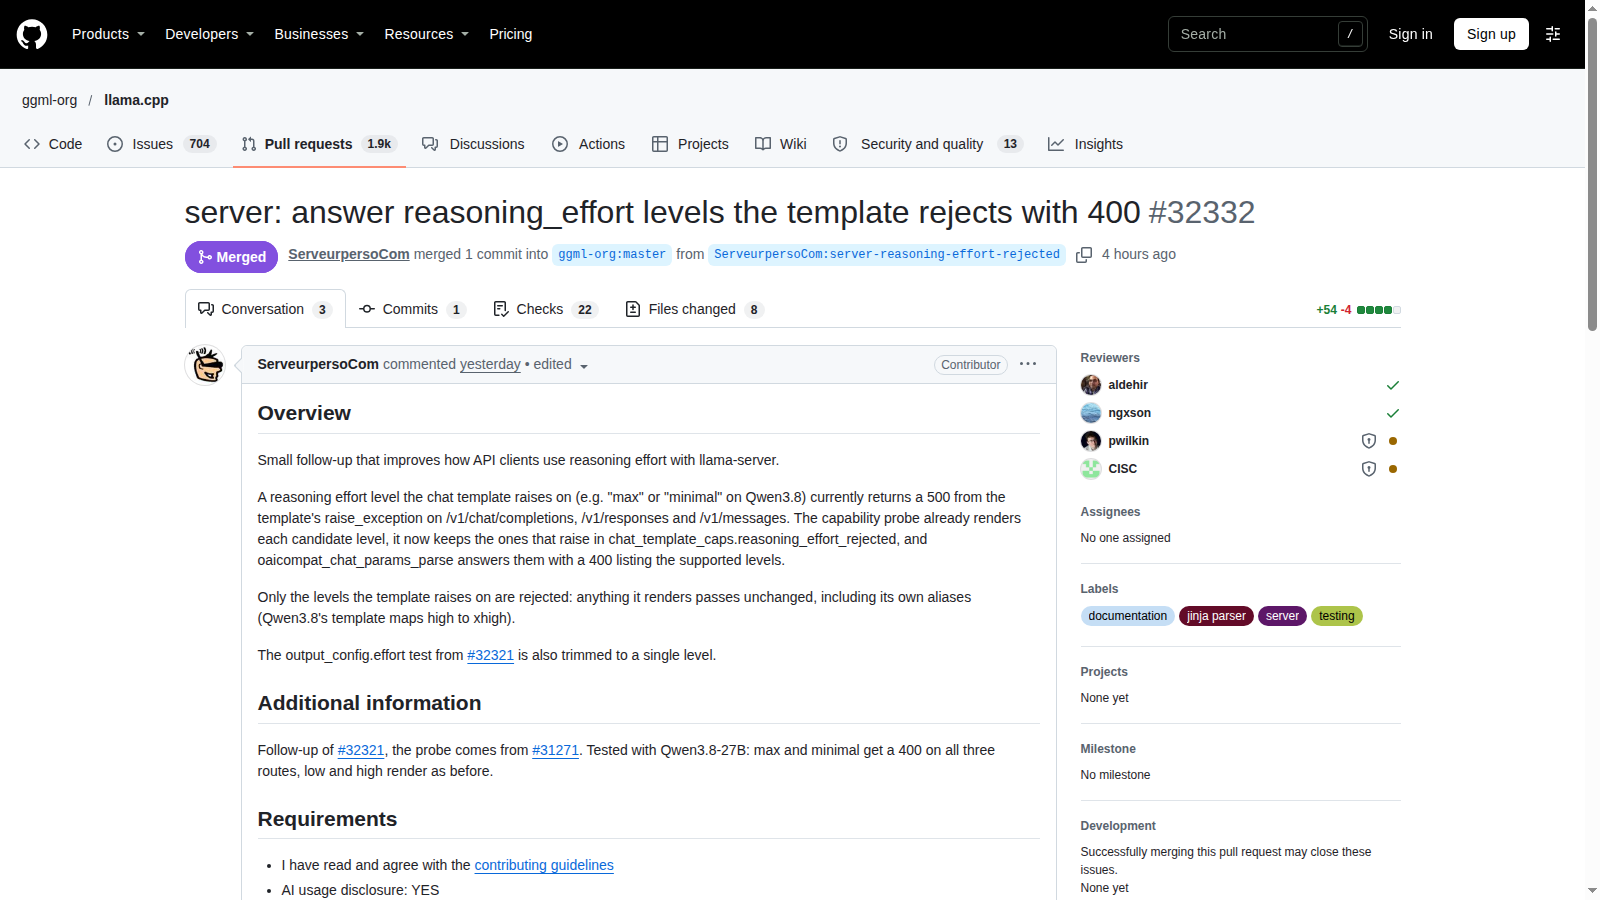
La prerelease b12431 corregge la classificazione degli errori per i livelli reasoning_effort che il template rifiuta. La PR 32332 descrive il passaggio da 500 a 400 sulle API Chat Completions, Responses e Messages, indicando i livelli supportati. Gli alias che il template accetta non vengono respinti. È un delta diverso dall'inoltro di output_config.effort già trattato.
Limiti da conoscere
Limite: Prerelease e verifica documentale. Test del progetto letti ma non eseguiti; la validazione riguarda i livelli rifiutati dal template, non tutti i valori possibili.
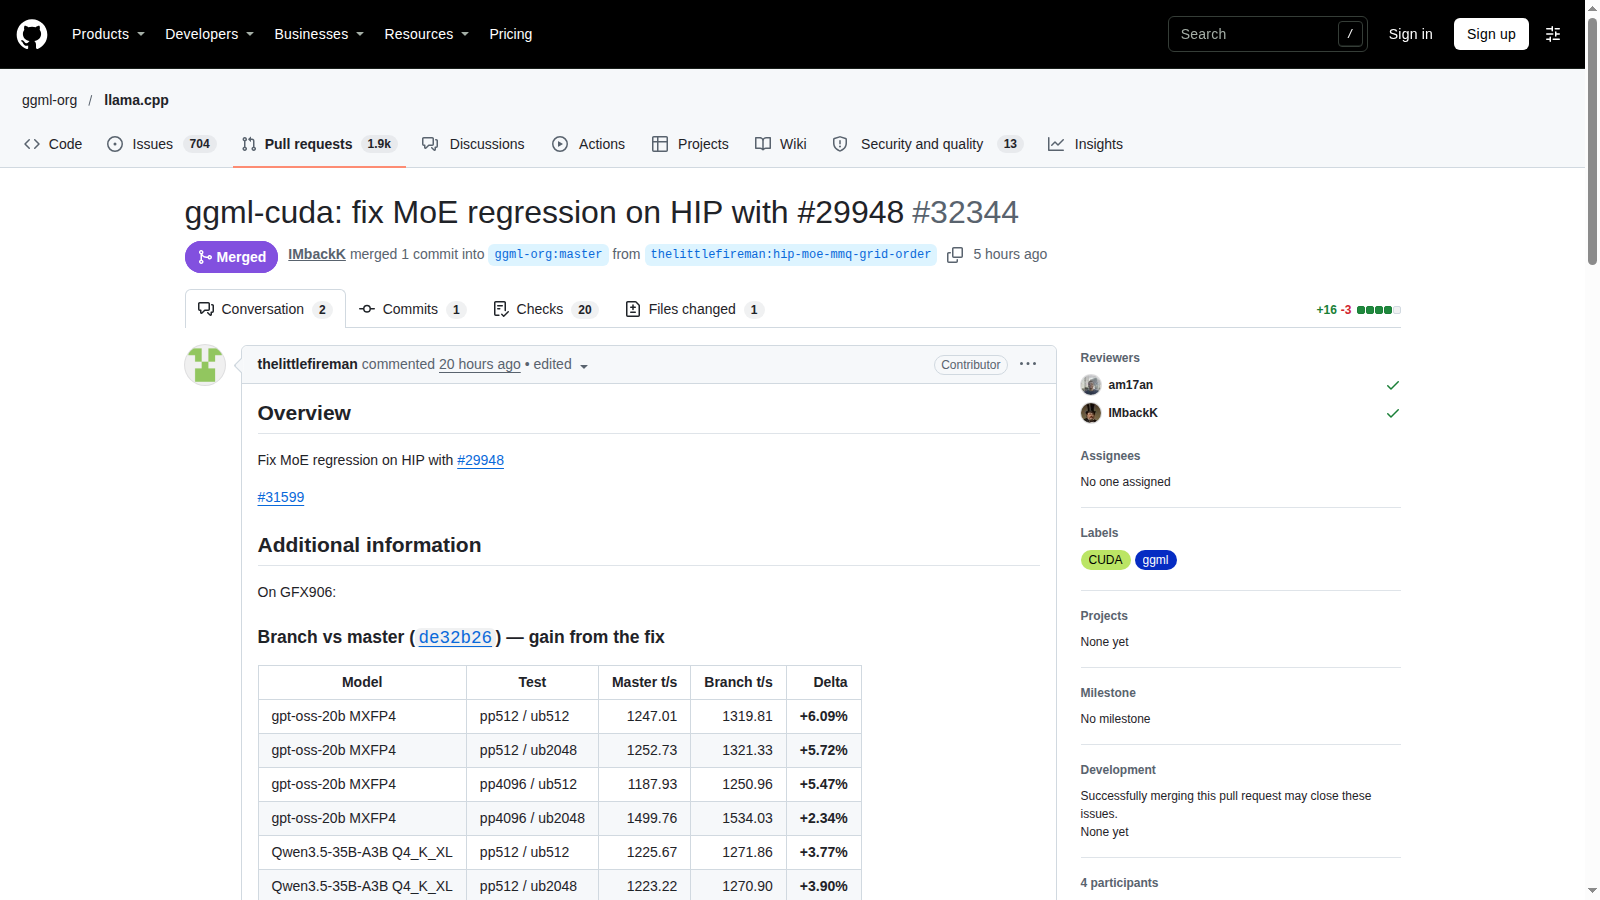
La prerelease b12430 integra la correzione di una regressione MoE nel backend HIP collegata alla PR 29948. Il diff cambia l'ordine dei tile per il percorso MoE su HIP e conserva quello dei modelli densi. L'autore pubblica confronti su GFX906: sono misure del progetto, non prestazioni verificate sull'hardware di Francesco né un guadagno universale per AMD.
Limiti da conoscere
Limite: Prerelease; benchmark GFX906 dell'autore, non riprodotti qui. Nessun guadagno dimostrato per ogni GPU AMD, backend o quantizzazione.
Google avvia l'espansione di Ask Maps in oltre 30 paesi europei. Le novità includono itinerari su più giorni e ricerca nei luoghi salvati; l'annuncio globale riserva inizialmente agli Stati Uniti la ricerca di appuntamenti e i consigli Know before you go.
Limiti da conoscere
Limite: Rollout dichiarato da Google, non disponibilità verificata per l'Italia o per ogni account. Le chiamate, le prenotazioni e l'affidabilità dei piani non sono state provate.
La prerelease b12432 integra la PR 32380: la rimozione delle celle di una sequenza usa l'indice ordinato delle posizioni invece di esaminare tutta la cache allocata. Il delta riguarda il lavoro di gestione della cache, non una nuova capacità del modello.
Limiti da conoscere
Limite: b12432 è una prerelease. I tempi pubblicati sono dell'autore su una routine isolata; non provano un aumento dei token al secondo né un beneficio su ogni configurazione.
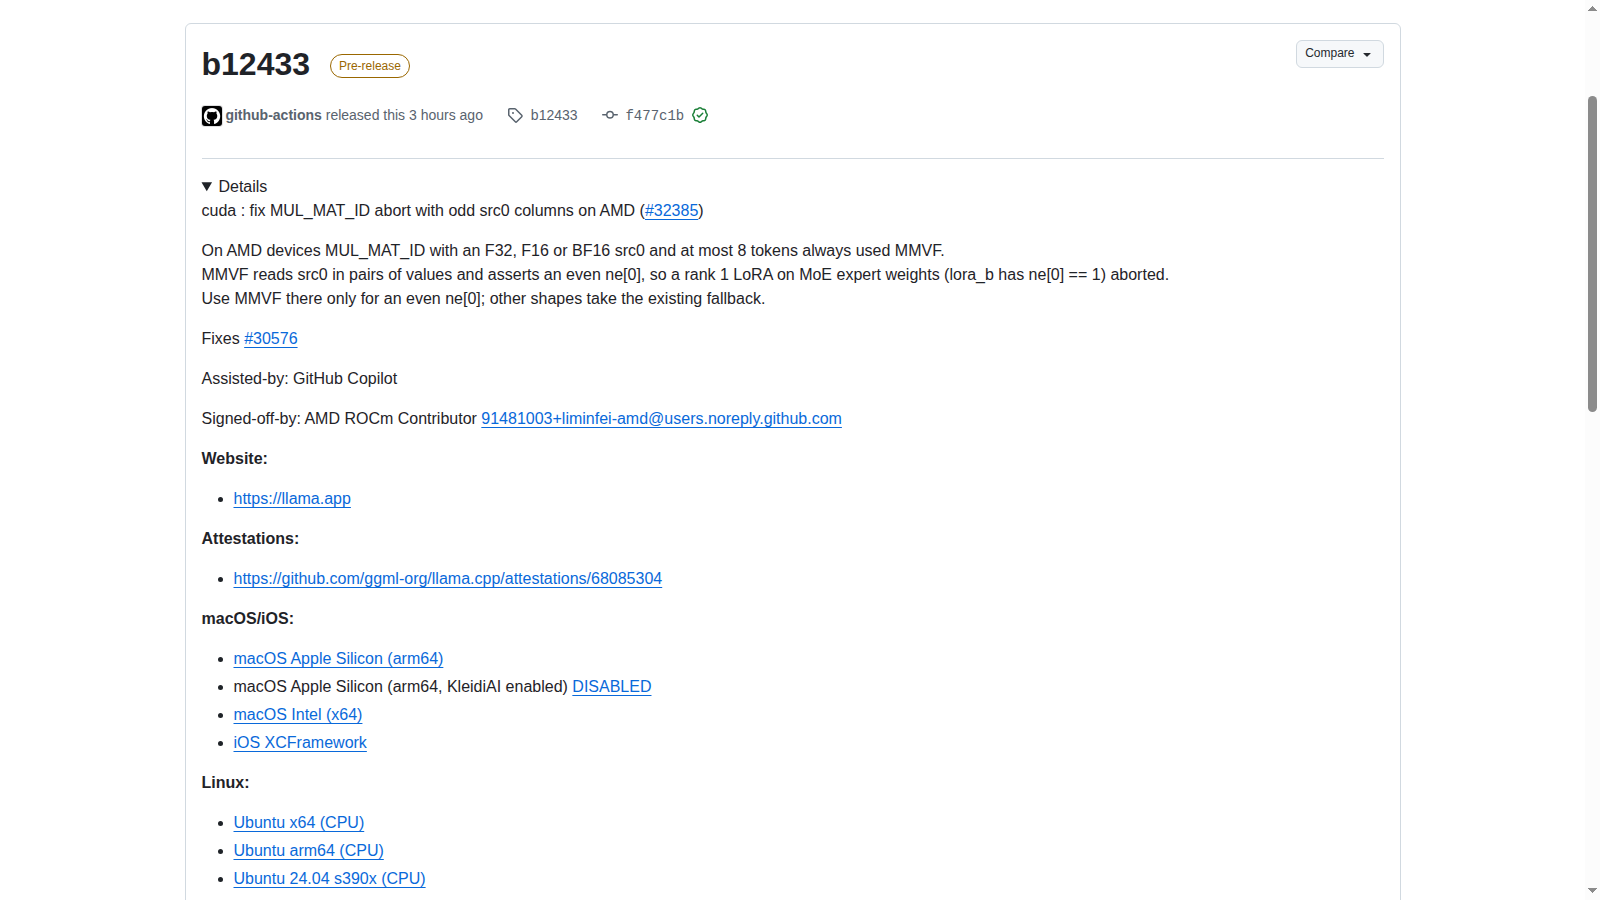
La prerelease b12433 corregge il percorso MUL_MAT_ID su AMD per matrici con un numero dispari di colonne, fra cui LoRA di rango 1 sui pesi degli esperti MoE. Il percorso veloce MMVF resta per forme pari; quelle dispari usano il fallback esistente.
Limiti da conoscere
Limite: Prerelease e prove dichiarate dall'autore su R9700/ROCm 10.1.0. Nessuna verifica qui su hardware AMD, sul modello da 24B o sull'adattatore originale dell'issue.
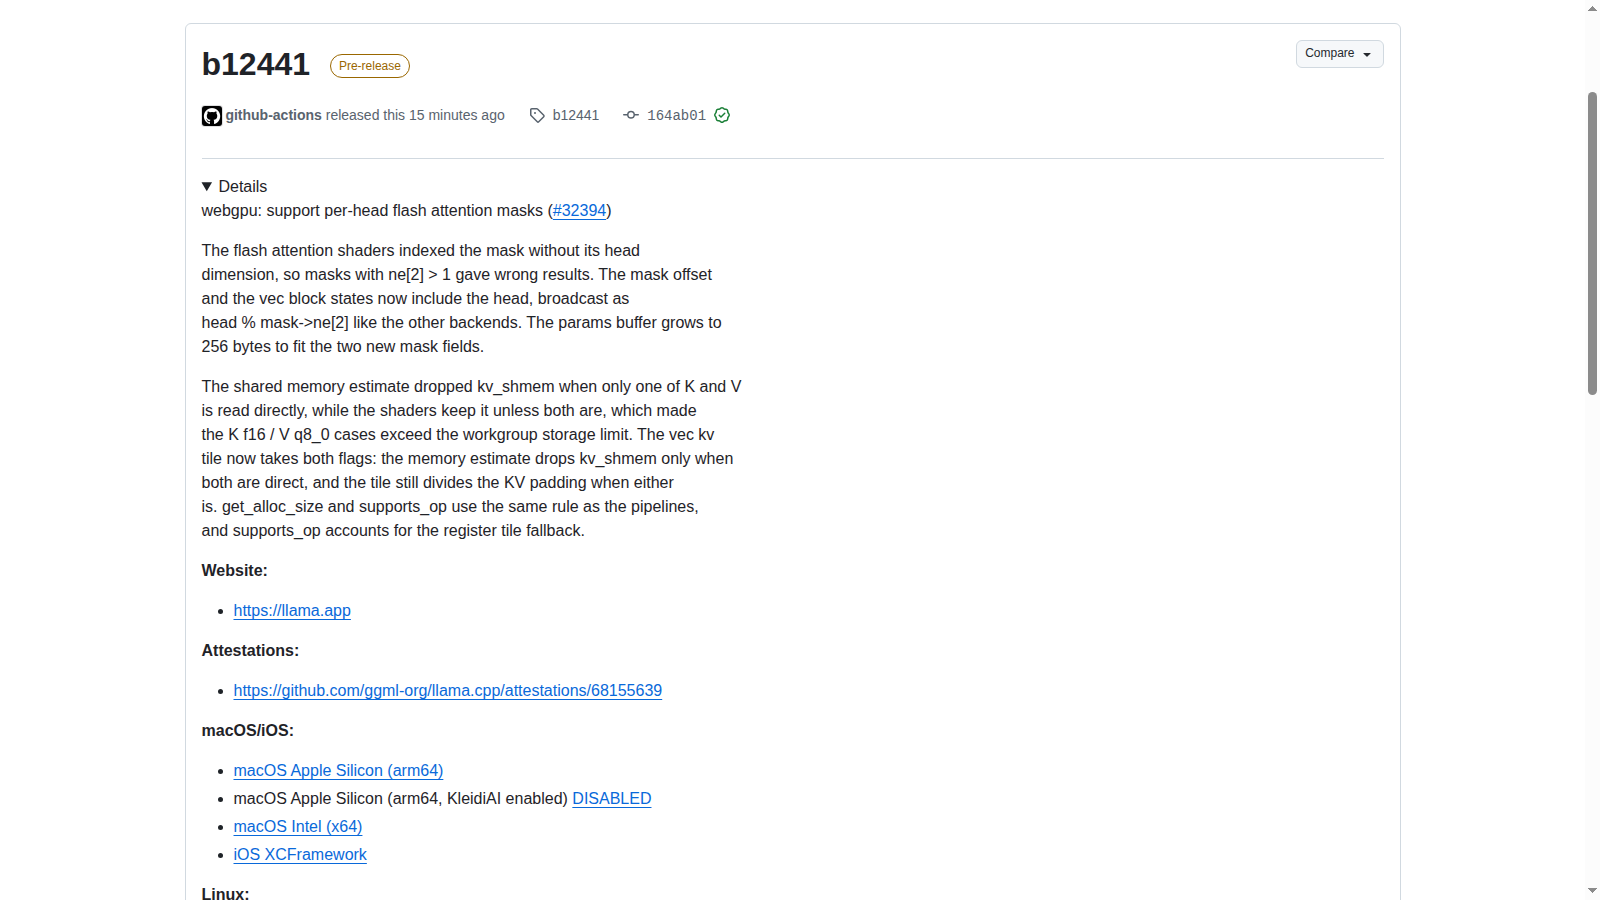
Due prerelease correggono risultati e riproducibilità dei backend: b12441 include la dimensione della testa nelle maschere flash attention WebGPU; b12435 stabilizza la selezione degli elementi a pari valore nel radix top-k Vulkan. Non sono promesse di determinismo dell'intero modello.
Limiti da conoscere
Limite: Due prerelease con ambiti distinti. Risultati degli autori e diff verificati documentalmente; nessuna prova indipendente su GPU, browser, driver o applicazione completa.
Hugging Face annuncia il passaggio del routing degli LLM di Inference Providers a OpenRouter, con scelta del provider e nuovo tentativo su un altro in caso di errore. La fattura resta su Hugging Face. Il cambiamento da controllare prima di aggiornare un agente è concreto: per i modelli linguistici non sono più accettate le chiavi personali dei singoli provider. Immagini, video e audio continuano sul percorso precedente.
Limiti da conoscere
Limite: Annuncio e documentazione letti, non migrazione o inferenza provata. Routing, velocità e risparmio non sono misure indipendenti; il servizio resta cloud e i provider consentiti vanno verificati nell'account.
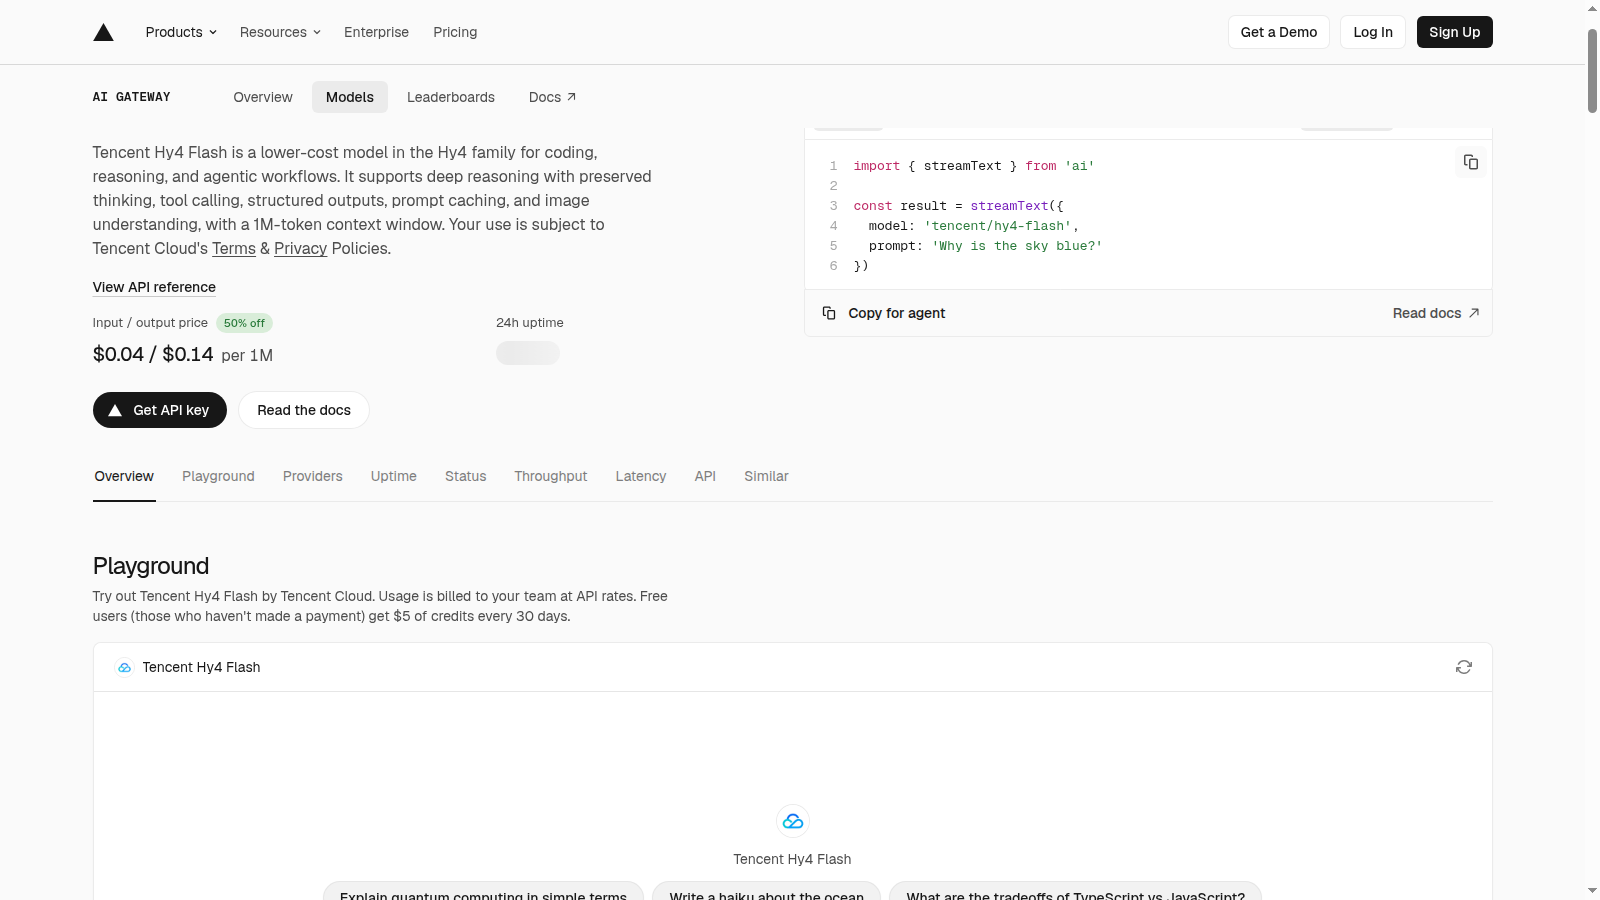
Il catalogo Vercel espone tencent/hy4-flash con 1.024.000 token di contesto e 64.000 di output massimo. I valori API, espressi per token, corrispondono a 0,035 dollari per milione in input e 0,1405 in output. La pagina mostra una promozione del 50%: non va confusa con il listino annunciato da Tencent di 0,070 e 0,281 dollari. Nessun risparmio su un lavoro reale è stato misurato qui.
Limiti da conoscere
Limite: Confronto documentale delle tariffe, senza inferenza o addebito misurato. Durata della promozione, disponibilità dell'account, parità qualitativa e download dei pesi non verificati.
Anthropic annuncia una finestra di disclosure di 30 giorni per vulnerabilità alte e critiche e di 45 giorni per le altre, al posto dei 90 giorni. Si applica alle segnalazioni inviate dal 1° gennaio 2027; quelle già in corso mantengono le scadenze esistenti. Cambiano anche escalation e attesa dopo la patch. Non è un nuovo obbligo generale per tutti i ricercatori né una modifica al programma per segnalare bug ad Anthropic.
Limiti da conoscere
Limite: È una policy di disclosure del fornitore, non una legge né un test indipendente dell'efficacia delle patch. Le nuove finestre decorrono dal 2027; eccezioni e rapporti già aperti richiedono la loro scadenza specifica.
OpenAI annuncia accordi con Apollo Research, METR, Transluce e Goodfire per valutazioni con accesso a risorse interne. I perimetri differiscono e alcune attività restano da concordare: l’annuncio non presenta un giudizio finale condiviso sulla sicurezza dei modelli.
Limiti da conoscere
Limite: Sono impegni e protocolli descritti dai soggetti coinvolti, non un audit svolto qui. Alcuni perimetri e attività future restano da concordare; nessuna sicurezza generale o verifica end-to-end è dimostrata da questo annuncio.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.