
L’ANALISI
llama.cpp: correzione della regressione MoE su HIP
llama.cpp b12430 corregge la regressione MoE su HIP legata alla PR 29948: le misure pubblicate riguardano GFX906, non tutte le GPU AMD.
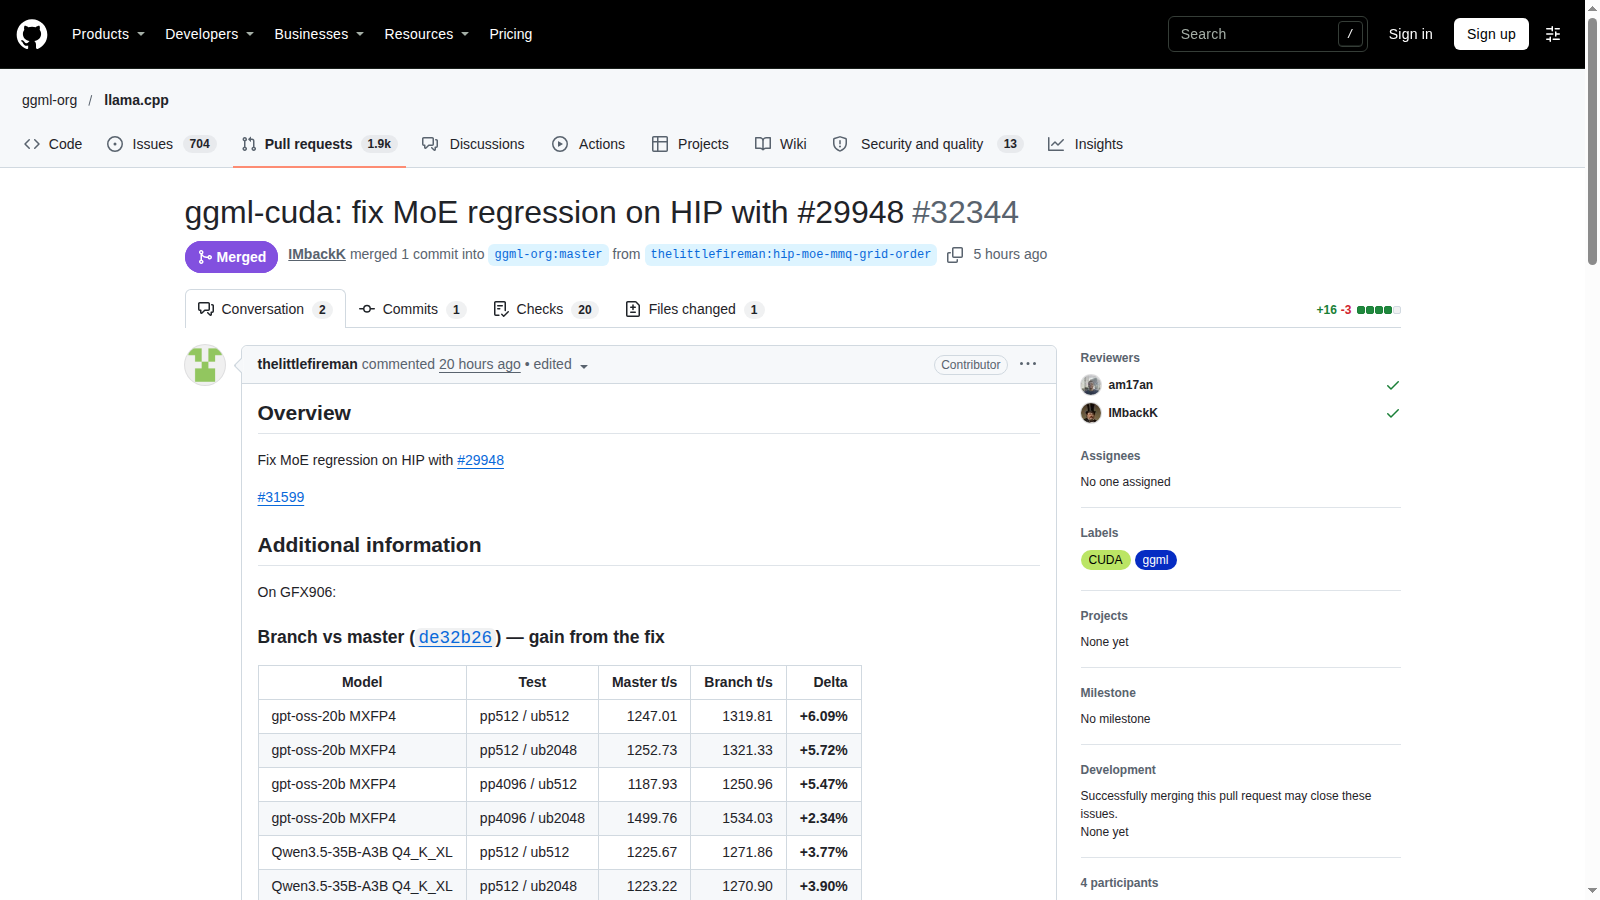
In breve: llama.cpp b12430 include la PR 32344, che corregge una regressione MoE sul percorso HIP dopo la modifica 29948. Il diff rimette le righe come dimensione interna dei tile per MoE su HIP e mantiene l'ordine precedente per i casi densi. I benchmark pubblicati dall'autore riguardano GFX906 e configurazioni specifiche. Non dimostrano la stessa variazione su ogni GPU AMD. PR 32344: regressione HIP e misure GFX906 dell'autore.
Verifica documentale del 16 novembre 2026 sulla prerelease b12430, PR 32344 e diff. Commit di unione 05db09a4d3c3c1caa7cda31f98eca6ae28d92eb5. La release risulta pubblicata alle 07:35:34 ora italiana. Nessuna compilazione, inferenza, modifica di driver o prova su GPU effettuata per questa nota.
Quale percorso corregge la PR?
La PR collega la regressione MoE alla precedente modifica 29948. Nel file ggml/src/ggml-cuda/mmq.cuh, il codice protetto da GGML_USE_HIP distingue il caso con ids_dst dal caso denso. Per MoE imposta le righe come dimensione interna dei tile e aggiorna il corrispondente calcolo degli indici. Il nome della directory CUDA non basta a definire il backend interessato: qui il ramo condizionale HIP è la prova che delimita la modifica.
Diff della PR 32344: ordine dei tile MoE e ramo HIP · PR 32344: regressione HIP e misure GFX906 dell'autore.
Perché non è un'accelerazione generale delle GPU AMD?
I commenti del diff spiegano che, nel caso MoE, i tile di colonna sono legati agli esperti e possono raggruppare blocchi con durate diverse, penalizzando lo scheduling descritto. Il percorso denso conserva invece l'ordine per colonne. È una correzione specifica, non una nuova architettura di modello, un requisito ROCm diverso o una misura sul backend Vulkan. Per sapere se riguarda una configurazione concreta occorre prima identificare backend, tipo di modello e revisione utilizzata.
Diff della PR 32344: ordine dei tile MoE e ramo HIP.
Come leggere i benchmark GFX906 pubblicati?
L'autore separa il confronto con master da quello con una revisione precedente alla PR 29948 e aggiunge un controllo denso. Le righe usano modelli, quantizzazioni, prompt e microbatch specifici. Il riferimento di confronto cambia il significato del delta: due percentuali con baseline diverse non sono la stessa misura. I numeri restano risultati riportati dall'autore. Qui non si attribuiscono miglioramenti a RDNA, ad altre GPU o ai dispositivi di Francesco senza una riproduzione equivalente.
PR 32344: regressione HIP e misure GFX906 dell'autore.
Come impostare un confronto ripetibile?
La procedura proposta conserva una revisione di partenza e una contenente il fix, con lo stesso compilatore, backend, modello, quantizzazione e carico. Si registrano separatamente prompt processing e generazione, insieme a batch, microbatch e condizioni della GPU. Un controllo denso può aiutare a verificare il perimetro della modifica senza trasformarlo in una prova universale. Prima di aggiornare un servizio reale occorre una verifica in laboratorio e un ritorno praticabile alla revisione precedente. Questo confronto non è stato eseguito.
PR 32344: regressione HIP e misure GFX906 dell'autore · Diff della PR 32344: ordine dei tile MoE e ramo HIP · Prerelease llama.cpp b12430 e data di pubblicazione.
Checklist prima di procedere
- Confermare che il backend sia HIP e che il carico interessato sia MoE.
- Fissare b12430 o una revisione contenente la PR 32344.
- Mantenere identici modello, quantizzazione, compilazione e carico.
- Annotare la baseline precisa prima di confrontare percentuali.
- Separare prompt processing e generazione nei risultati.
- Non estendere i benchmark GFX906 a tutto l'hardware AMD.
Condizioni e limiti: Prerelease; benchmark GFX906 dell'autore, non riprodotti qui. Nessun guadagno dimostrato per ogni GPU AMD, backend o quantizzazione.