
L’ANALISI
llama.cpp: maschere WebGPU e spareggi Vulkan corretti
llama.cpp b12441 corregge maschere flash attention per testa su WebGPU; b12435 rende deterministici gli spareggi nel radix top-k Vulkan.
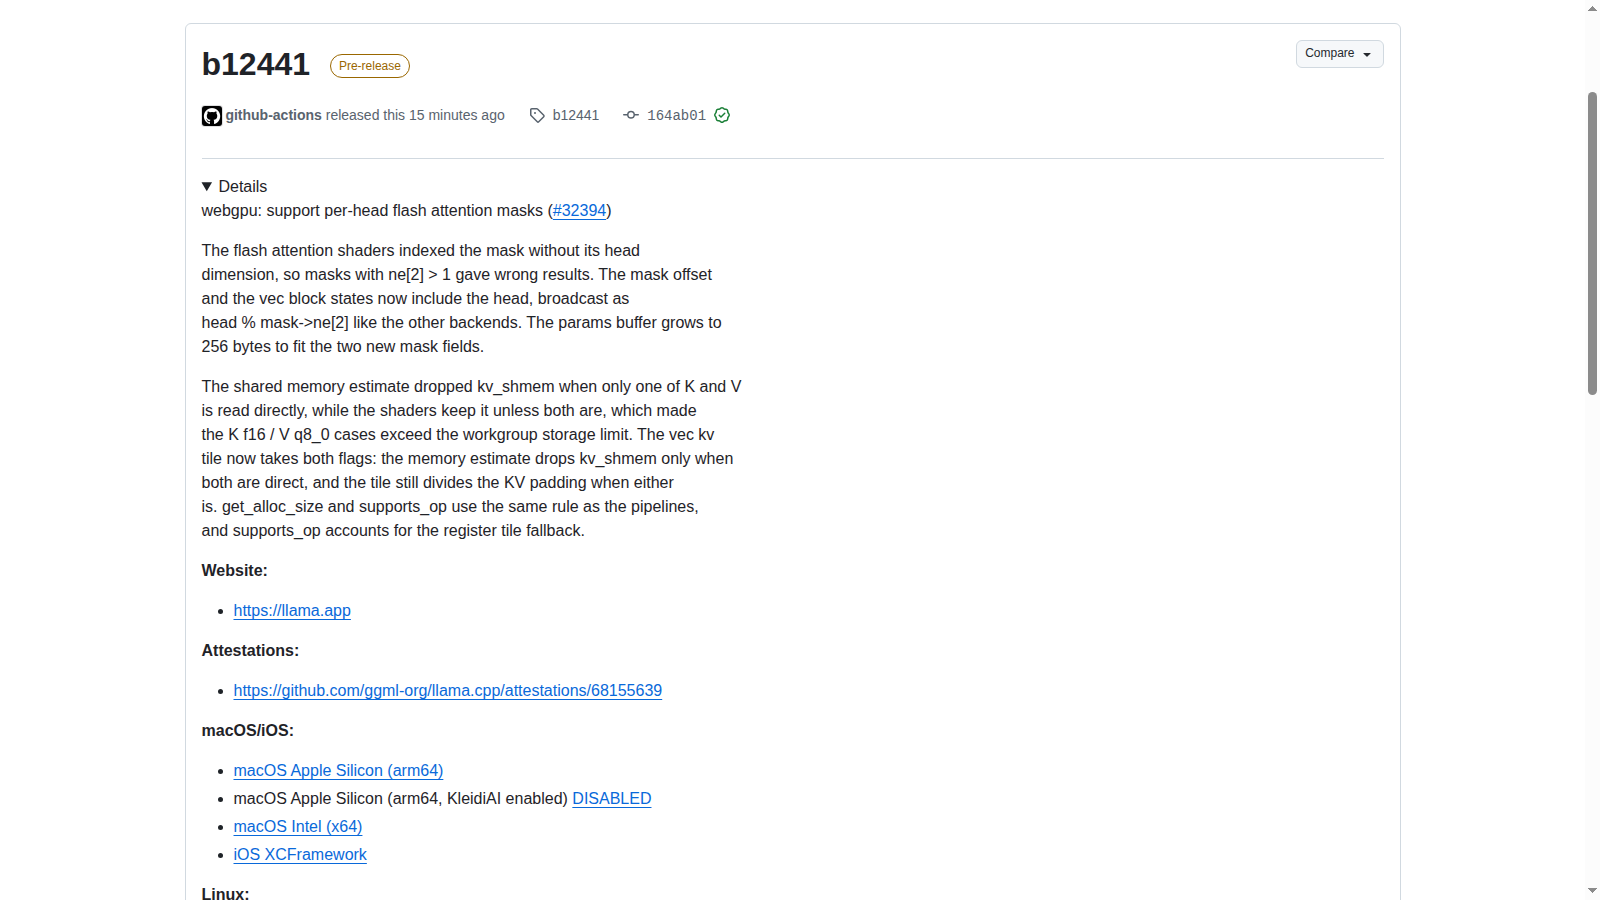
In breve: llama.cpp corregge due problemi distinti: b12441 gestisce le maschere flash attention per testa su WebGPU, mentre b12435 rende deterministici gli spareggi del radix top-k Vulkan. Il perimetro sono queste operazioni, non tutta la generazione. llama.cpp b12441: maschere WebGPU per testa.
Metodo: Lettura delle release, delle PR 32394 e 31931 e del diff WebGPU. Nessun test GPU indipendente; i conteggi di test e gli esiti hardware restano attribuiti agli autori.
Quale errore corregge WebGPU?
La PR 32394 descrive maschere con più sezioni per testa, usate da Inkling 2. Gli shader non consideravano quella dimensione nell'indicizzazione. La patch aggiunge offset e stato per testa; corregge anche la stima della memoria condivisa quando soltanto K oppure V è letto direttamente. Sono condizioni specifiche, non un'indicazione che ogni output WebGPU precedente fosse errato. PR 32394: condizioni WebGPU e prove dichiarate.
Che cosa rende più stabile Vulkan?
La PR 31931 riguarda il radix top-k, inclusa la via TOPK_QSA: con più valori uguali dei posti rimasti, la scelta dipendeva dall'ordine dei thread. Il nuovo criterio privilegia le colonne con indice più basso. I percorsi nary e bitonic erano già deterministici secondo la PR. Stabilizzare uno spareggio non elimina tutte le altre possibili fonti di variazione. PR 32394: condizioni WebGPU e prove dichiarate.
Come leggere i test pubblicati?
Per WebGPU l'autore riporta test FLASH_ATTN_EXT con NVIDIA e Dawn, inclusi i casi mask_heads. La PR Vulkan riporta test TOP_K e TOPK_QSA, ma segnala anche revisioni del codice e rimanda ai commenti per misure successive. Qui non vengono riprese quelle prestazioni come definitive. La disponibilità delle prerelease non prova l'esito sul browser o sul driver del lettore. llama.cpp b12435: spareggi radix top-k Vulkan.
Quale controllo fare prima di un benchmark?
Protocollo suggerito: scegli prima il backend realmente usato e un caso che eserciti l'operazione corretta. Per WebGPU conserva forma e maschera dei tensori; per Vulkan ripeti un caso con parità al confine top-k. Registra output ed eventuali errori prima dei tempi. Poi prova il carico applicativo invariato, senza trasformare un test di un'operazione in una garanzia sull'intero modello. llama.cpp b12435: spareggi radix top-k Vulkan.
Condizioni e limitazioni
Due prerelease con ambiti distinti. Risultati degli autori e diff verificati documentalmente; nessuna prova indipendente su GPU, browser, driver o applicazione completa.
Checklist pratica
- Distingui b12441/WebGPU da b12435/Vulkan e registra il commit.
- Mantieni invariati driver, backend, forme e precisione dei tensori.
- Controlla le maschere per testa oppure gli spareggi top-k, secondo il caso.
- Ripeti il test e conserva output ed errori, non soltanto i tempi.
- Non chiamare deterministica l'intera generazione per un solo operatore corretto.