
IL PUNTO SULL’AI
15 novembre 2026
llama.cpp integra Higgs v3 STT e VibeVoice-ASR e corregge Qwen3-ForcedAligner; restano i fix a ROCm, Inkling 2 e ai tool locali.
In questa edizione 9 notizie
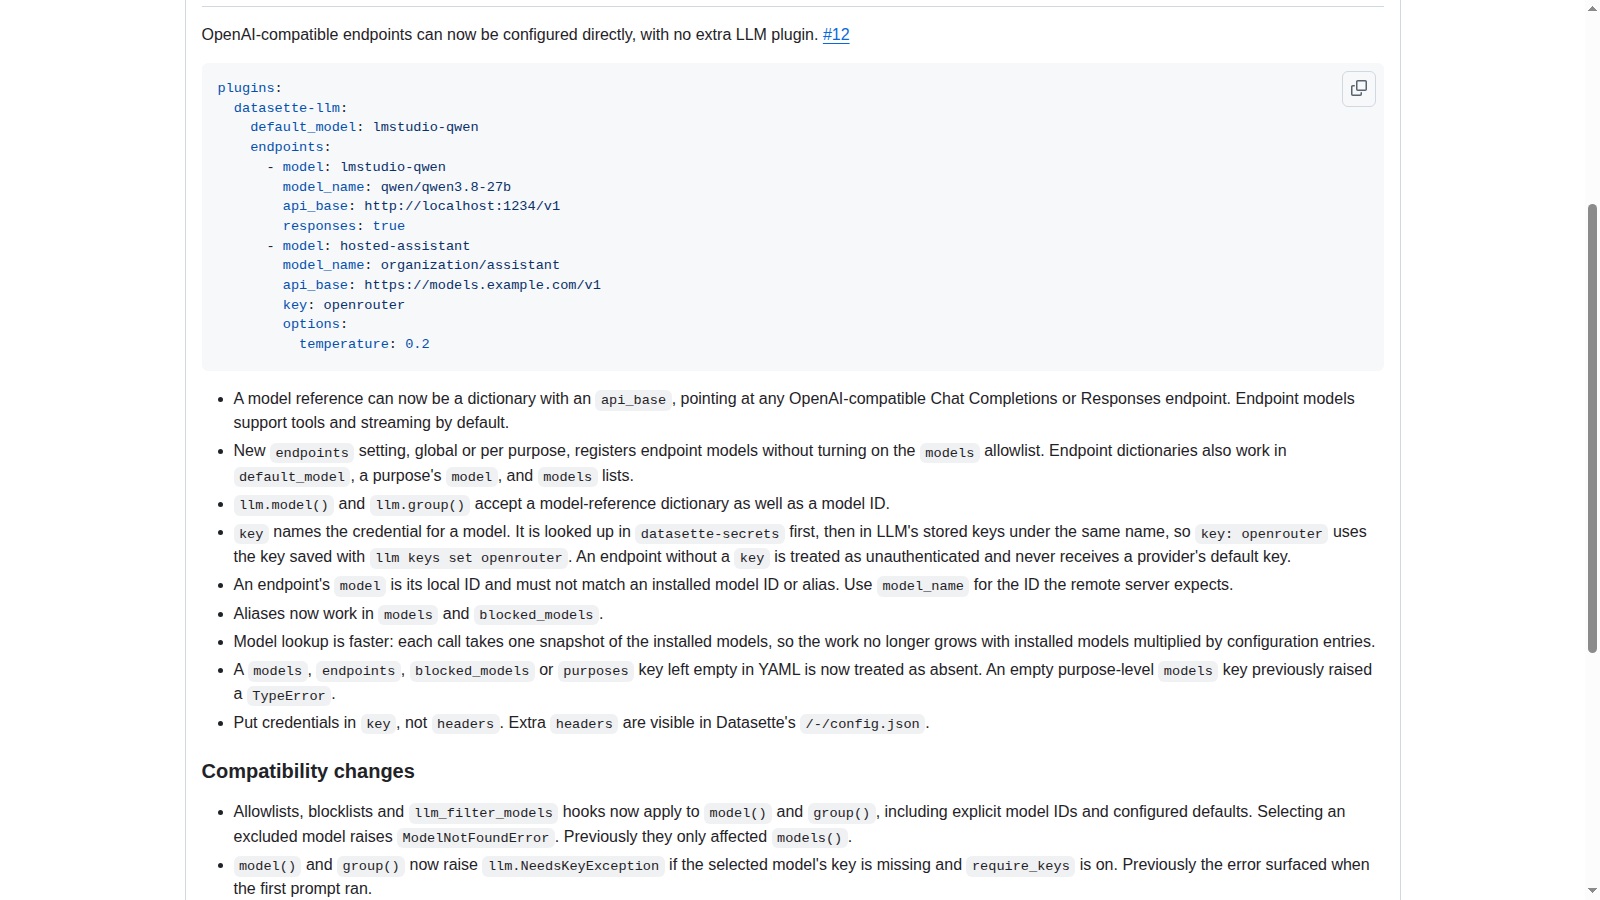
La prerelease 0.1a11 di datasette-llm consente di configurare direttamente endpoint Chat Completions o Responses compatibili OpenAI, anche verso un server locale. Richiede LLM 0.37.1 o successivo. La registrazione degli endpoint non attiva da sola una lista di modelli consentiti: accesso, chiavi e protocollo vanno configurati separatamente.
Limiti da conoscere
Limite: È una prerelease. La compatibilità dell'API non prova qualità delle risposte, isolamento dei dati o sicurezza delle query; nessun test SQL o runtime eseguito qui.
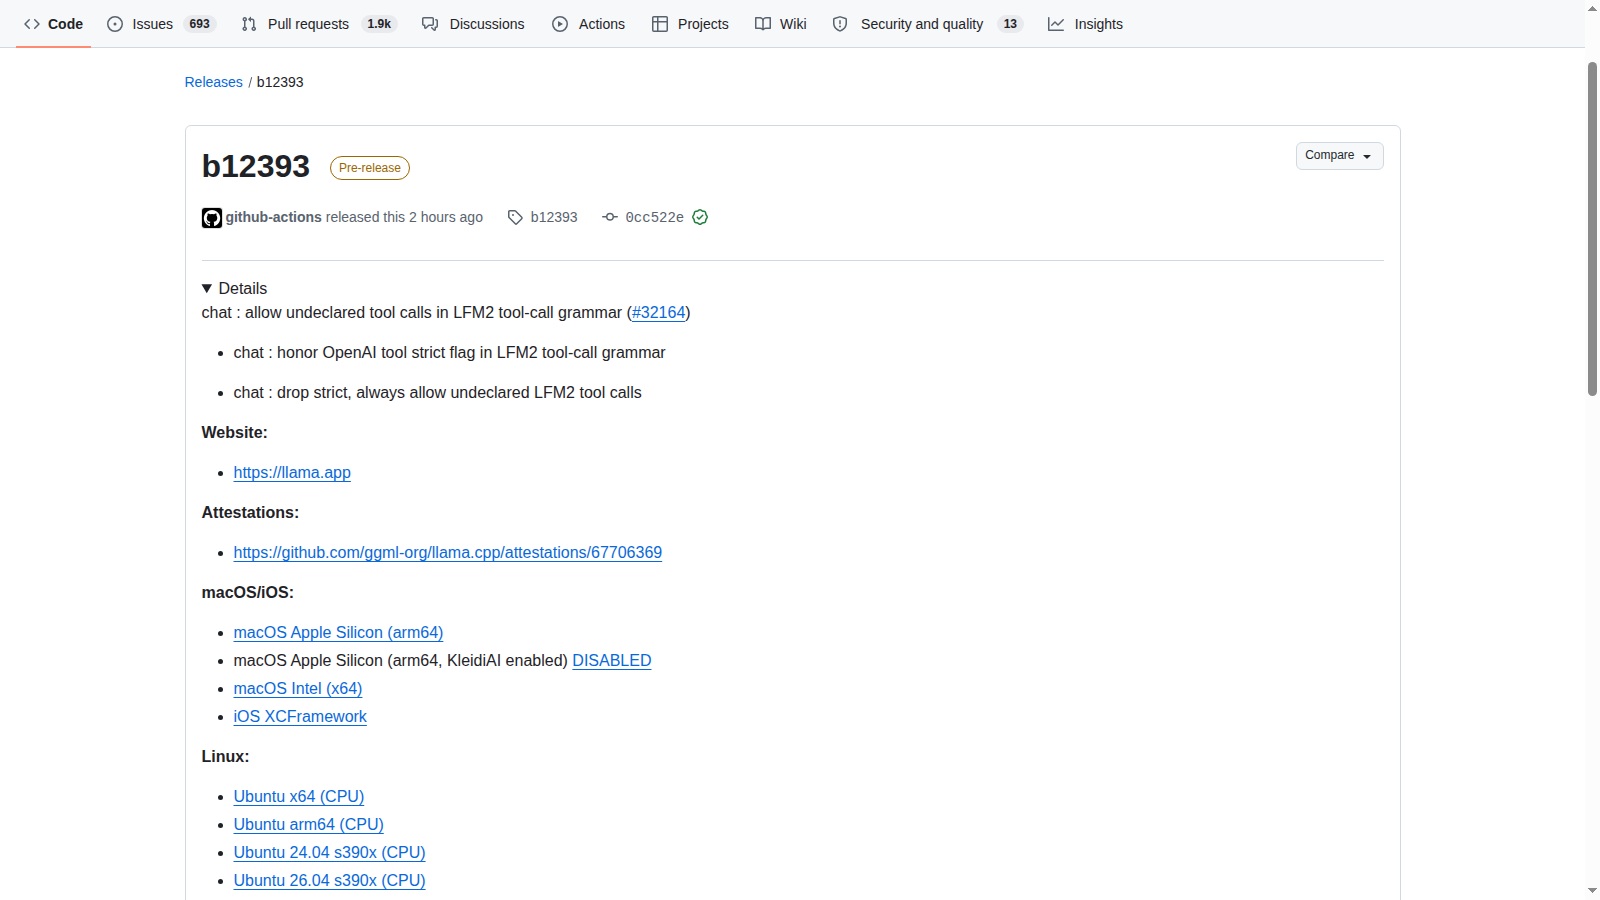
La prerelease b12393 cambia la grammatica dei tool per LFM2: con un elenco tools non vuoto, nomi non presenti nella richiesta possono restare chiamate strutturate, invece di essere forzati verso tool dichiarati. Il diff include casi di test dedicati. È un cambiamento di parsing, non la prova che un agente possa eseguire funzioni non autorizzate.
Limiti da conoscere
Limite: Il cambiamento verificato è nel percorso LFM2 con tools non vuoto. Non dimostra lo stesso comportamento senza tool dichiarati, esecuzione arbitraria o un aggiramento dei permessi.
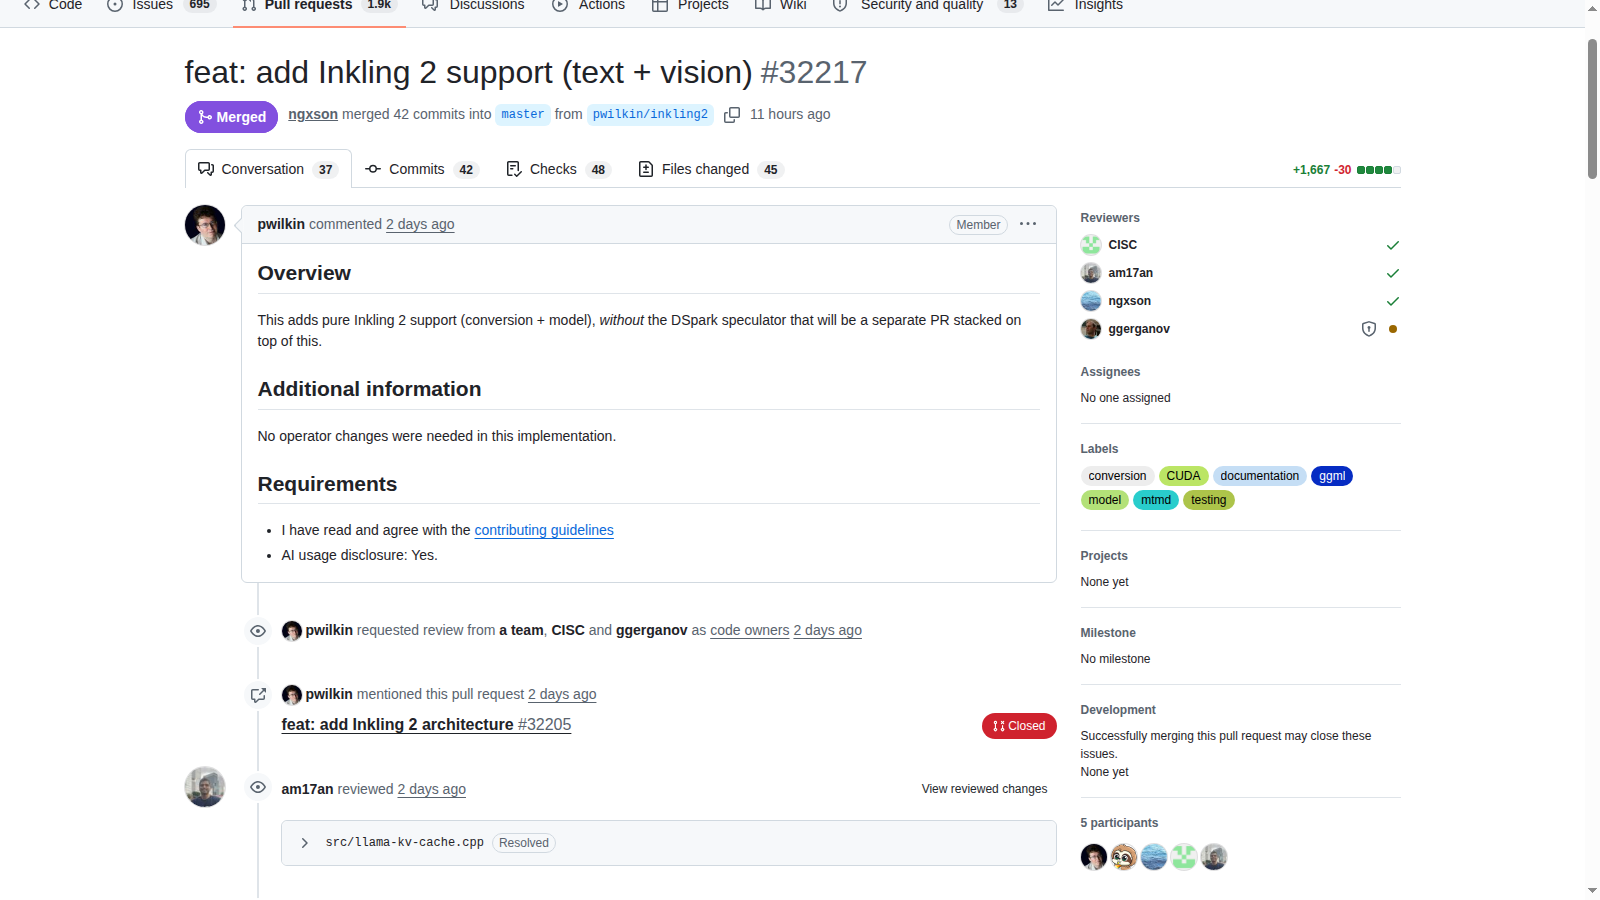
llama.cpp integra conversione GGUF e inferenza di Inkling 2 per testo e immagini, senza DSpark. La prerelease b12413 corregge inoltre i token immagine della chat: la PR elimina un blocco di testo vuoto e aggiunge sei casi di regressione nel codice dei test.
Limiti da conoscere
Limite: Prerelease e analisi del codice, non prova d’inferenza. DSpark escluso; il checkpoint completo non è stato convertito o eseguito in questo controllo. I requisiti GPU della model card non certificano un percorso GGUF domestico.
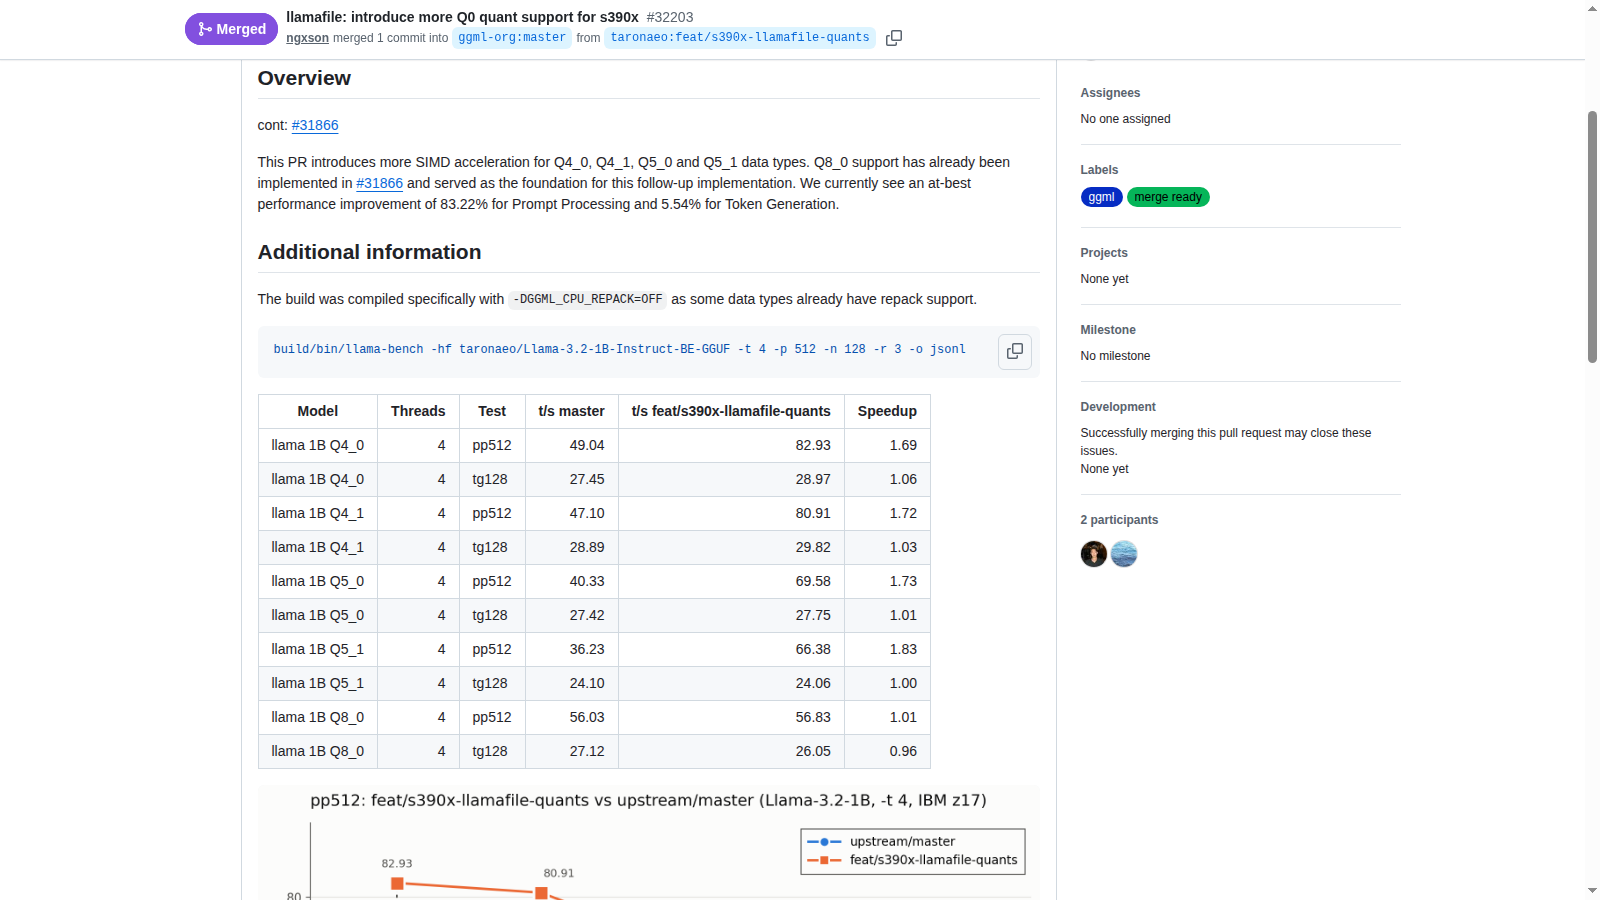
La prerelease b12401 estende il percorso SIMD di s390x a Q4_0, Q4_1, Q5_0 e Q5_1. Nella prova pubblicata dall’autore, il vantaggio sul prompt è maggiore di quello in generazione. Il test usa quattro thread e GGML_CPU_REPACK=OFF: non è un risultato valido per qualunque backend.
Limiti da conoscere
Limite: Benchmark dell’autore della PR, non replica indipendente. Risultati circoscritti a s390x, al modello e alle opzioni dichiarate; repack disattivato. Nessun beneficio equivalente dimostrato per altri backend.
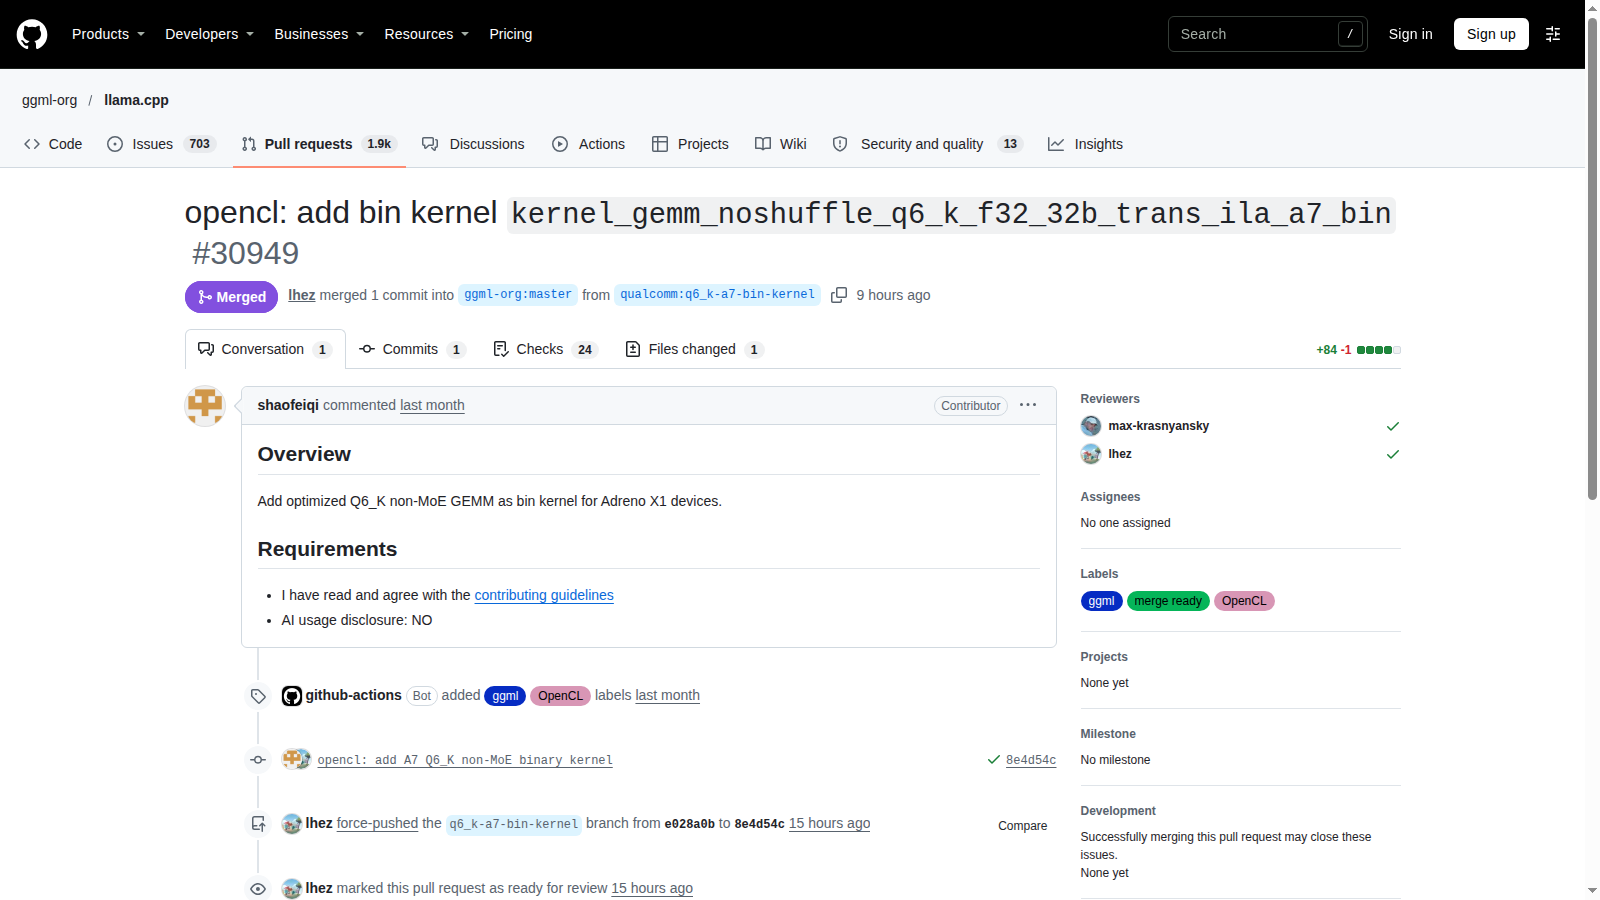
La prerelease b12408 integra un kernel binario GEMM Q6_K per dispositivi Adreno X1, nel percorso non-MoE del backend OpenCL. È un’estensione mirata del runtime: il codice controlla disponibilità dei kernel e forma dei tensori prima di scegliere quel percorso.
Limiti da conoscere
Limite: È una prerelease e il delta è specifico: Adreno X1, backend OpenCL e GEMM Q6_K non-MoE. Nessun test hardware indipendente, benchmark numerico o miglioramento garantito è stato verificato in questa analisi.
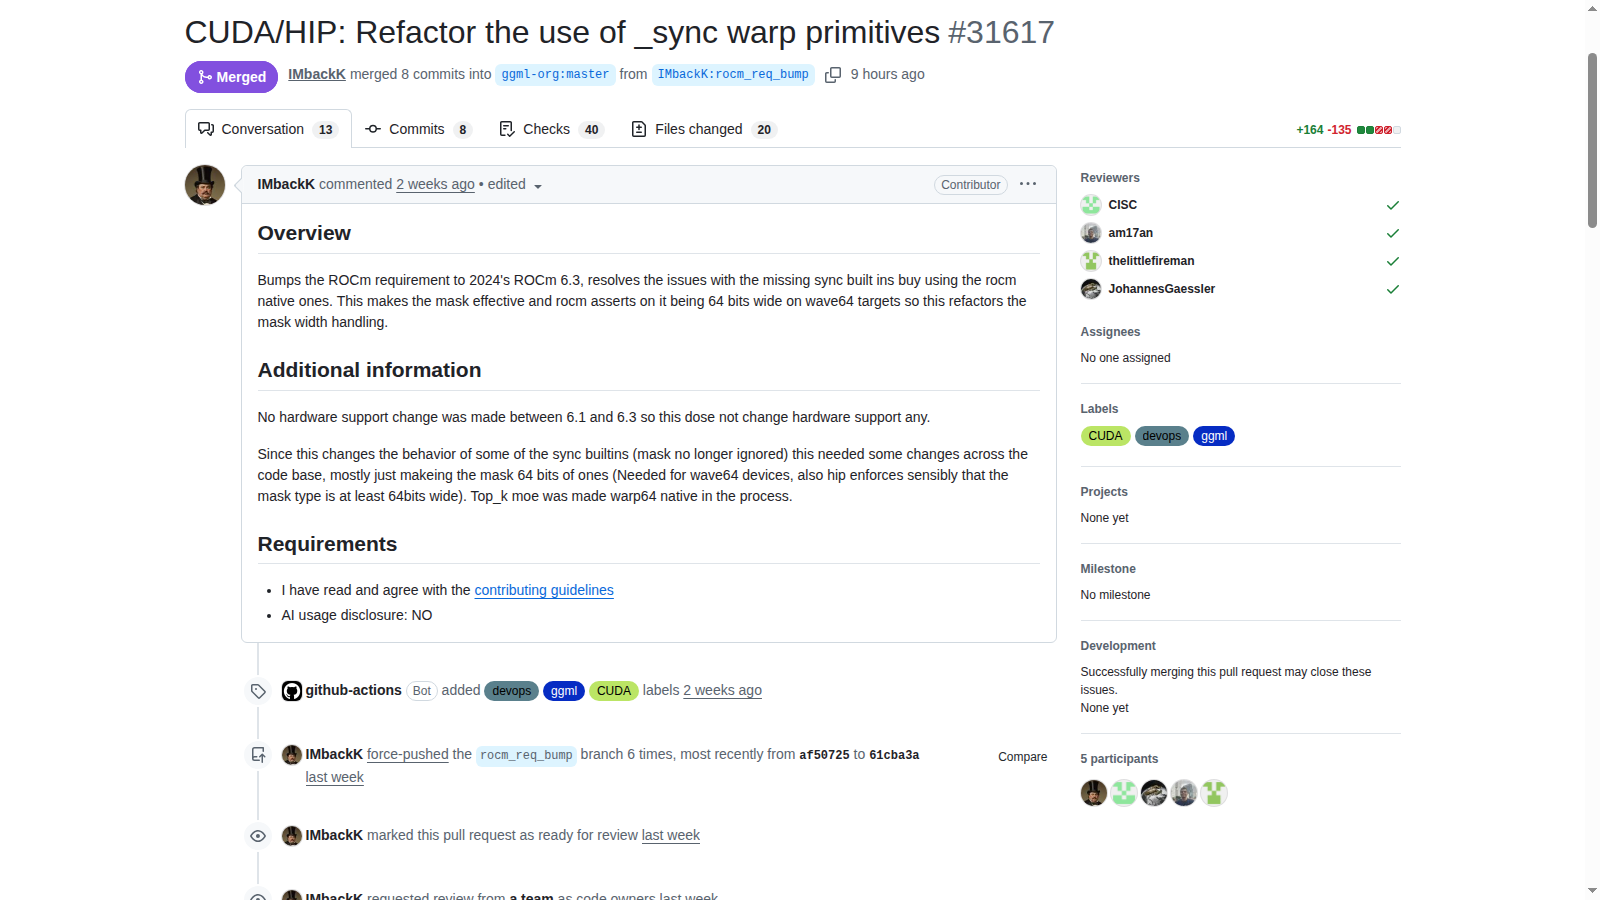
La prerelease b12414 alza a ROCm/HIP 6.3 il requisito del backend HIP e aggiorna le primitive di sincronizzazione CUDA/HIP. Il controllo è nel CMake di quel backend: non significa che qualsiasi configurazione AMD, compresa Vulkan, debba passare a ROCm.
Limiti da conoscere
Limite: È una prerelease e il minimo 6.3 verificato riguarda il backend HIP. Non sono stati eseguiti test hardware, compilazioni, benchmark o una verifica indipendente del supporto GPU dichiarato dall’autore.
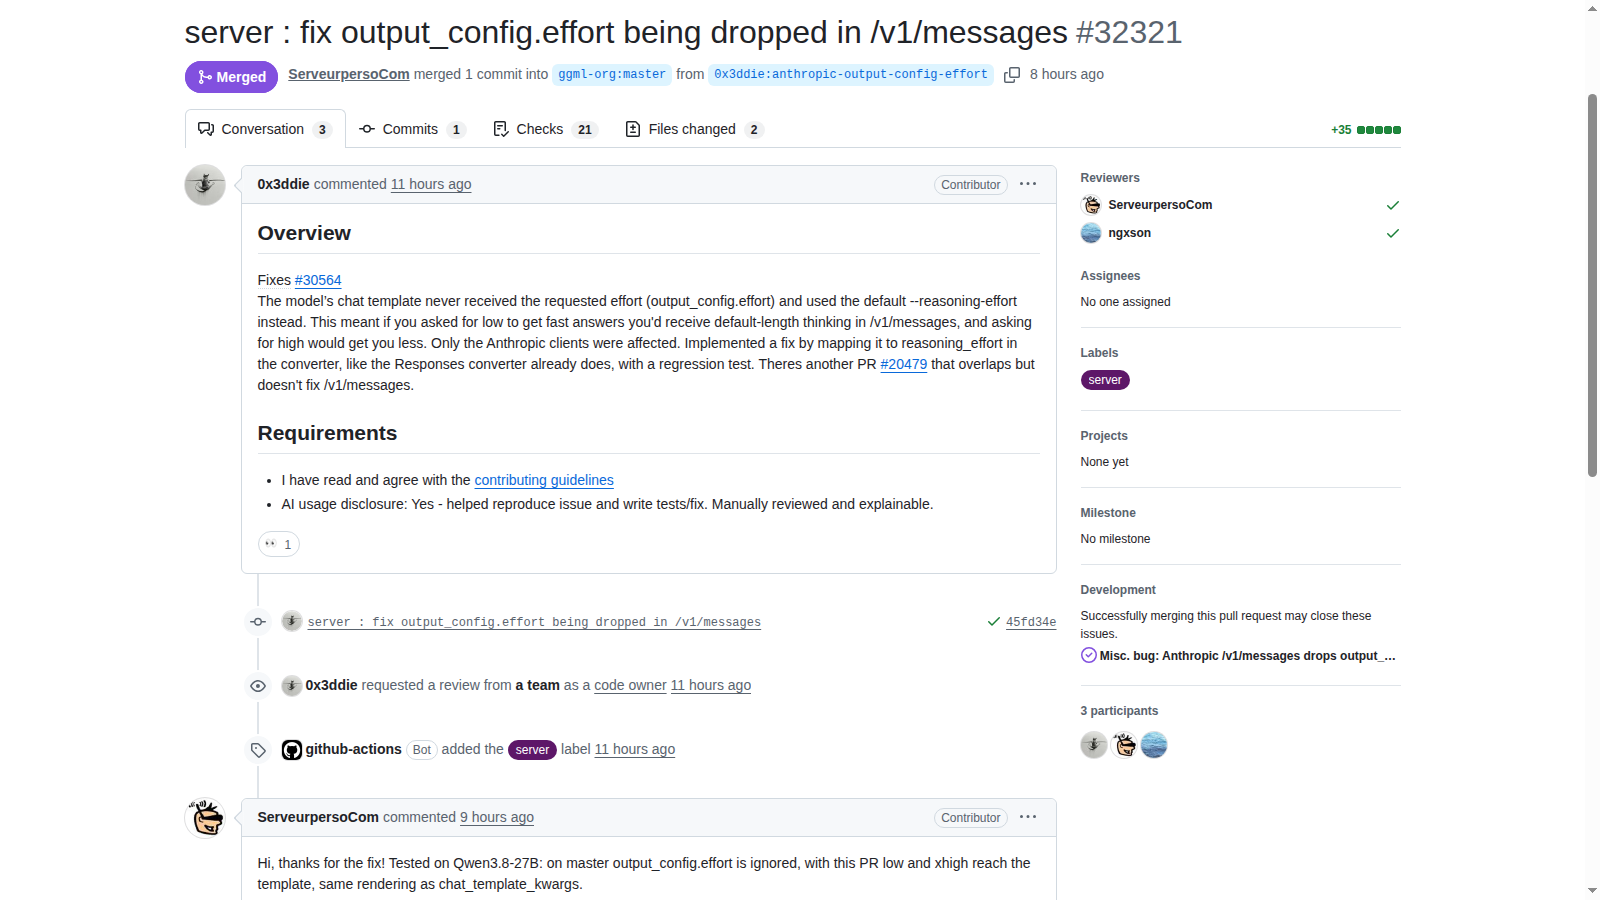
La prerelease b12415 corregge il convertitore compatibile Anthropic di llama.cpp: output_config.effort viene inoltrato a reasoning_effort anziché andare perso prima del template chat. Il diff include un test di regressione parametrizzato su low e high.
Limiti da conoscere
Limite: È una prerelease. Il diff controllato riguarda il convertitore e un caso di test con un template specifico; non sono stati eseguiti inferenza, test upstream o misure di qualità e latenza.
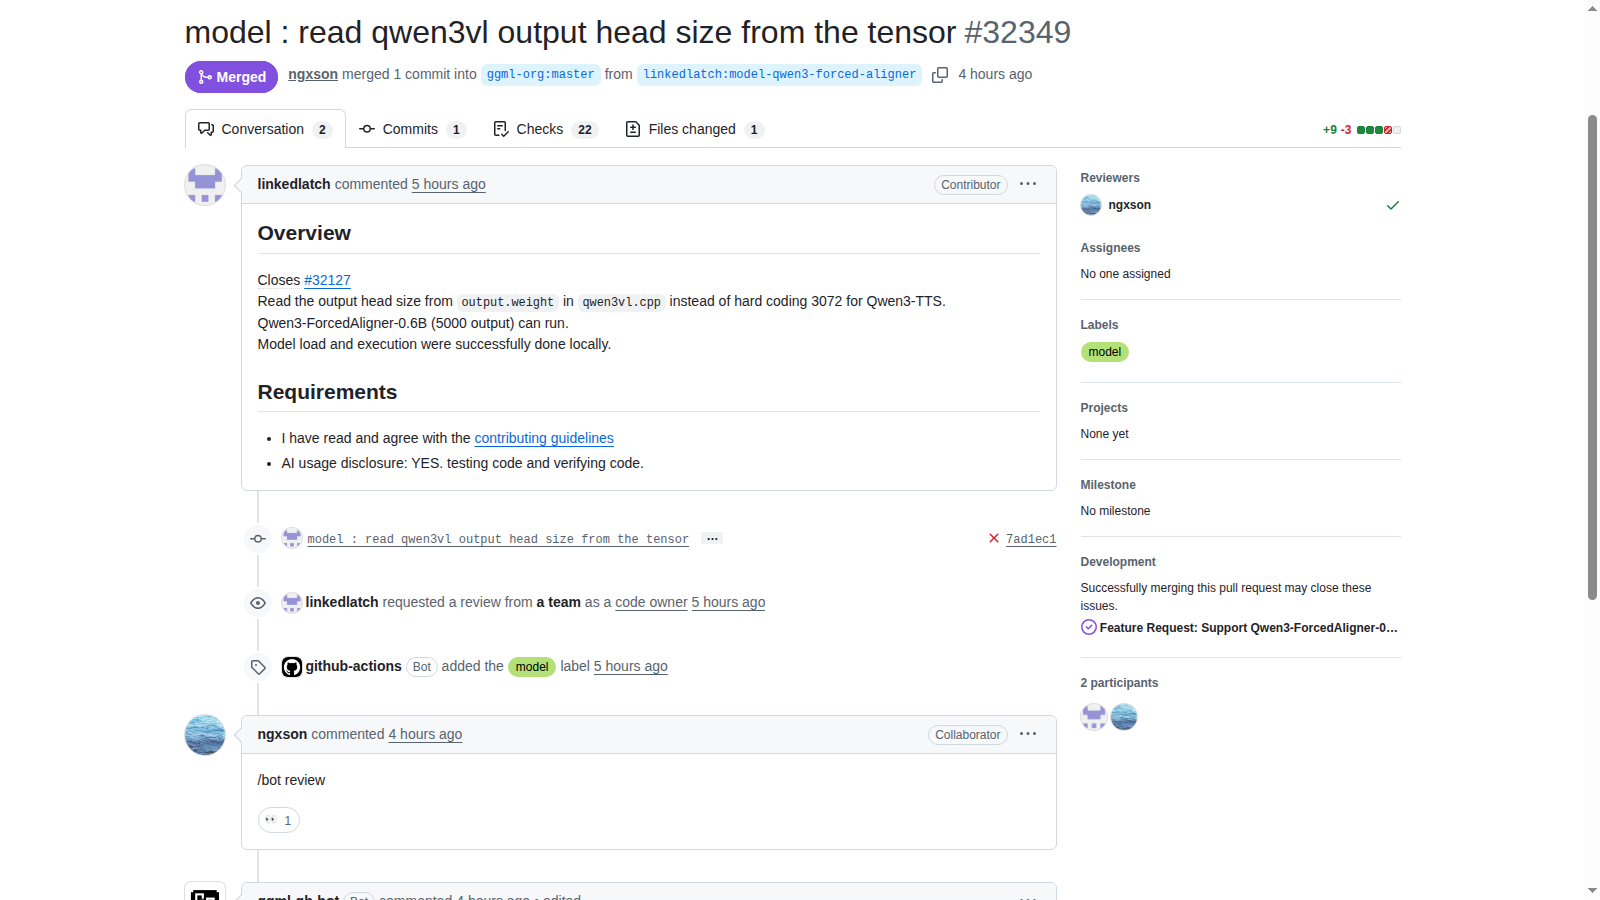
La prerelease b12425 legge la dimensione della testa di output dal tensore output.weight. La correzione consente di rappresentare anche le 5.000 classi temporali di Qwen3-ForcedAligner-0.6B, invece di confondere la testa di output con il vocabolario o con il caso TTS da 3.072 uscite.
Limiti da conoscere
Limite: Prerelease e verifica del codice, non test end-to-end. Il contributore dichiara un’esecuzione locale; non sono stati riprodotti conversione, inferenza o misure di accuratezza.
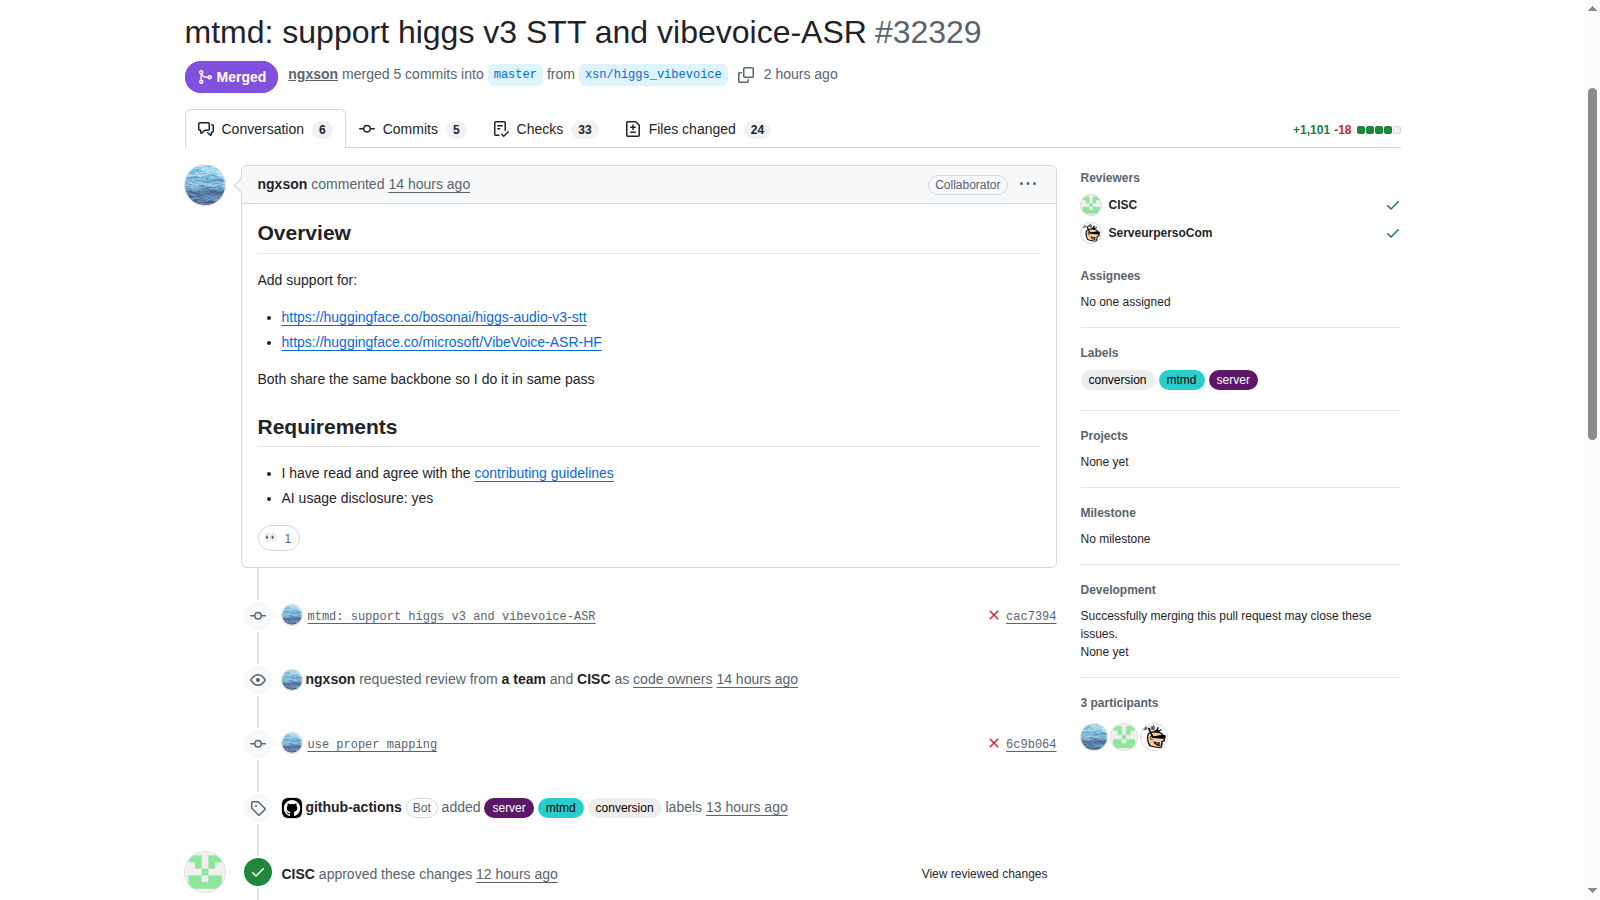
La prerelease b12426 integra in mtmd i percorsi per Higgs Audio v3 STT e VibeVoice-ASR. Il diff comprende convertitori, componenti audio e integrazione nel server. Il nuovo delta è nel runtime: i due checkpoint esistevano già e le capacità dichiarate nelle model card non sono automaticamente validate in llama.cpp.
Limiti da conoscere
Limite: Prerelease e analisi documentale. Conversione, inferenza, accuratezza, diarizzazione, durata massima, latenza e consumi nel percorso llama.cpp non sono stati verificati qui.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.