
L’ANALISI
Hy4 Flash: prezzi API e promozione Vercel
Hy4 Flash su Vercel costa 0,035 e 0,1405 dollari per milione di token input e output nel catalogo API: è una promozione, non un costo per compito.
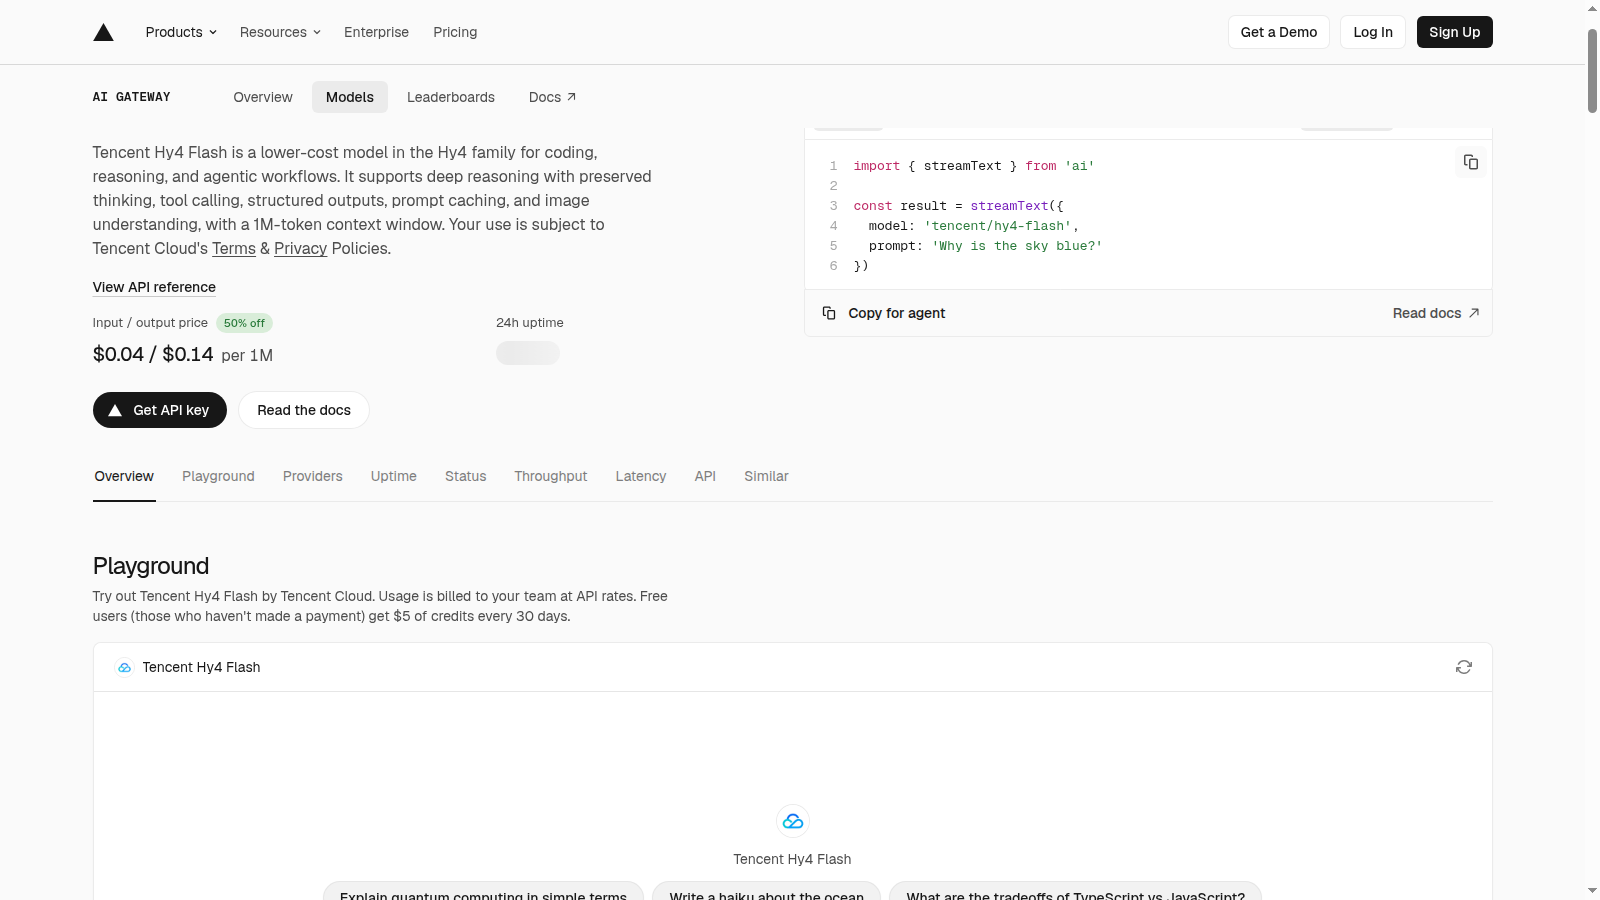
In breve: Il modello tencent/hy4-flash è presente nel catalogo API Vercel. Le tariffe correnti corrispondono a 0,035 dollari per milione di token input e 0,1405 in output, con promozione del 50% indicata nella pagina. Sono prezzi del percorso Vercel osservato, non un listino universale né un benchmark di costo per attività. Vercel AI Gateway: Tencent Hy4 Flash e promozione.
Metodo: Letti pagina ufficiale Vercel, catalogo JSON e specifica REST corrente. L'annuncio Tencent è riusato dalla lettura documentata dello stesso 16 novembre, con hash verificato. Nessuna inferenza, spesa, prova comparativa o disponibilità dei pesi verificata.
Quale modello ed endpoint sono stati verificati?
La scheda del gateway e il catalogo JSON concordano sull'identificatore tencent/hy4-flash. Il JSON riporta una finestra di contesto di 1.024.000 token, un massimo di 64.000 token di output e input testuali e immagini con output testuale. Sono proprietà dichiarate da questo servizio, non risultati di un account provato. La presenza di una voce nel catalogo non dimostra da sola che credenziali, quota e area geografica di un lettore permettano una richiesta. Vercel: catalogo JSON corrente dei modelli.
Perché il prezzo esatto differisce dalla cifra arrotondata?
La specifica REST del catalogo esprime i prezzi in dollari per token: moltiplicare i valori input e output per un milione produce 0,035 e 0,1405 dollari. La lettura cache corrisponde a 0,0015 dollari per milione. L'interfaccia può arrotondare l'input a 0,04. Per un preventivo riproducibile conviene conservare la risposta JSON datata e le unità, senza sostituire al valore originario la sola cifra visualizzata nella tabella. Vercel: specifica REST e unità dei prezzi.
Qual è il confronto corretto con l'annuncio Tencent?
L'annuncio Tencent dello stesso giorno indica 0,070 dollari per milione di token input, 0,281 in output e 0,003 per input in cache. La pagina Vercel segnala una promozione del 50%, coerente con i valori dimezzati del catalogo letto. La durata della promozione non è stata stabilita in questa verifica. Le affermazioni del produttore su equivalenza qualitativa e riduzione del costo per compito non vengono adottate come risultati indipendenti. Tencent Hy: annuncio ufficiale e tariffe del 16 novembre.
Come impostare un confronto senza promettere risparmi?
Il protocollo proposto mantiene fisso un compito italiano, conserva prompt e risposta attesa e distingue token input, output e cache. Si registrano tentativi falliti, correttezza e addebito effettivo, perché un prezzo unitario più basso può essere compensato da più token o più tentativi. La prova richiede un account abilitato e budget autorizzato: non è stata eseguita qui. Prima di inviare documenti reali vanno inoltre controllate le condizioni del provider e del gateway, senza dedurre garanzie privacy dai nomi del modello. Vercel AI Gateway: Tencent Hy4 Flash e promozione.
Condizioni e limitazioni
Confronto documentale delle tariffe, senza inferenza o addebito misurato. Durata della promozione, disponibilità dell'account, parità qualitativa e download dei pesi non verificati.
Checklist pratica proposta
- Usare l'identificatore esatto tencent/hy4-flash e verificare il percorso di addebito.
- Salvare catalogo e data, distinguendo dollari per token e per milione.
- Separare prezzo promozionale Vercel e tariffe annunciate da Tencent.
- Controllare quota, disponibilità dell'account e condizioni del provider.
- Richiedere un budget prima di qualsiasi prova di inferenza.
- Misurare correttezza, tentativi, token e spesa del compito prima di parlare di risparmio.