
LA SETTIMANA IN AI
2–8 novembre 2026
CWE-bench v2 affianca 100 task difensivi ai fix di llama.cpp, Ollama e LLM: pesi, compatibilità e risultati richiedono verifiche distinte.
In questa settimana 11 notizie
Il primo aggiornamento della settimana riguarda la riproducibilità dei modelli locali: GLB-3D-Coder sostituisce due GGUF senza rinominarli e aggiunge un proiettore opzionale. Per confrontare gli output serve identificare il checkpoint, non soltanto il nome del file.
Limiti da conoscere
Limite: Training ancora in corso. Safetensors completi e dataset sono annunciati per dopo, non una release finale già disponibile. Miglioramenti di qualità e riuscita al primo tentativo restano dichiarazioni dell’autore; non abbiamo misurato qualità, velocità o requisiti di memoria.
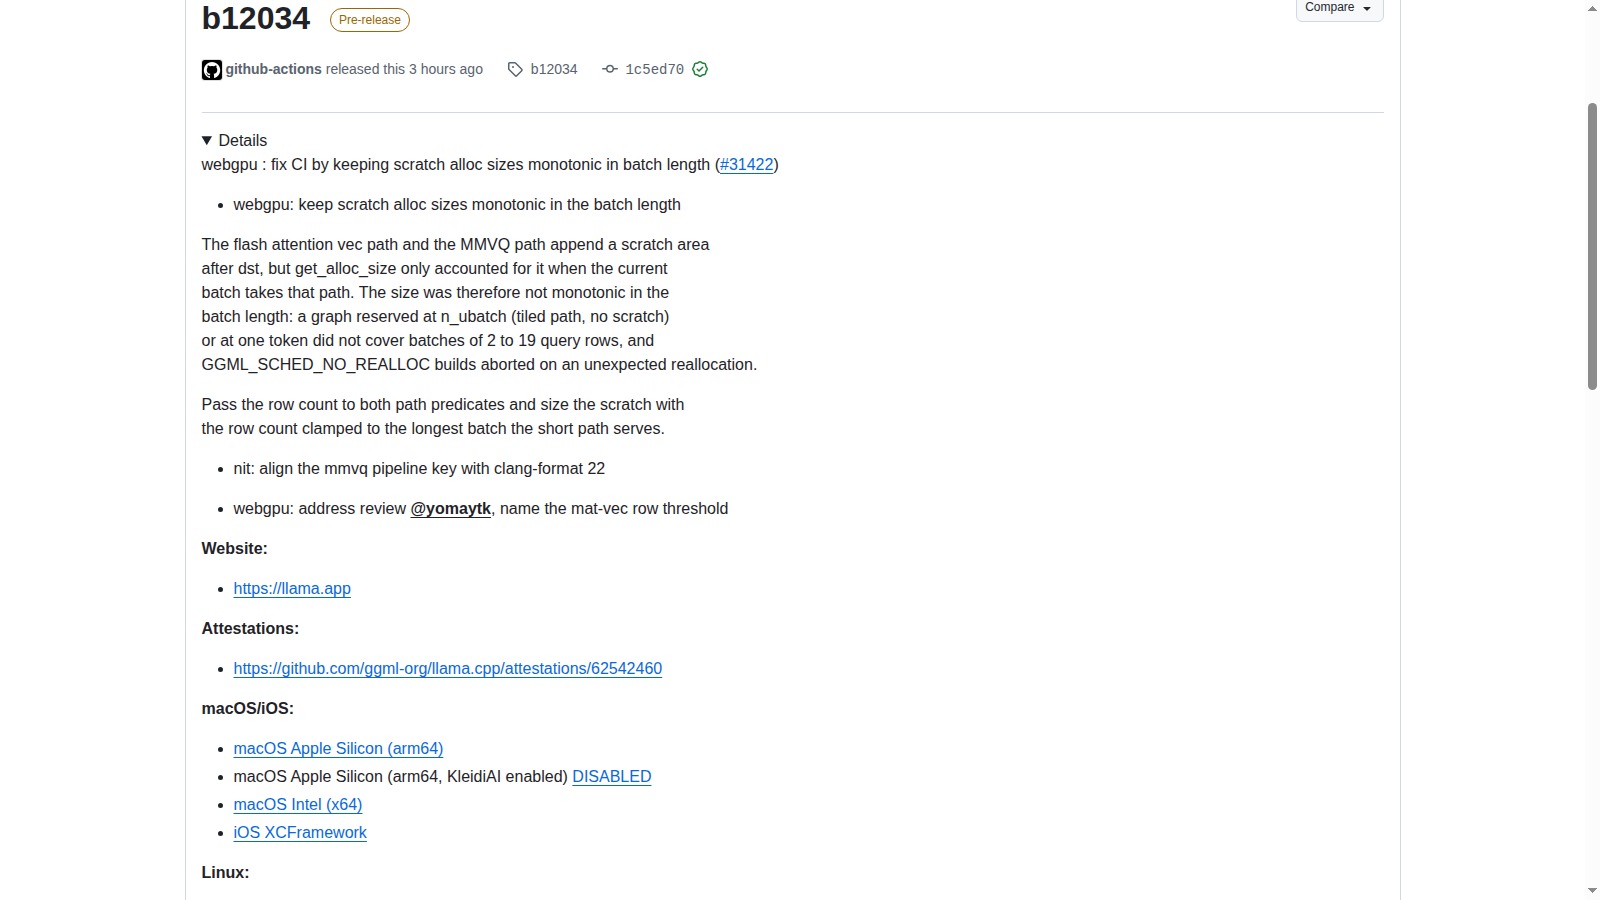
Dopo i checkpoint GLB-3D-Coder, il secondo tema della settimana è la riproducibilità del runtime: b12034 corregge una riserva di memoria WebGPU insufficiente per alcuni batch piccoli. Pesi identificati con precisione e backend verificato sono due controlli distinti prima di attribuire un errore al modello.
Limiti da conoscere
Limite: È una prerelease con una correzione circoscritta a WebGPU. I test riportati nella PR sono dell’autore del contributo, non nostri: non abbiamo compilato questa revisione né misurato prestazioni. Non dimostra un aumento generale dei token al secondo o minori requisiti di memoria complessivi.
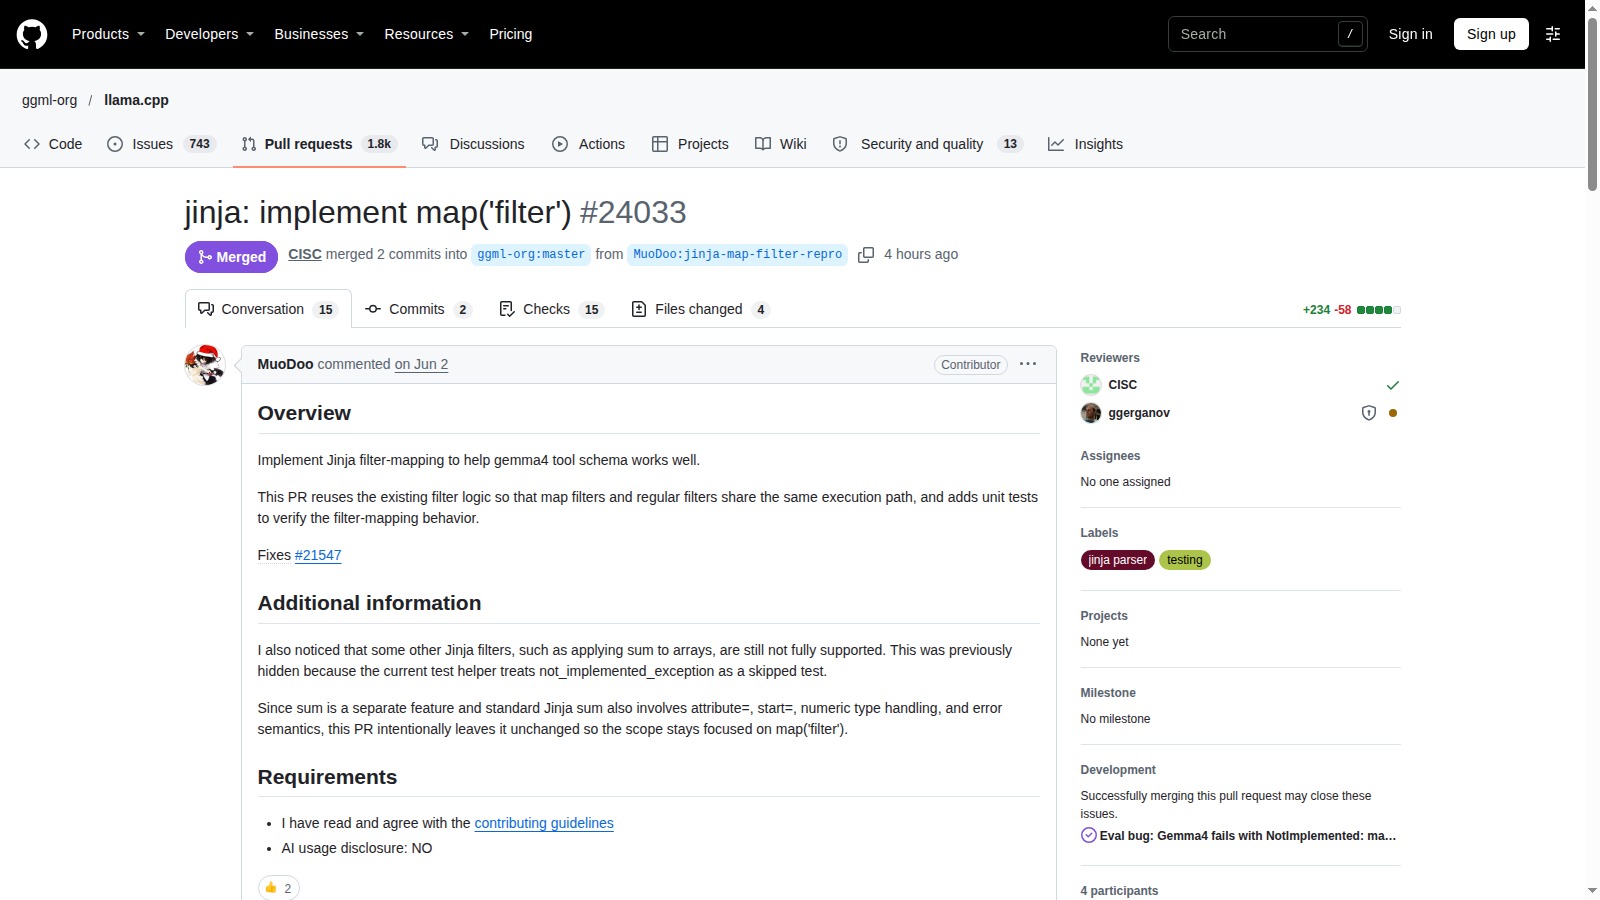
Dopo i checkpoint GGUF e la riserva di memoria WebGPU, Jinja aggiunge un terzo livello di riproducibilità: il template. Il merge di map('filter') modifica ciò che il runtime può interpretare, senza dimostrare da solo che un agente chiami correttamente i tool. Pesi, backend e serializzazione del prompt vanno verificati separatamente.
Limiti da conoscere
Limite: Sono verificati tag, merge e diff; non una release binaria. L'API release del tag risponde 404 alla verifica. I test aggiunti e i check CI upstream non sostituiscono un test locale del modello o del tool calling. Il filtro sum sugli array resta fuori dallo scopo della modifica.
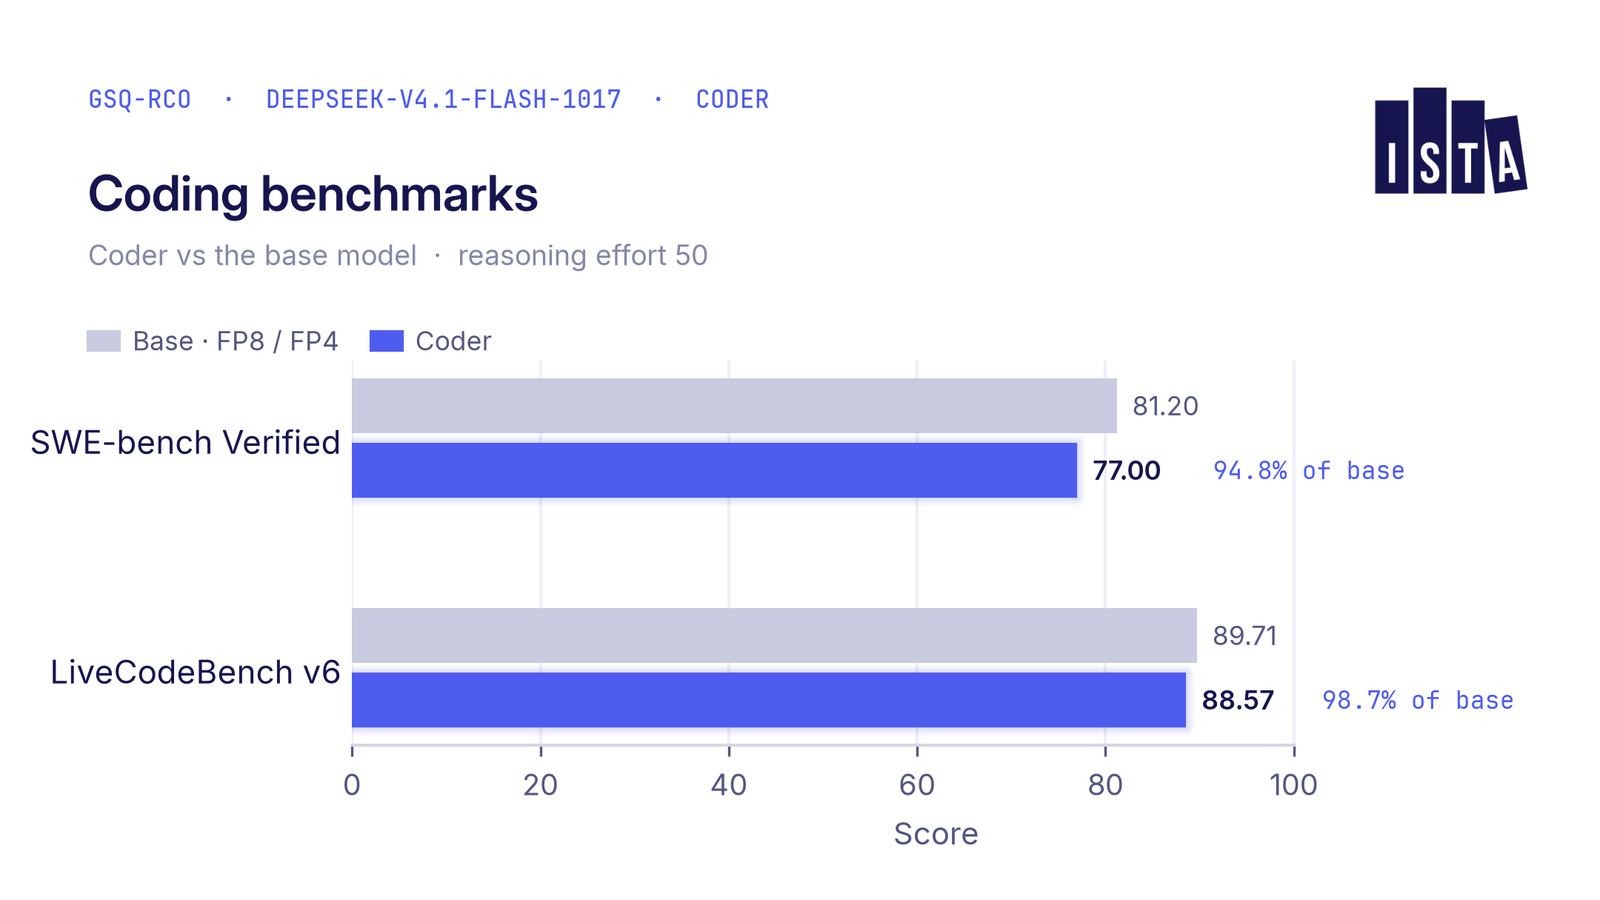
Il nuovo Coder sposta il confronto dalla sola quantizzazione alla selezione degli esperti: meno pesi possono significare anche capacità eliminate. Rispetto ai cambiamenti di checkpoint, backend e template già raccolti, qui la prima decisione pratica è distinguere il transformer da 72,12 GB dal pacchetto con Engram da 182,72 GB, prima di valutare l'hardware.
Limiti da conoscere
Limite: È un rilascio sperimentale e indipendente da DeepSeek. Le dimensioni dei file non sono una misura di RAM o VRAM necessaria; qualità, velocità e funzionamento locale non sono stati testati qui. I risultati del grafico sono dichiarazioni degli autori, non benchmark riprodotti.
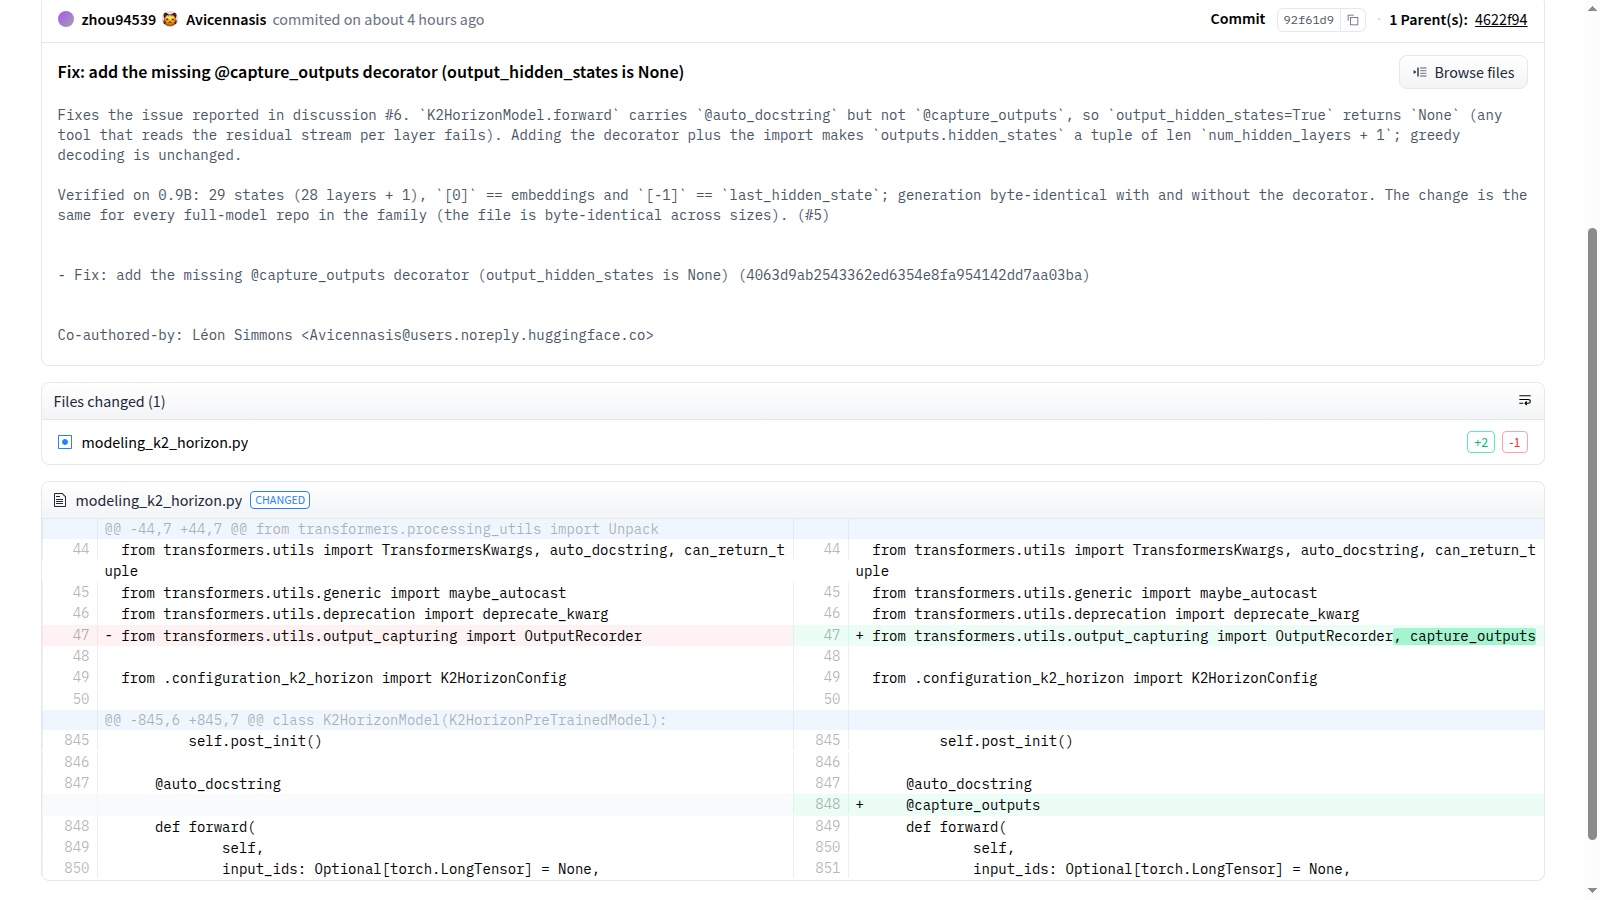
Dopo i nuovi GGUF di GLB-3D-Coder e il pruning di GSQ-RCO Coder, K2-Horizon mostra un caso diverso: restano identici i 36 shard, cambia il codice che rende osservabili gli stati interni. Anche rispetto ai fix WebGPU e Jinja di llama.cpp, la scelta pratica è fissare sia revisione del modello sia runtime, non contare ogni revisione come nuovi pesi.
Limiti da conoscere
Limite: Verifica documentale e confronto del codice, non esecuzione del modello. Il test citato nel messaggio del commit riguarda la variante 0.9B; non dimostra un test indipendente del 7B. Nessuna nuova misura di qualità, velocità o memoria.
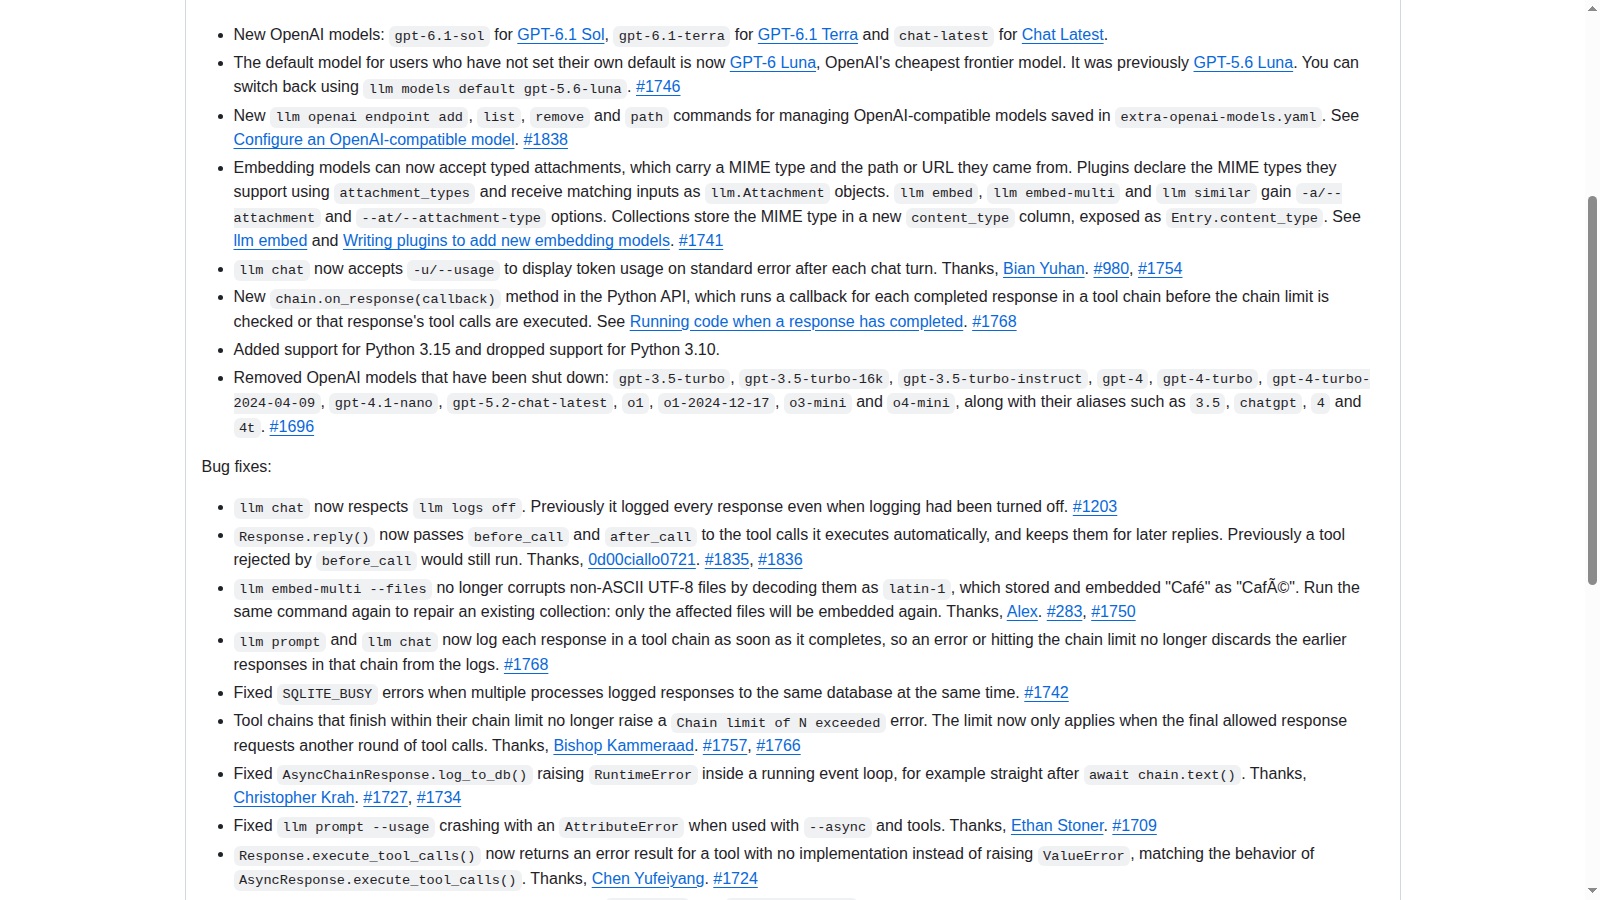
Ai fix di checkpoint, memoria WebGPU e template Jinja si aggiunge un confine diverso: il codice che autorizza l’azione. LLM 0.37 conserva i callback anche dopo Response.reply(). Una risposta apparentemente corretta e un tool realmente bloccato sono verifiche distinte; il confronto offline tra 0.36 e 0.37 misura solo questo percorso.
Limiti da conoscere
Limite: Prova offline con modello simulato, codice reale della libreria e marcatori innocui in memoria. I dodici casi sono ripetizioni della stessa fixture, non un benchmark di modelli, una stima statistica di affidabilità o una certificazione di sicurezza. Nessun invio, cancellazione, dato personale o aggiornamento produttivo è stato usato nel test.
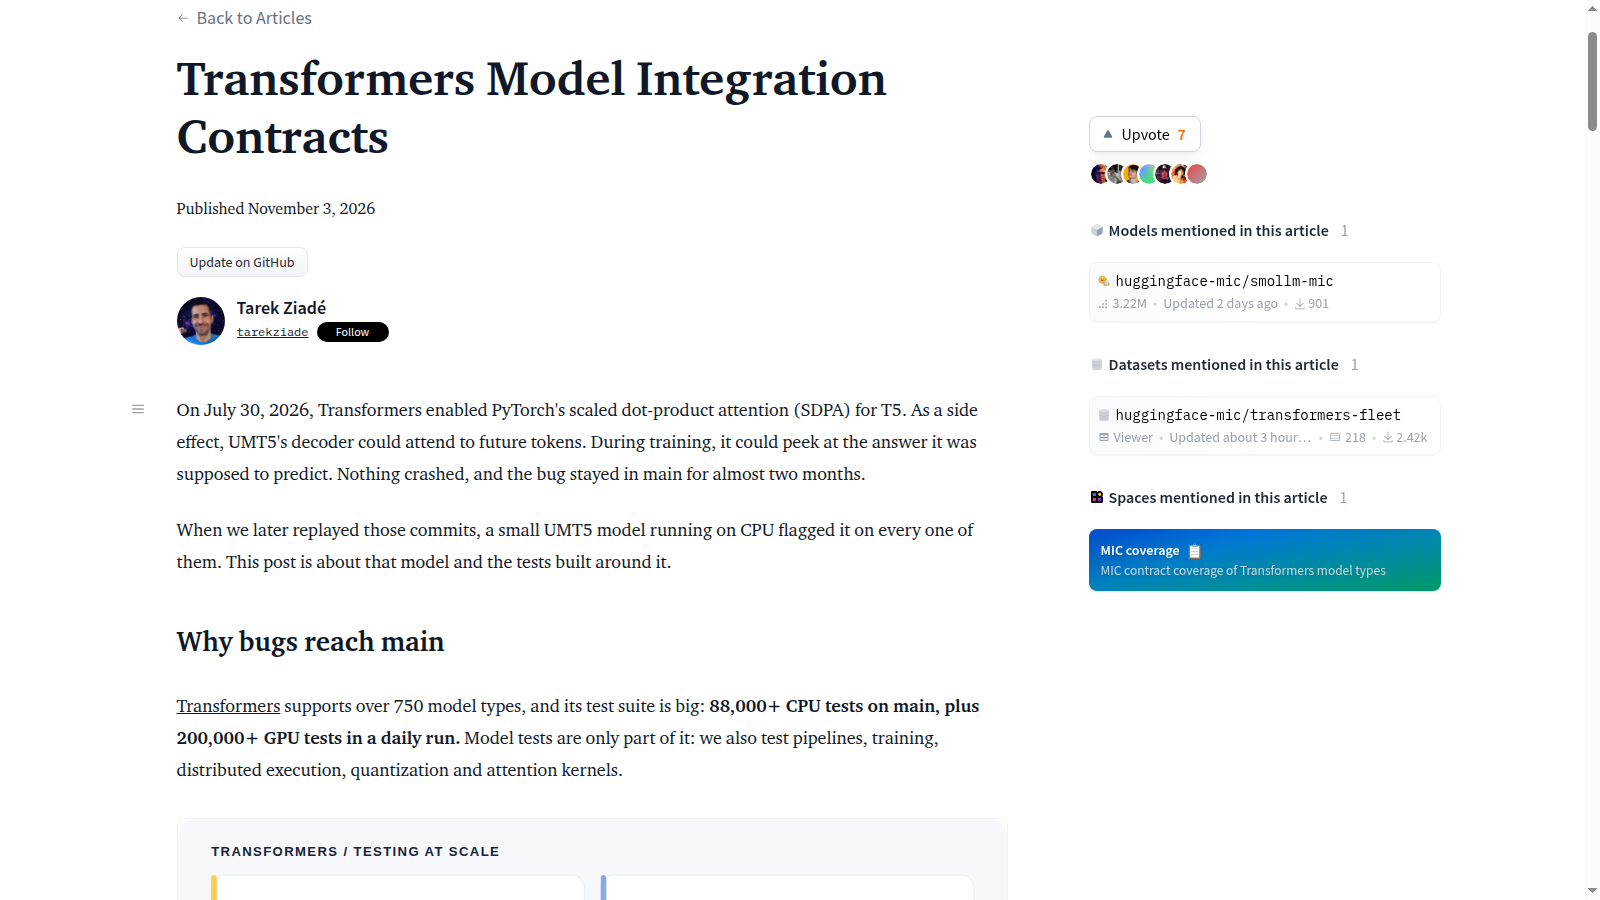
MIC aggiunge un controllo delle integrazioni prima del checkpoint completo. Rispetto alle correzioni di runtime di questa settimana, offre un modo per rilevare regressioni, non una garanzia sulla qualità del modello reale.
Limiti da conoscere
Limite: Lo standard è proposto e la copertura è parziale. Un PASS sulla fixture non certifica il checkpoint reale; il job sulle PR descritto dal progetto segnala errori senza bloccare il merge. Non è stato eseguito un test MIC in questa edizione.
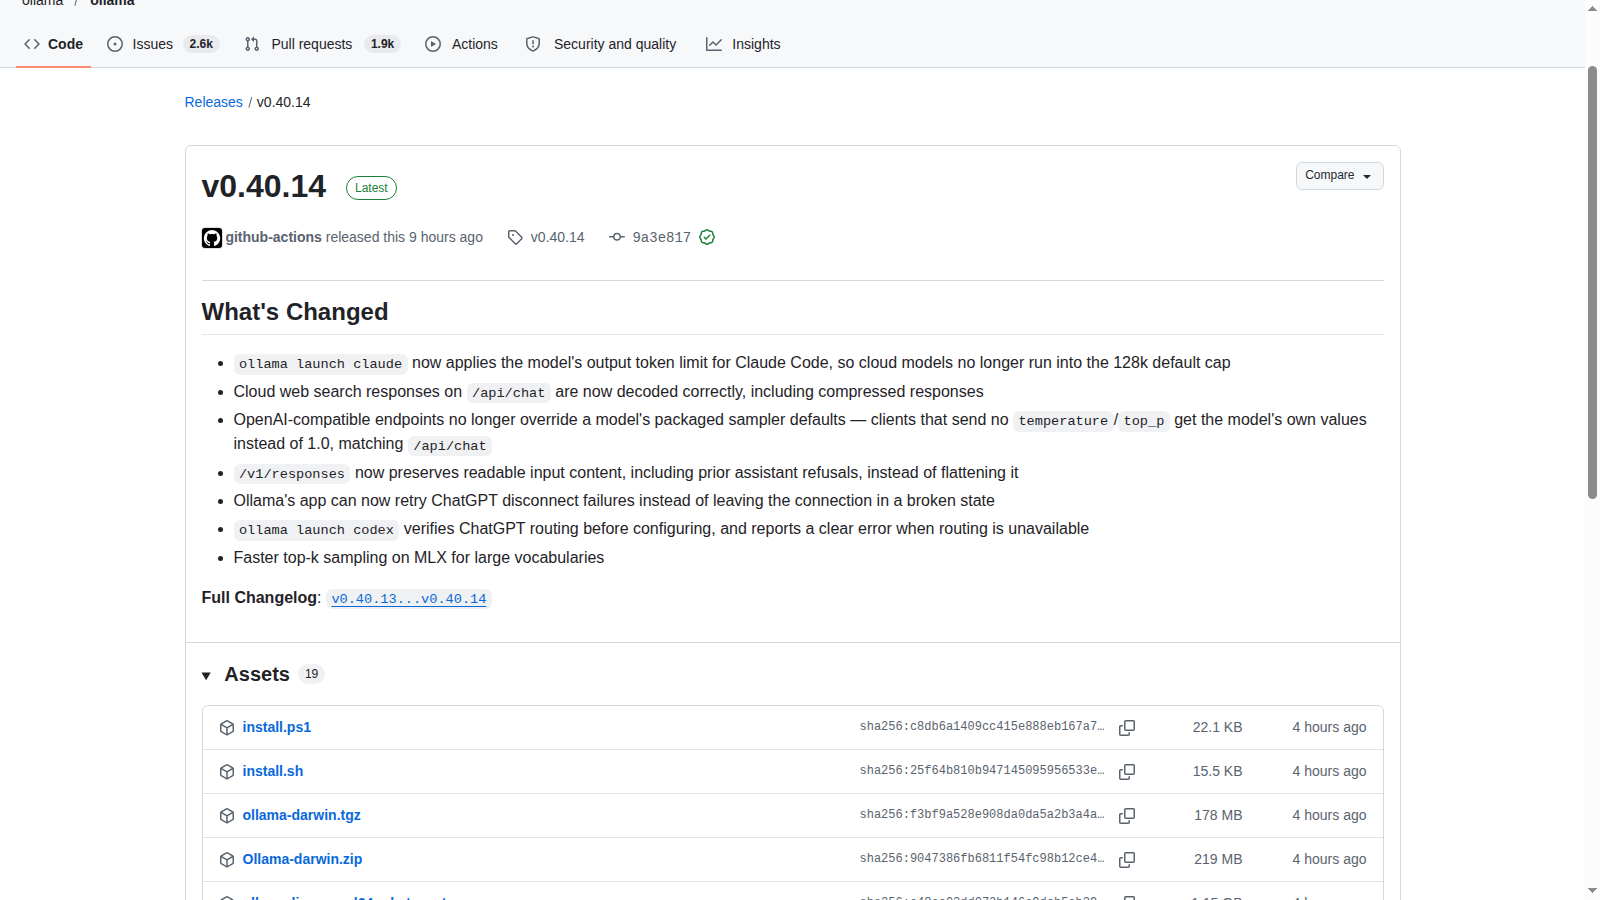
La 0.40.14 interviene sulla compatibilità tra client e modello: valori sampler, contenuti di input e limiti di output. Il confronto settimanale va quindi oltre i nuovi pesi: anche il trasporto può cambiare il comportamento osservato.
Limiti da conoscere
Limite: Le correzioni sono dichiarate nelle note ufficiali, non riprodotte qui. La release risulta non prerelease al controllo; l’istante esatto della promozione da release candidate non è disponibile. Nessuna promessa di qualità o velocità generale.
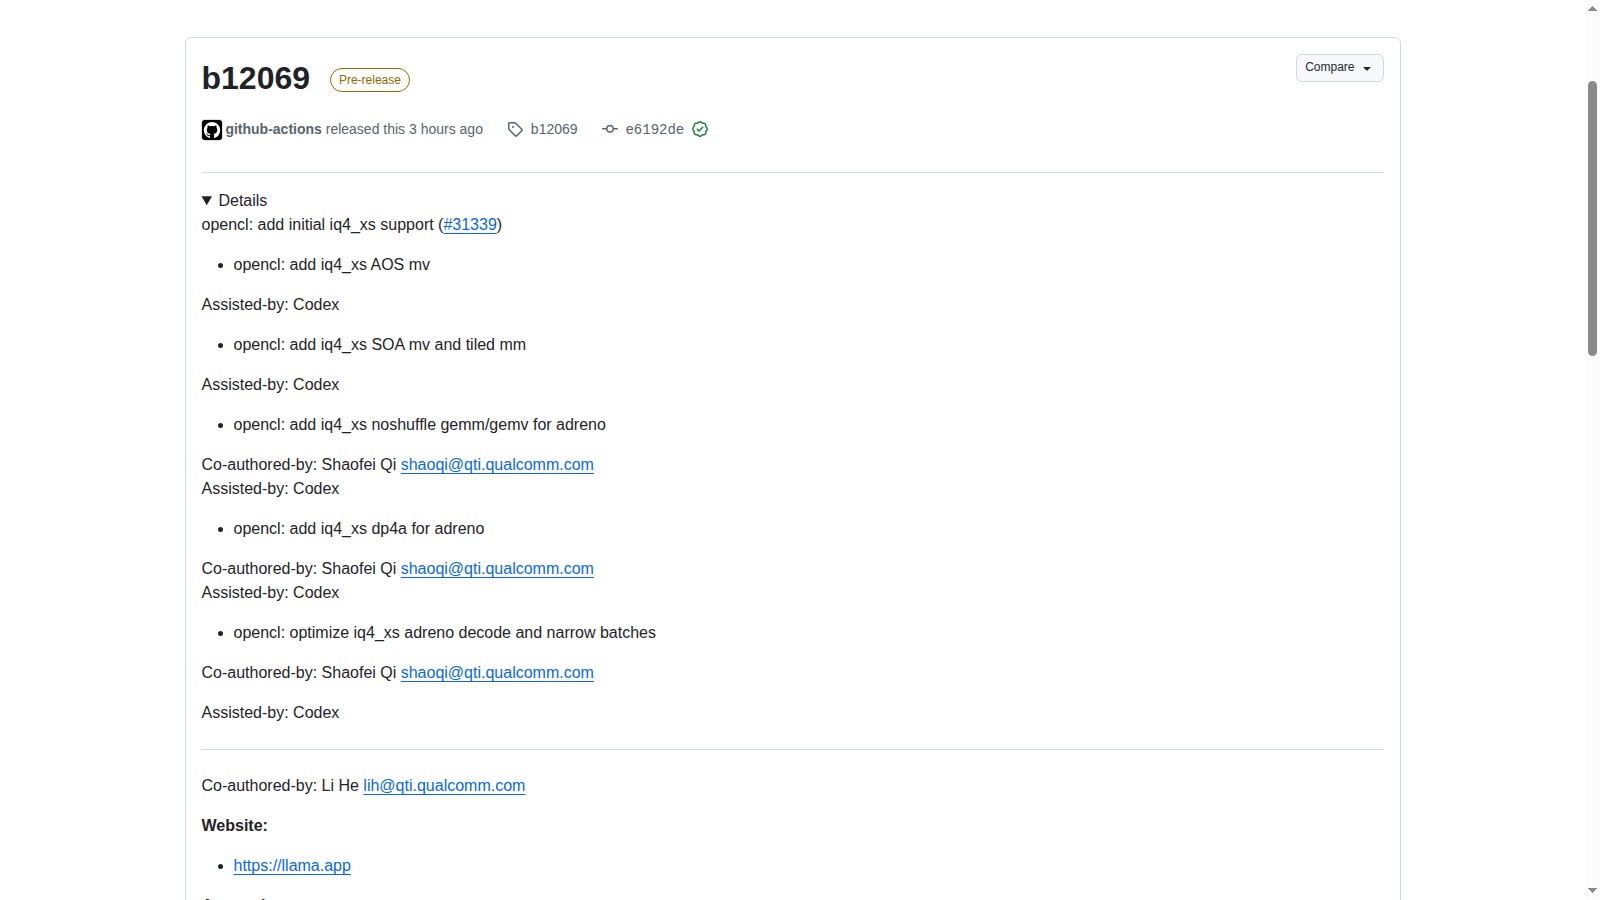
Dopo le correzioni WebGPU e dei template Jinja, llama.cpp amplia un altro confine: IQ4_XS nel backend OpenCL. Rispetto ai cambiamenti dei checkpoint, qui il delta riguarda il runtime e i kernel Adreno. Occorre verificare insieme formato, build e driver; non è una misura di qualità del modello o di velocità generale.
Limiti da conoscere
Limite: Supporto iniziale dichiarato dal progetto, non una prova su ogni GPU. Nessun test di inferenza, benchmark o aggiornamento produttivo è stato eseguito qui; la pagina OpenCL della stessa revisione non elenca ancora IQ4_XS nella tabella dei formati.
Ai fix di runtime e API si affianca una domanda diversa: come verificare una correzione di sicurezza? CWE-bench v2 rende disponibile un set di 100 task con verificatori eseguibili, ma richiede l’accettazione delle condizioni. Va separato il controllo funzionale del codice dai punteggi di un modello e dal costo di eseguirlo.
Limiti da conoscere
Limite: Annuncio e scheda pubblica verificati, benchmark non eseguito qui. I file README e registry richiesti senza autenticazione hanno restituito HTTP 401. I risultati degli autori non certificano la sicurezza di un prodotto né misurano i costi del nostro ambiente.
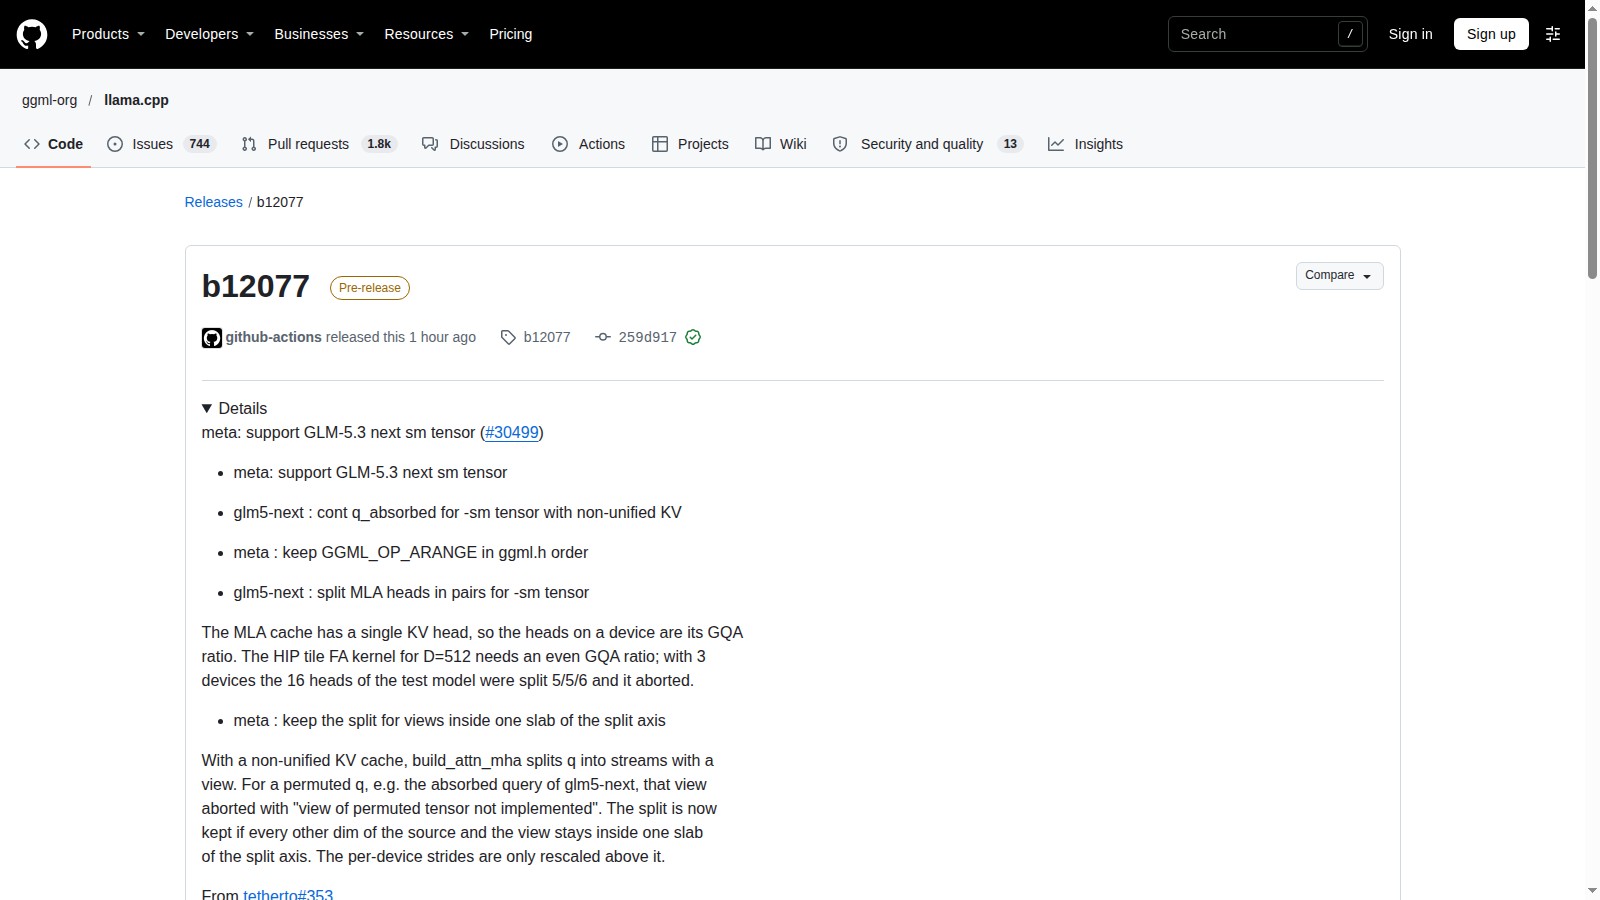
Dopo IQ4_XS su OpenCL, llama.cpp interviene sul confine tra architettura e distribuzione multi-GPU: b12077 abilita tensor split per GLM-5.3 next. Il confronto della settimana resta operativo: formato, runtime e topologia dei dispositivi vanno verificati insieme. Nessuna di queste correzioni dimostra da sola un modello più accurato.
Limiti da conoscere
Limite: Release e quattro file della PR verificati; nessuna compilazione o inferenza multi-GPU eseguita qui. Il caso a tre dispositivi descritto dagli autori riguarda un modello di test con 16 teste, non ogni configurazione reale. b12077 risulta prerelease.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.