
L’ANALISI
llama.cpp b12034: fix WebGPU per i batch piccoli
llama.cpp b12034 corregge la memoria temporanea WebGPU per batch da 2 a 19 righe. Una prerelease per evitare arresti, non un benchmark.
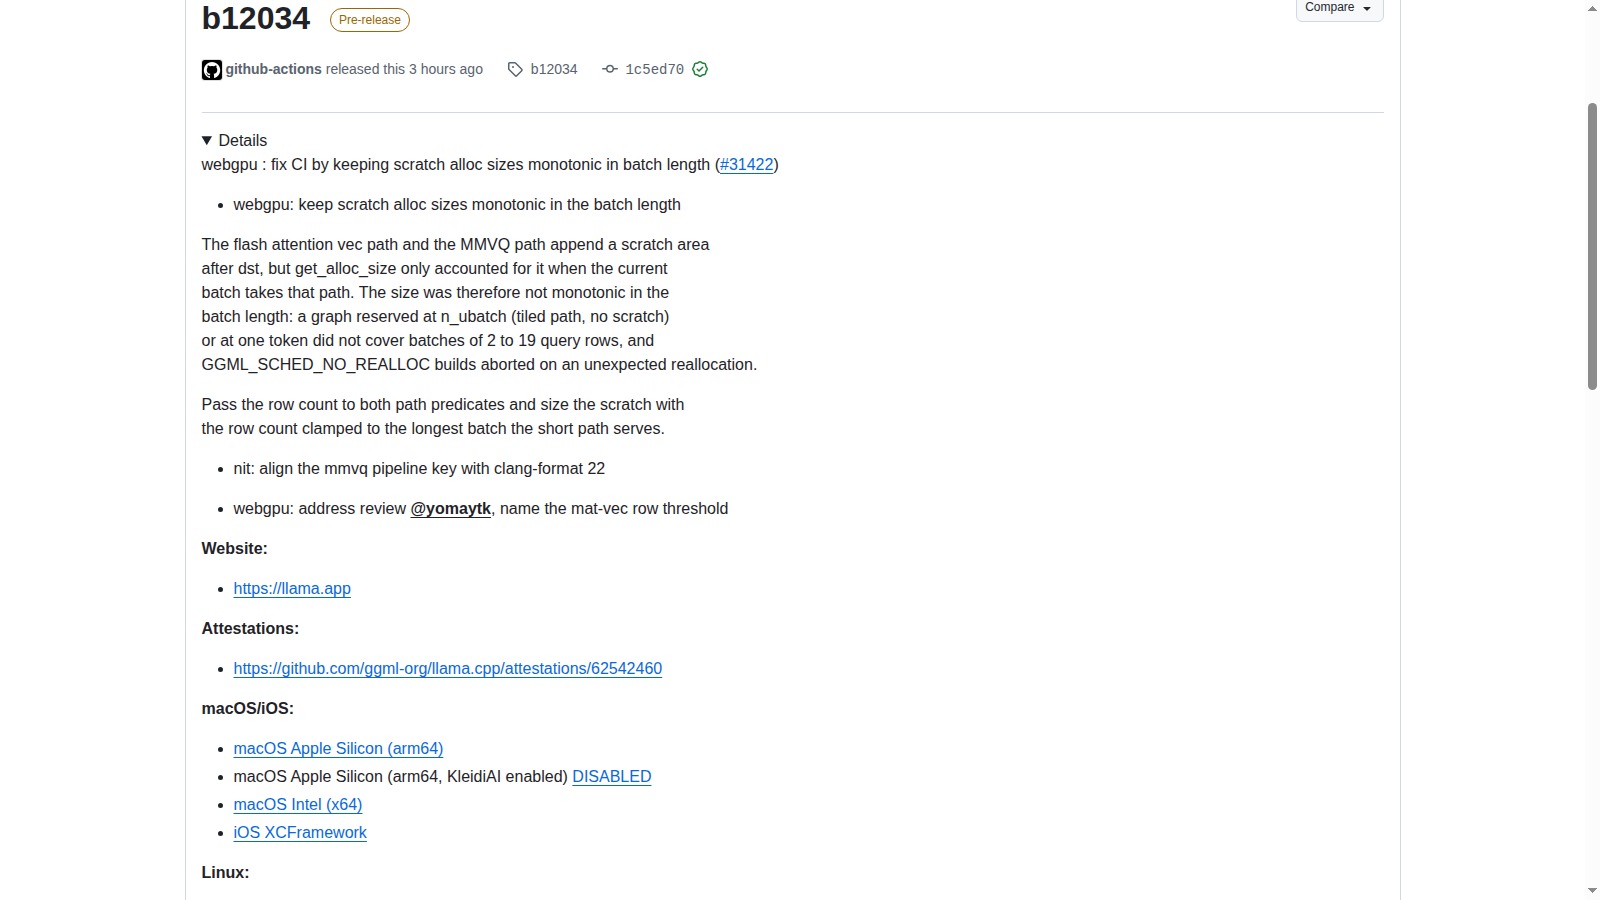
In breve: llama.cpp b12034 corregge un errore di prenotazione della memoria temporanea WebGPU che poteva far arrestare le build con GGML_SCHED_NO_REALLOC sui batch piccoli. La verifica utile è ripetere lo stesso carico prima e dopo la correzione: non è una nuova architettura né una misura di velocità.
Questa analisi confronta la release ufficiale, la descrizione della PR e il diff dei due file modificati. Nessun modello è stato eseguito per questa notizia. La procedura sotto è un protocollo proposto, non un test completato sul nostro hardware.
Che cosa cambia nella prerelease b12034?
Il progetto ha pubblicato b12034 il 2 novembre 2026 alle 09:02 ora italiana. Il rilascio punta al commit 1c5ed702c9e540ac14cc8c78100ea3984bc0e227, lo stesso indicato come merge della PR 31422. Il problema era già discusso nella PR aperta il 30 ottobre: la novità del 2 novembre è l’integrazione nel ramo principale e la disponibilità della build identificata dal tag, non la prima segnalazione. Il campo ufficiale prerelease resta vero. Qui b12034 identifica la revisione analizzata, non una garanzia che sia l’ultima build disponibile. Release ufficiale llama.cpp b12034.
Perché un batch piccolo poteva richiedere più spazio?
Secondo la spiegazione della PR, i percorsi vettoriali di flash attention e MMVQ collocano un’area temporanea dopo l’output. Il calcolo della dimensione la includeva solo quando il batch corrente selezionava quel percorso. Una riserva costruita su un batch grande o su una sola riga poteva quindi non coprire un batch intermedio. L’esempio documentato riguarda cinque token e un output FLASH_ATTN_EXT che richiedeva 95.072 byte contro 65.536 prenotati. Sono le dimensioni dell’esempio nella PR, non il fabbisogno totale di un modello. PR 31422: causa, condizioni e test dichiarati.
Come interviene la correzione nel codice?
Il diff modifica ggml-webgpu.cpp e ggml-webgpu-shader-lib.hpp. Il conteggio delle righe viene passato esplicitamente ai predicati dei percorsi; per la prenotazione, la lunghezza viene limitata alla maggiore dimensione del batch servita dal percorso corto. La soglia del percorso vettoriale flash attention è inferiore a 20 righe, quella MMVQ arriva a 4. Il risultato cercato è che la riserva effettuata per n_ubatch copra anche i batch più piccoli. È una correzione dell’allocazione: non cambia i pesi e non autorizza una conclusione generale sul throughput. Diff ufficiale dei file WebGPU modificati.
Chi dovrebbe ripetere una prova controllata?
Il pubblico più direttamente interessato è chi usa il backend WebGPU e incontra un errore di riallocazione inattesa, soprattutto nelle build che vietano riallocazioni dopo la prenotazione del grafo. La PR cita il caso comp_padding nei test di contesto con modelli DeepSeek V4 e runner Apple e NVIDIA. Il contributore riporta una prova con RTX PRO 6000 e GGML_SCHED_NO_REALLOC=ON. Sono condizioni e risultati dichiarati dall’autore: non una certificazione per ogni GPU, browser, modello o backend. Se il proprio programma usa un backend diverso, questa notizia da sola non dimostra che il problema sia lo stesso. PR 31422: causa, condizioni e test dichiarati.
Come confrontare prima e dopo senza confondere i risultati?
Conservare il binario o commit di partenza e predisporre una build separata con la correzione, senza sostituire subito l’ambiente operativo. Usare lo stesso modello, quantizzazione, prompt e impostazioni di batch; annotare backend, GPU, driver e opzioni di compilazione. Ripetere il caso che produceva l’errore e conservare i log di entrambi i tentativi. Il primo esito da controllare è la scomparsa dell’arresto nello stesso scenario. Latenza e velocità richiedono misure separate, ripetute nelle medesime condizioni. Se non si riesce a riprodurre il difetto iniziale, dichiarare il confronto non conclusivo invece di trasformare l’assenza di crash in una prova universale. PR 31422: causa, condizioni e test dichiarati.
Condizioni e limitazioni
È una prerelease con una correzione circoscritta a WebGPU. I test riportati nella PR sono dell’autore del contributo, non nostri: non abbiamo compilato questa revisione né misurato prestazioni. Non dimostra un aumento generale dei token al secondo o minori requisiti di memoria complessivi.
Checklist pratica
- Registrare commit o tag, backend WebGPU, GPU, driver e opzioni di compilazione.
- Conservare separatamente l’ambiente precedente e la build da confrontare.
- Mantenere identici modello, quantizzazione, prompt e configurazione del batch.
- Ripetere il caso reale che dava riallocazione inattesa e salvare entrambi i log.
- Distinguere errore risolto, test non conclusivo e prestazioni non misurate.
- Valutare l’adozione soltanto dopo il test sul proprio carico, con rollback disponibile.