
IL PUNTO SULL’AI
3 novembre 2026
CWE-bench v2 propone 100 task di sicurezza; llama.cpp abilita GLM-5.3 next su più GPU, mentre MIC, Ollama e LLM correggono test e API.
In questa edizione 6 notizie
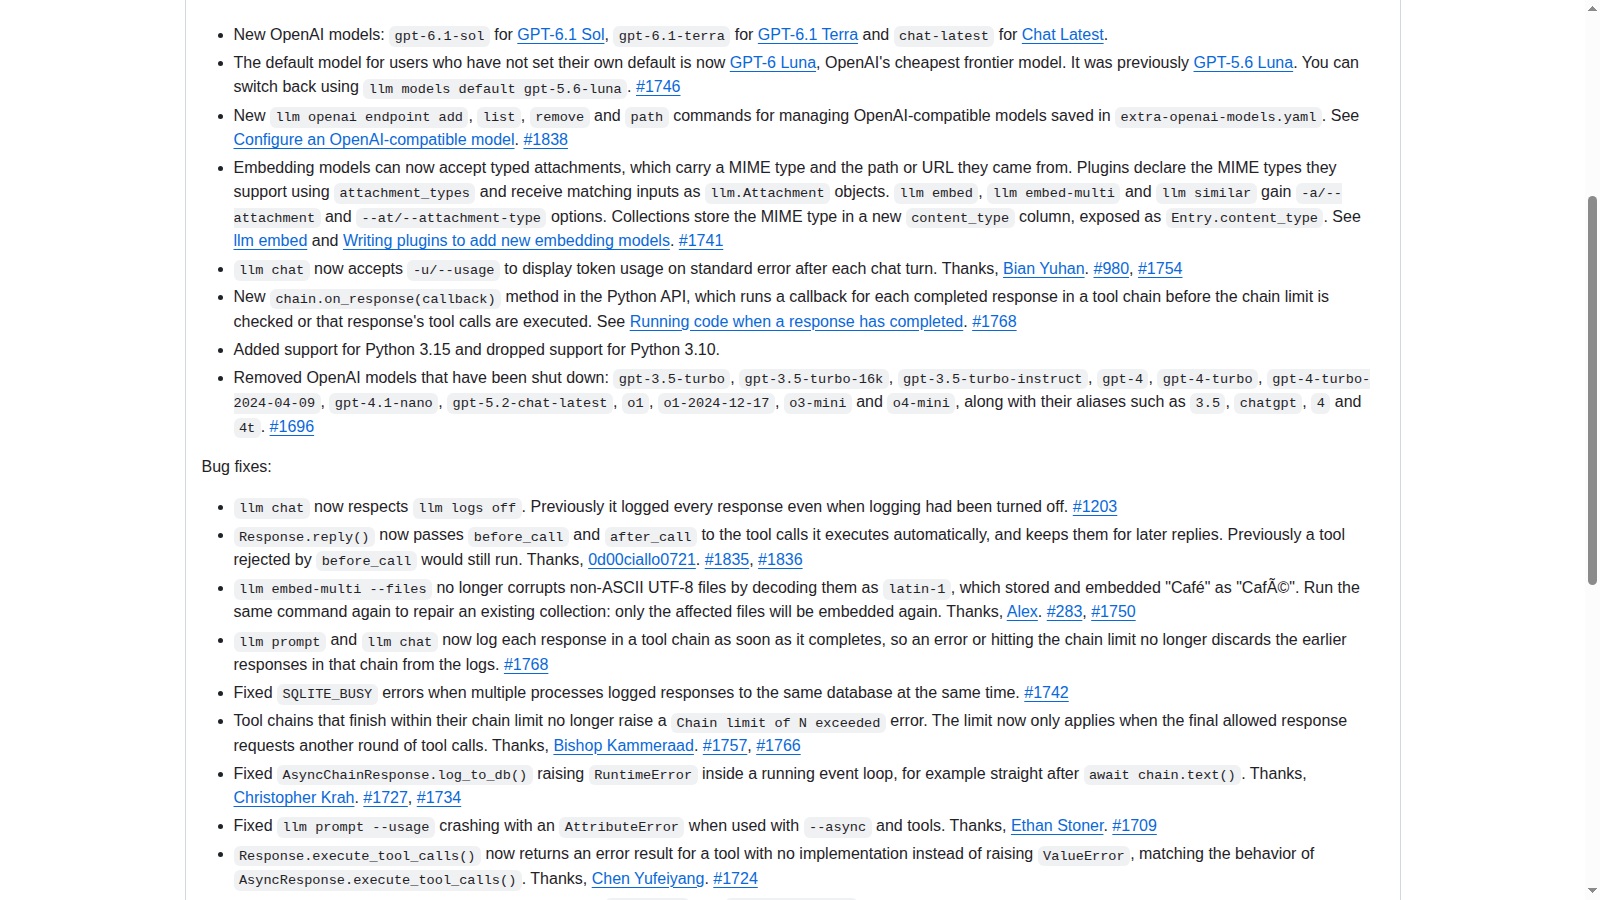
LLM 0.37 corregge il passaggio dei callback before_call e after_call quando Response.reply() esegue automaticamente i tool, nei percorsi sincrono e asincrono e nei turni successivi. Nel test deterministico dell’assistente, il tool rifiutato viene eseguito in 6 casi su 6 con la 0.36 e in nessuno dei 6 con la 0.37. La release stabile è del 3 novembre, ora italiana; l’issue è del 29 ottobre.
Limiti da conoscere
Limite: Prova offline con modello simulato, codice reale della libreria e marcatori innocui in memoria. I dodici casi sono ripetizioni della stessa fixture, non un benchmark di modelli, una stima statistica di affidabilità o una certificazione di sicurezza. Nessun invio, cancellazione, dato personale o aggiornamento produttivo è stato usato nel test.
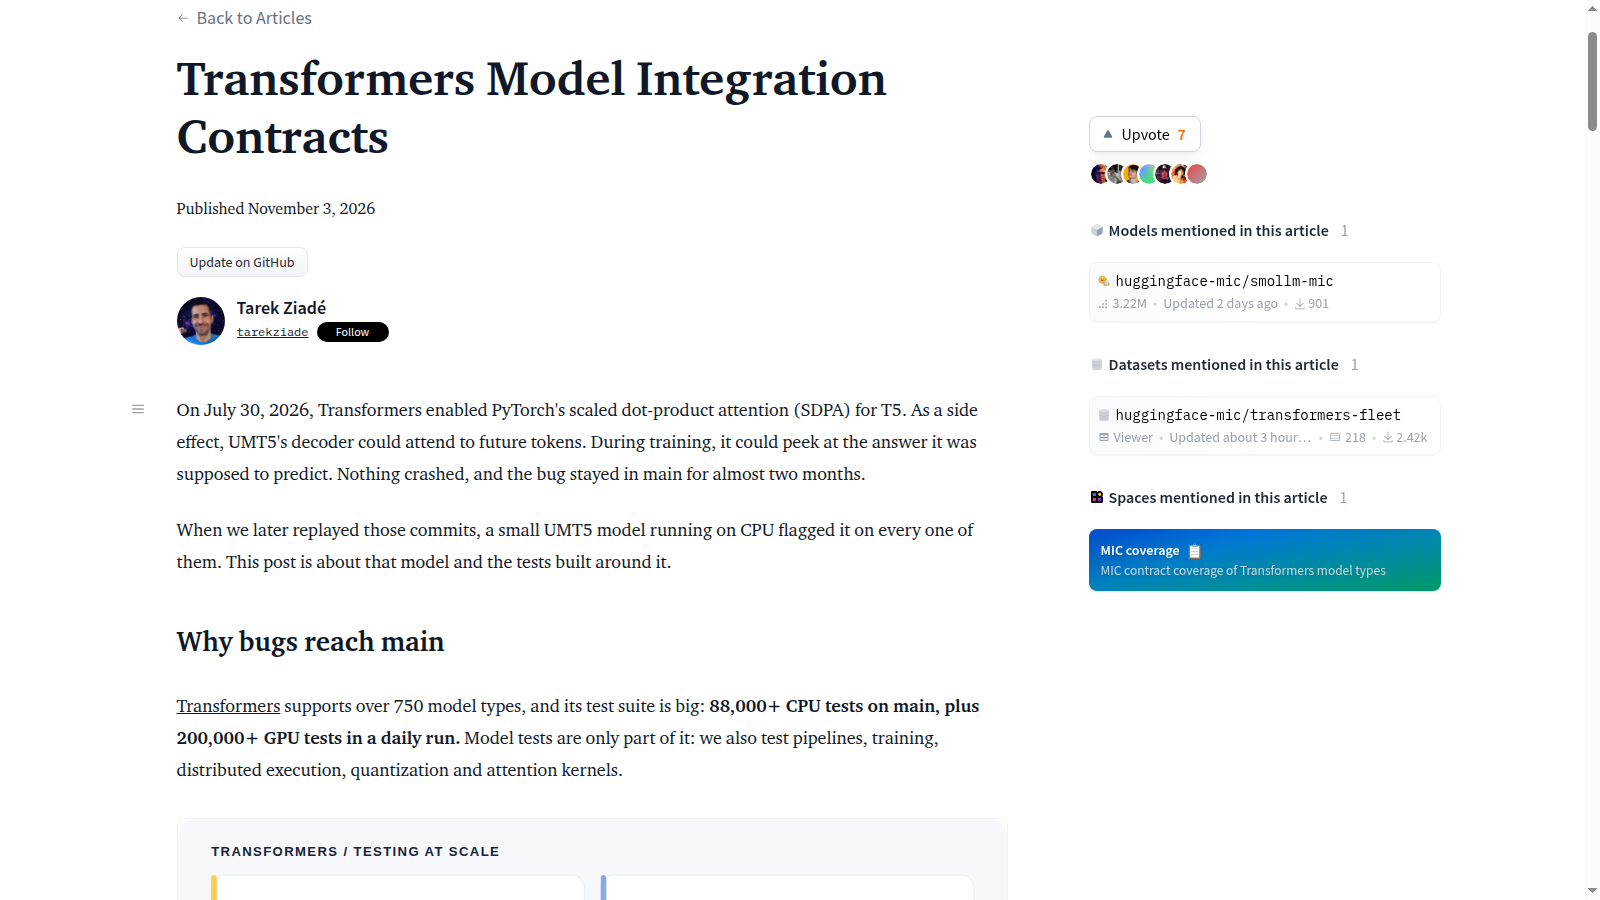
Hugging Face presenta Model Integration Contracts: piccoli modelli di prova, percorsi d’uso eseguibili e risultati di riferimento revisionati. Il replay UMT5 documentato dal progetto individua una regressione già corretta a settembre; non è una scoperta di oggi né un nostro test.
Limiti da conoscere
Limite: Lo standard è proposto e la copertura è parziale. Un PASS sulla fixture non certifica il checkpoint reale; il job sulle PR descritto dal progetto segnala errori senza bloccare il merge. Non è stato eseguito un test MIC in questa edizione.
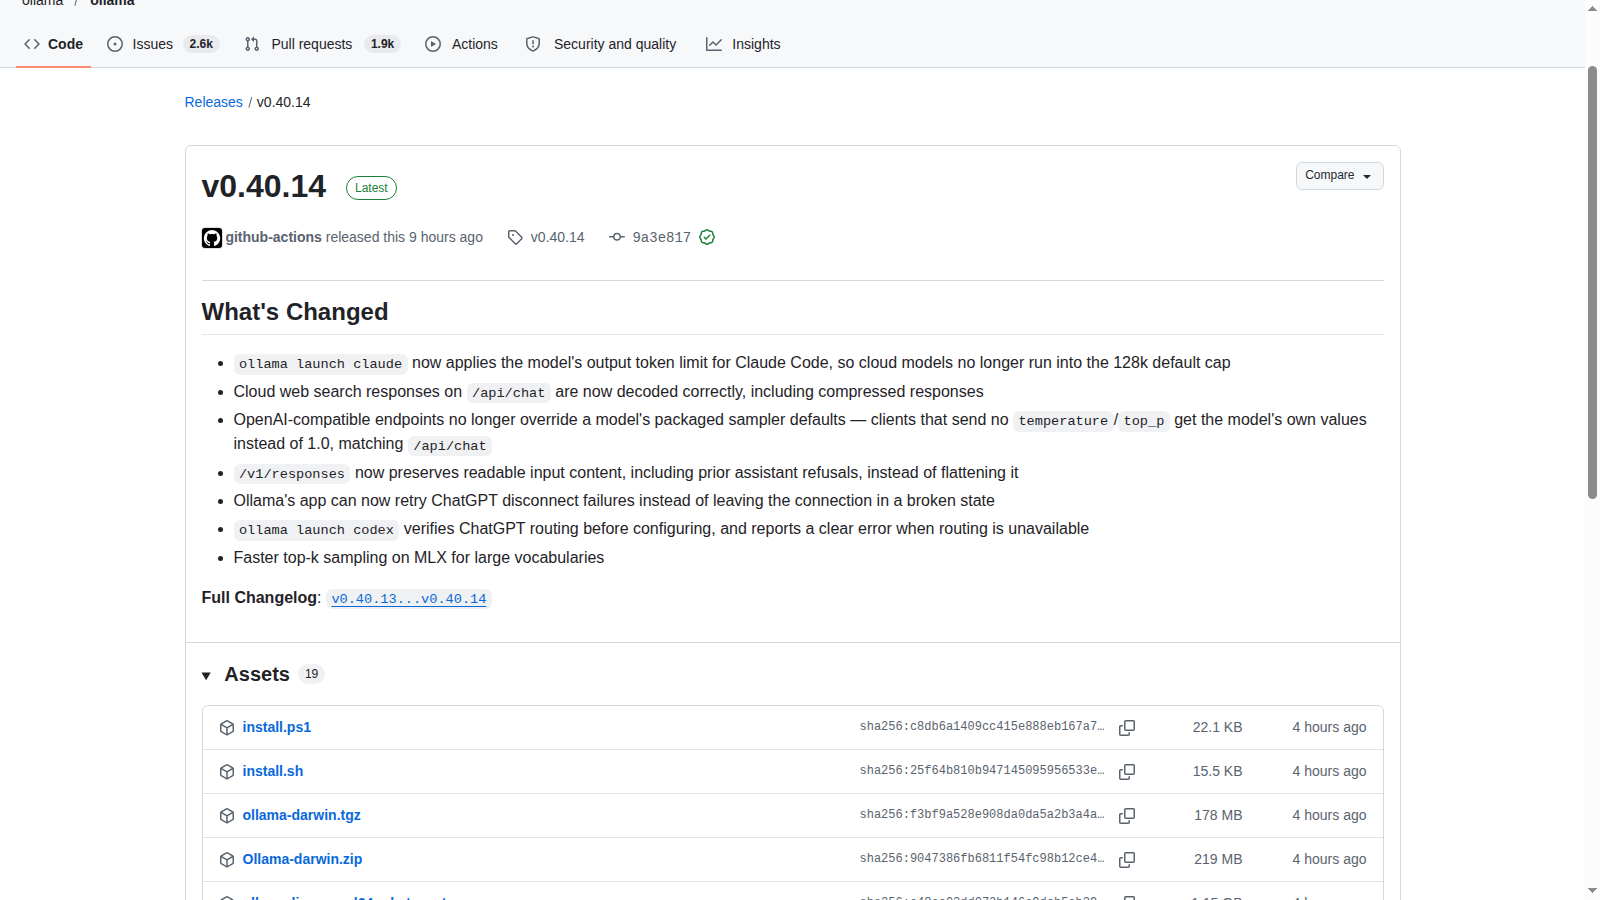
Ollama 0.40.14 risulta stabile nel REST ufficiale. Gli endpoint OpenAI-compatible non sovrascrivono più i valori sampler del modello quando il client omette temperature e top_p; arrivano anche correzioni per Responses e per il limite di output usato da Claude Code.
Limiti da conoscere
Limite: Le correzioni sono dichiarate nelle note ufficiali, non riprodotte qui. La release risulta non prerelease al controllo; l’istante esatto della promozione da release candidate non è disponibile. Nessuna promessa di qualità o velocità generale.
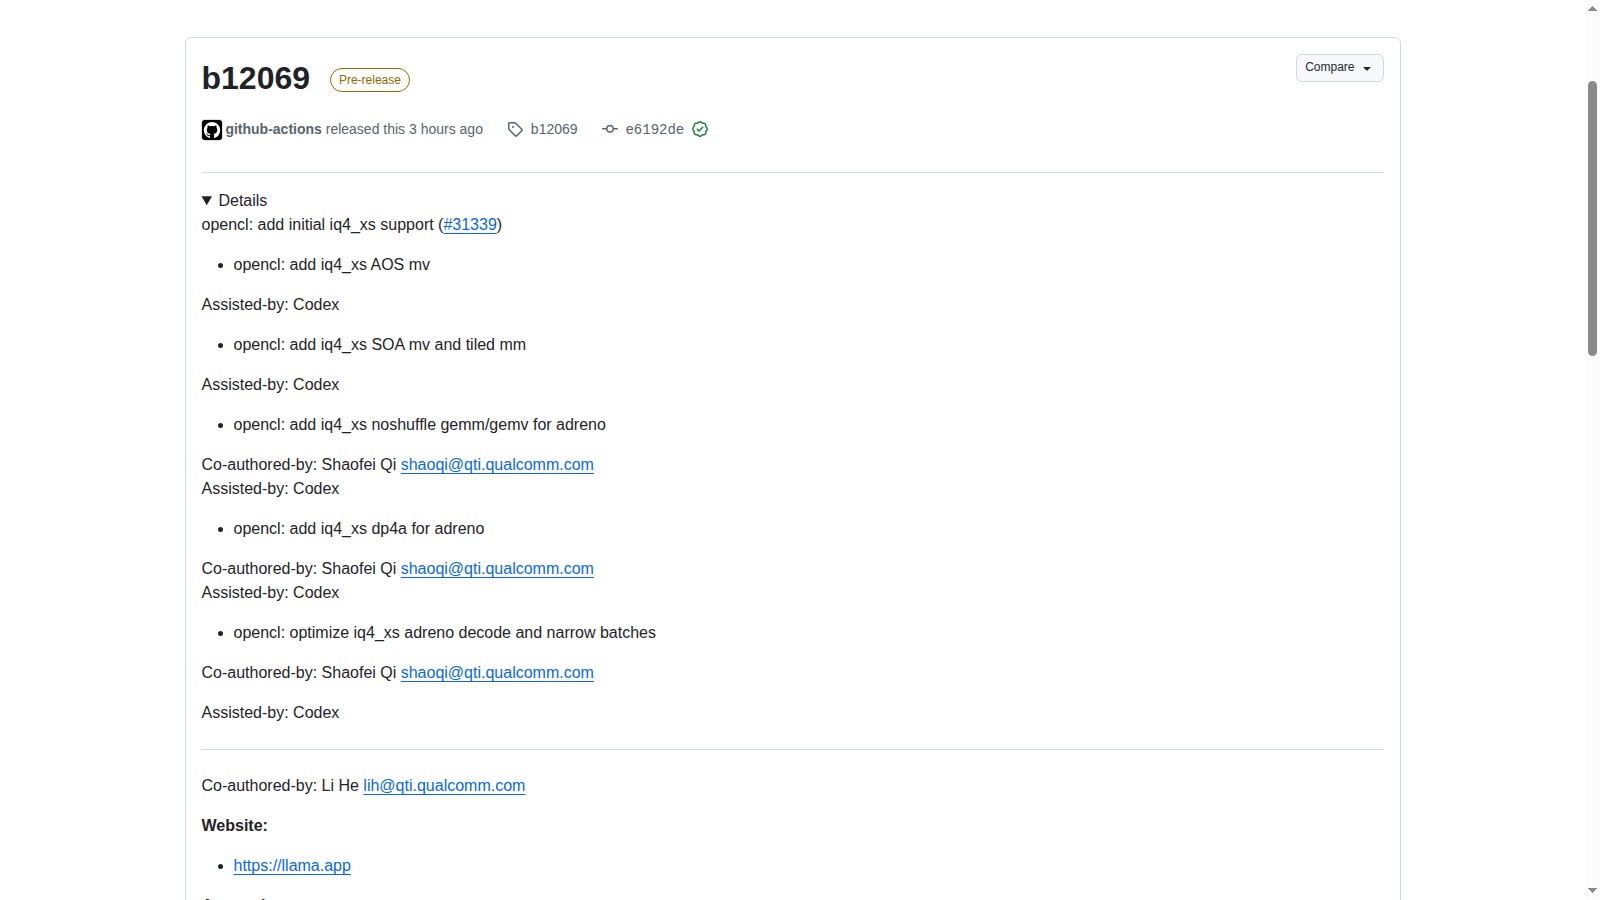
llama.cpp b12069 aggiunge il supporto iniziale a IQ4_XS nel backend OpenCL. Le modifiche comprendono percorsi di calcolo e ottimizzazioni per GPU Adreno: cambia una combinazione tra formato dei pesi e backend eseguibile, non il modello. La release è del 3 novembre e risulta prerelease nell’API ufficiale.
Limiti da conoscere
Limite: Supporto iniziale dichiarato dal progetto, non una prova su ogni GPU. Nessun test di inferenza, benchmark o aggiornamento produttivo è stato eseguito qui; la pagina OpenCL della stessa revisione non elenca ancora IQ4_XS nella tabella dei formati.
Collinear AI presenta il set pubblico di CWE-bench v2: 100 task difensivi su 91 classi CWE. L’agente deve trovare e correggere una debolezza in un repository senza rompere il comportamento legittimo. Il blog documenta l’esecuzione con Harbor; i file richiedono l’accettazione delle condizioni del dataset.
Limiti da conoscere
Limite: Annuncio e scheda pubblica verificati, benchmark non eseguito qui. I file README e registry richiesti senza autenticazione hanno restituito HTTP 401. I risultati degli autori non certificano la sicurezza di un prodotto né misurano i costi del nostro ambiente.
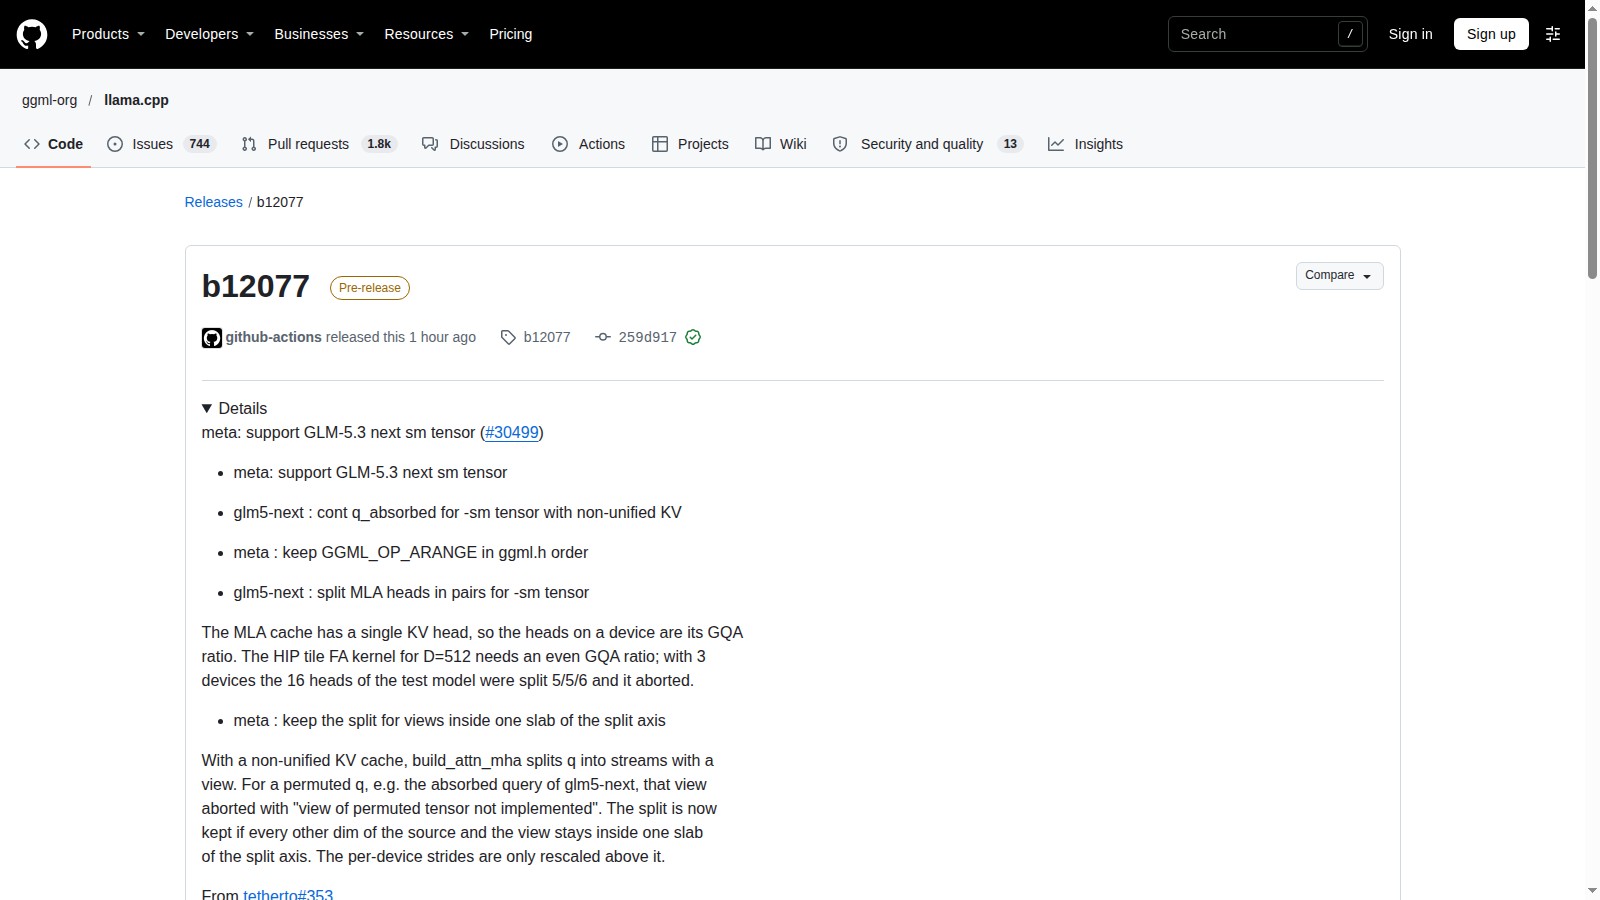
La prerelease llama.cpp b12077 abilita -sm tensor per l’architettura GLM-5.3 next. Le note descrivono anche correzioni alla divisione delle teste MLA e alle viste dei tensori con cache KV non unificata. Cambia una configurazione del runtime; non vengono annunciati nuovi pesi né un aumento di qualità del modello.
Limiti da conoscere
Limite: Release e quattro file della PR verificati; nessuna compilazione o inferenza multi-GPU eseguita qui. Il caso a tre dispositivi descritto dagli autori riguarda un modello di test con 16 teste, non ogni configurazione reale. b12077 risulta prerelease.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.