
L’ANALISI
llama.cpp IQ4_XS: supporto OpenCL per GPU Adreno
llama.cpp b12069 aggiunge IQ4_XS al backend OpenCL, con kernel per Adreno. È una prerelease: requisiti, limiti e protocollo di verifica.
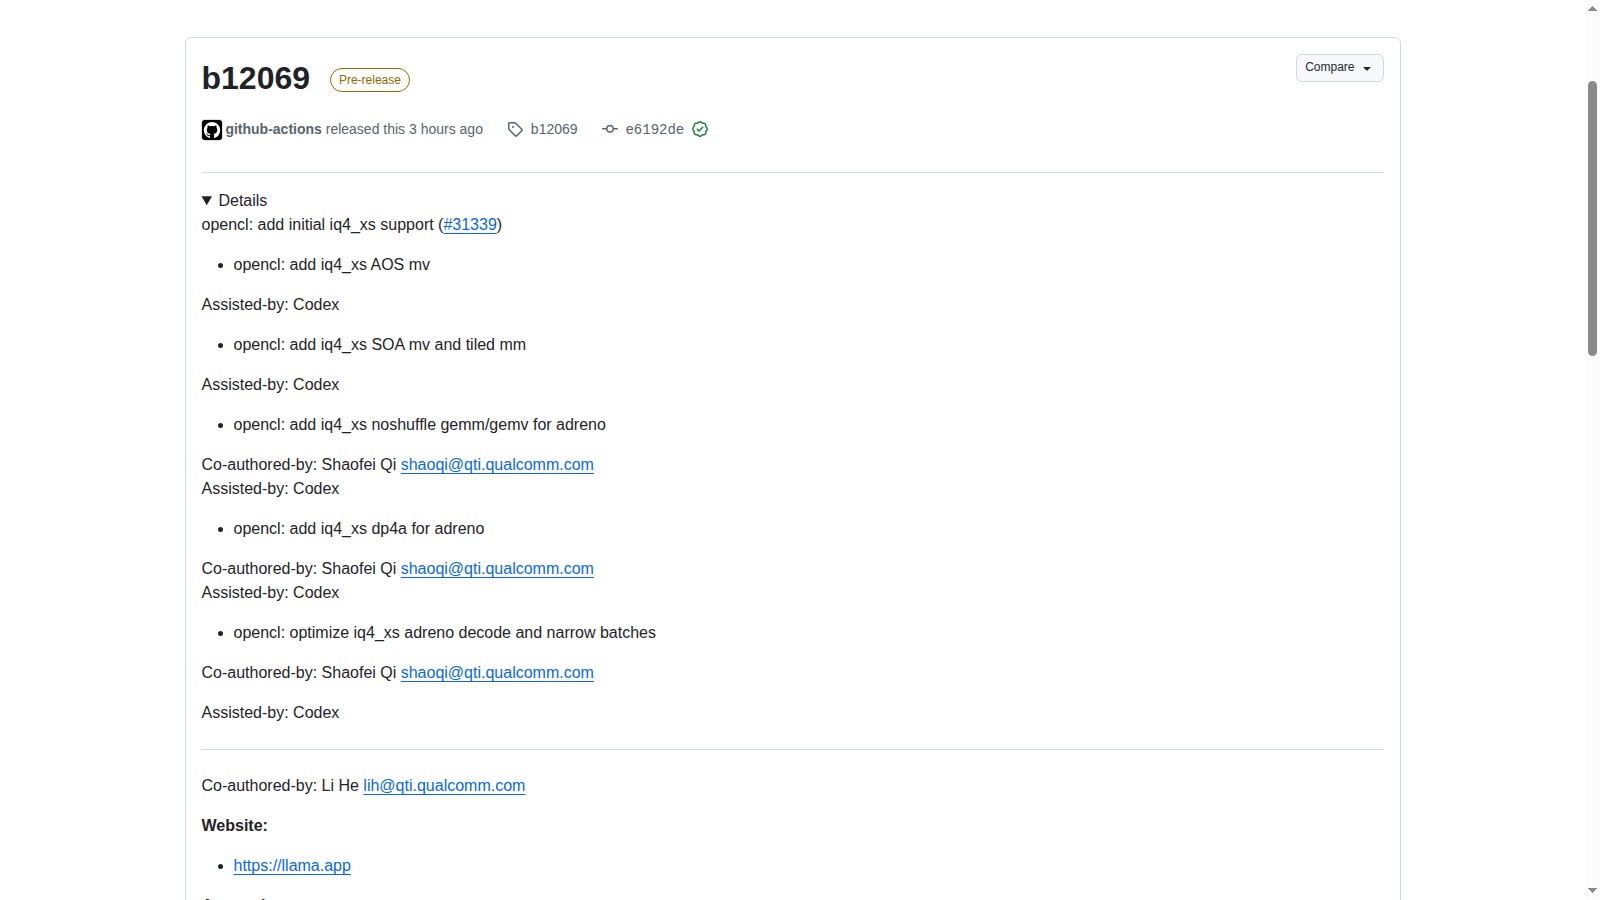
In breve: llama.cpp b12069 introduce IQ4_XS nel backend OpenCL, con percorsi dedicati anche alle GPU Adreno. È rilevante per chi vuole provare quel formato su quel backend, non un annuncio di nuovi pesi. La release risulta prerelease: prima di usarla in un flusso stabile servono una prova sulla propria GPU e un confronto con la build precedente. Note ufficiali di b12069.
Metodo: lettura delle note ufficiali, dell’API GitHub, dei dieci file modificati dalla PR e della documentazione congelata al commit e6192de0a62b73f566f825ecb531f7e4fe699eae. Merge: 3 novembre 2026 alle 06:58:19 ora italiana; pubblicazione della prerelease: 12:19:51. Nessuna compilazione, inferenza o misura su hardware Adreno è stata effettuata dalla redazione in questo ciclo. PR: merge e commit; API della release.
Che cosa cambia per i GGUF IQ4_XS?
La novità riguarda l’esecuzione di IQ4_XS tramite OpenCL: il diff aggiunge kernel e gestione del formato nel backend. Le note distinguono operazioni matrice-vettore e matrice-matrice, oltre ai percorsi Adreno. Non è un nuovo checkpoint né una conversione automatica dei modelli già presenti. Per decidere se interessa al proprio ambiente, il primo controllo proposto è identificare il formato effettivo del GGUF e il backend selezionato: il solo nome del modello non basta. PR 31339: i file modificati nel backend OpenCL.
Quali GPU e driver bisogna verificare?
La documentazione del backend indica Adreno come primo obiettivo e cita anche alcune GPU Intel, senza presentarle come equivalenti per prestazioni. L’elenco dei dispositivi verificati è del progetto e riguarda il backend: non certifica questa nuova combinazione IQ4_XS su ogni macchina. La stessa guida avverte che driver e compilatori datati possono escludere alcune GPU A6x presenti nei telefoni. Prima del download conviene quindi registrare GPU, sistema operativo e versione del driver, poi scegliere la procedura ufficiale adatta alla piattaforma. Guida OpenCL alla revisione della release: hardware e requisiti.
È una release stabile e la guida è già allineata?
No: al controllo l’API restituisce draft=false e prerelease=true per b12069. Il merge della PR e la pubblicazione del pacchetto sono due istanti distinti, entrambi del 3 novembre. Inoltre, nella documentazione OpenCL congelata allo stesso commit, la tabella dei formati non include ancora IQ4_XS. Per questa aggiunta il riferimento è il diff insieme alle note della release; la tabella incompleta non dimostra che la modifica manchi dal codice. Chi cerca una build stabile non dovrebbe interpretare il numero del tag come una garanzia di stabilità. GitHub REST: stato e date di b12069; Tabella dei formati nella guida OpenCL congelata.
Come verificare il cambiamento senza confonderlo con un benchmark?
Protocollo proposto, non eseguito: conservare la build precedente e fissare hash del GGUF, prompt, contesto e parametri. In un ambiente di prova, controllare dai log che venga usato OpenCL e non un percorso CPU inatteso. Ripetere lo stesso caso con b12069, annotando caricamento, errori e coerenza dell’output prima di misurare tempi. Se si raccolgono prestazioni, separare elaborazione del prompt e generazione, mantenendo identiche le condizioni. Il fatto che un caso parta non basta a dimostrare compatibilità generale, qualità superiore o vantaggio energetico. PR ufficiale: ambito del supporto iniziale IQ4_XS.
Condizioni e limitazioni
Supporto iniziale dichiarato dal progetto, non una prova su ogni GPU. Nessun test di inferenza, benchmark o aggiornamento produttivo è stato eseguito qui; la pagina OpenCL della stessa revisione non elenca ancora IQ4_XS nella tabella dei formati. Documentazione OpenCL congelata.
Checklist pratica
- Conservare la build funzionante e una procedura di ritorno, senza aggiornare subito la produzione.
- Registrare sistema, GPU, driver e versione esatta di llama.cpp.
- Identificare un GGUF IQ4_XS con hash e licenza verificati; non attribuire al runtime una licenza dei pesi.
- Seguire la guida OpenCL per la propria piattaforma e verificare il backend effettivo nei log.
- Confrontare lo stesso caso prima e dopo, con dati non sensibili e parametri fissi.
- Separare riuscita del caricamento, correttezza e prestazioni; fermarsi in presenza di errori non spiegati.