
L’ANALISI
llama.cpp b12077: GLM-5.3 next e tensor split GPU
llama.cpp b12077 abilita -sm tensor per GLM-5.3 next e corregge casi multi-GPU. La prerelease richiede una verifica su hardware e driver propri.
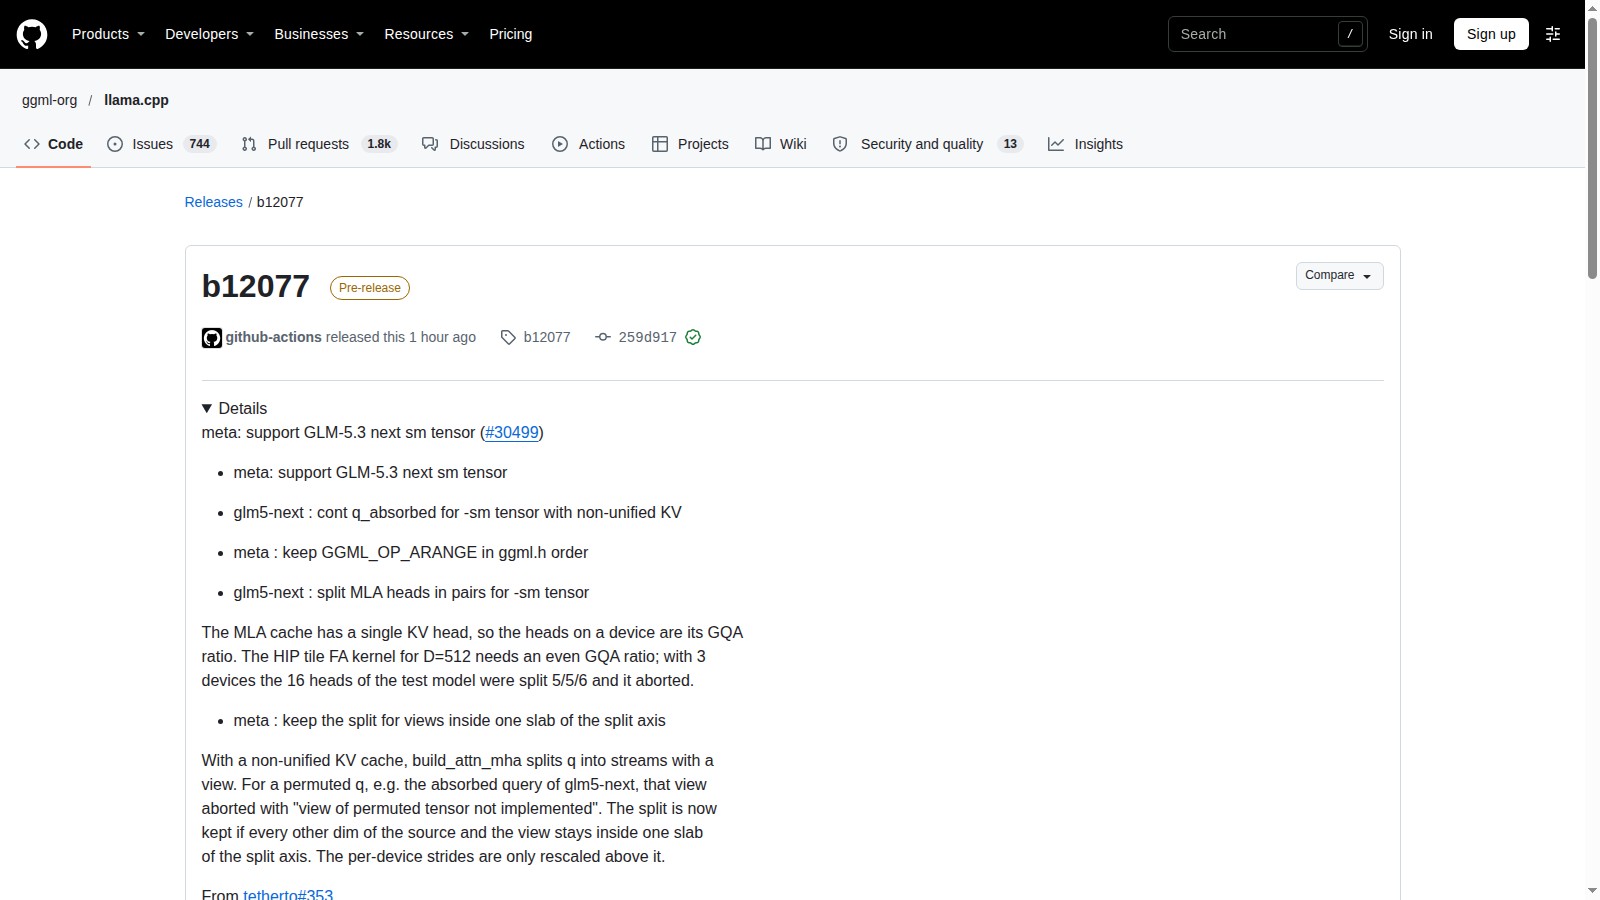
In breve: llama.cpp b12077 aggiunge il supporto di -sm tensor per GLM-5.3 next e corregge casi di suddivisione multi-GPU. È una prerelease pubblicata il 3 novembre 2026: interessa chi vuole provare questa architettura con quella modalità, non chi cerca nuovi pesi. Non abbiamo riprodotto i casi su GPU. llama.cpp b12077: note ufficiali della prerelease.
Verifica documentale del 3 novembre 2026: lettura della release, dell’oggetto GitHub REST e dei quattro file modificati dalla PR 30499. La PR è stata aperta il 14 ottobre, unita il 3 novembre alle 09:51 ora italiana; b12077 è stata pubblicata alle 18:50 ora italiana. Il commit della release è 259d91709d60945911bedb9bcfb2957c6e153ea7. Nessun aggiornamento produttivo è stato effettuato.
Che cosa abilita -sm tensor per GLM-5.3 next?
La PR aggiunge il supporto della modalità tensor split per questa architettura. Il diff rimuove GLM5_NEXT dall’elenco delle architetture non supportate e aggiunge regole dedicate per distribuire tensori e stati. Il delta è nel runtime: non modifica i pesi, non cambia la loro licenza e non costituisce una nuova release del modello. Per valutarne l’utilità bisogna verificare il file GGUF effettivamente usato e il percorso di esecuzione selezionato. PR 30499: quattro file modificati.
Perché le note parlano di 16 teste su tre dispositivi?
Gli autori descrivono un modello di test con 16 teste MLA distribuite in gruppi 5/5/6 su tre dispositivi. Nel caso riportato, il kernel HIP di flash attention per dimensione 512 richiede un rapporto GQA pari: quella divisione portava a un arresto. La modifica divide le teste MLA a coppie. È un caso tecnico preciso utile per costruire una regressione; non è una misura di prestazioni e non certifica tutte le GPU AMD. llama.cpp b12077: note ufficiali della prerelease.
Che cosa cambia con la cache KV non unificata?
Le note collegano un altro arresto alla vista di un tensore permutato quando la cache KV non è unificata. Il backend mantiene la suddivisione nei casi in cui le altre dimensioni restano all’interno dello stesso segmento dell’asse diviso. La release menziona anche la rimozione di un passaggio di contiguità non più necessario, collegato a un arresto quando la flash attention finiva su CPU nel percorso WebGPU. Sono correzioni descritte dal progetto, non prove effettuate dalla redazione. llama.cpp b12077: note ufficiali della prerelease.
È una versione stabile e quando è arrivata davvero?
L’oggetto REST della release restituisce draft=false e prerelease=true. Apertura della PR, merge e pubblicazione del pacchetto non coincidono: la discussione inizia il 14 ottobre, mentre merge e prerelease sono del 3 novembre. Per riprodurre il delta conviene fissare b12077 e il commit indicato, non limitarsi al ramo corrente. La presenza di asset scaricabili non trasforma una prerelease in una build certificata per la produzione. GitHub REST: stato, commit e data di b12077.
Come confrontarla con la build che già funziona?
Protocollo proposto, non eseguito: conservare la build precedente e registrare hash del GGUF, backend, GPU, driver, numero di dispositivi, cache e parametri del contesto. Ripetere un caso controllato con la stessa topologia e controllare prima caricamento, errori e coerenza dell’output. Solo dopo ha senso misurare tempi con identiche condizioni. Se l’ambiente non usa GLM-5.3 next o tensor split, questa singola modifica non è da sola una ragione per aggiornare. PR 30499: supporto GLM-5.3 next per tensor split.
Condizioni e limitazioni
Release e quattro file della PR verificati; nessuna compilazione o inferenza multi-GPU eseguita qui. Il caso a tre dispositivi descritto dagli autori riguarda un modello di test con 16 teste, non ogni configurazione reale. b12077 risulta prerelease.
Checklist pratica
- Conservare la build funzionante e una procedura di ritorno.
- Fissare b12077 e il commit 259d91709d60945911bedb9bcfb2957c6e153ea7.
- Registrare GGUF, hardware, backend, driver e topologia dei dispositivi.
- Controllare modalità tensor split e configurazione della cache KV.
- Ripetere un caso con dati non sensibili e condizioni identiche prima e dopo.
- Separare assenza di arresti, qualità dell’output e prestazioni misurate.