
IL PUNTO SULL’AI
16 ottobre 2026
llama.cpp abilita Granite Switch per decisioni locali, Beam rende scaricabili i checkpoint agentici e Hermes Business porta skill condivise nelle aziende.
In questa edizione 5 notizie
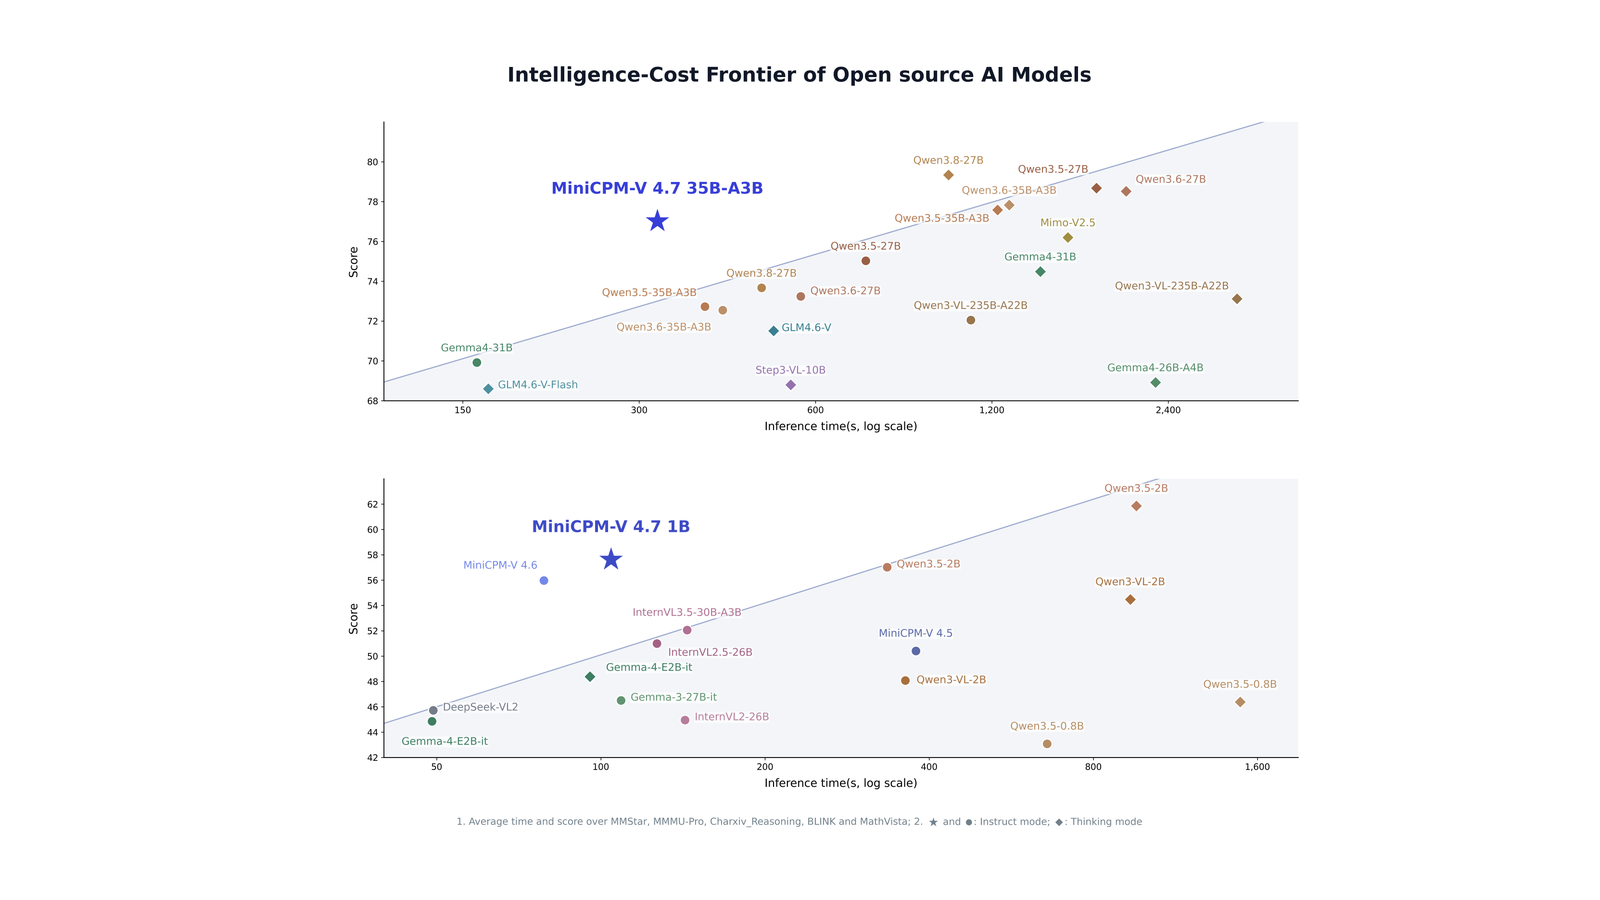
OpenBMB ha pubblicato i repository GGUF ufficiali di MiniCPM-V 4.7 nelle varianti 1B e MoE 35B-A3B. Sono disponibili profili da F16 a IQ4_XS, i proiettori visivi mmproj e file DSpark; le model card documentano l’uso diretto con llama.cpp e indicano anche Ollama per entrambe le taglie.
Limiti da conoscere
Limite: La pubblicazione dei file non equivale a una prova indipendente su ogni dispositivo. Il 35B-A3B richiede spazio e banda rilevanti nonostante attivi circa 3B parametri per token; i 13+ token/s su iPhone 17 Pro Max e i confronti di qualità restano misure dichiarate dal progetto.
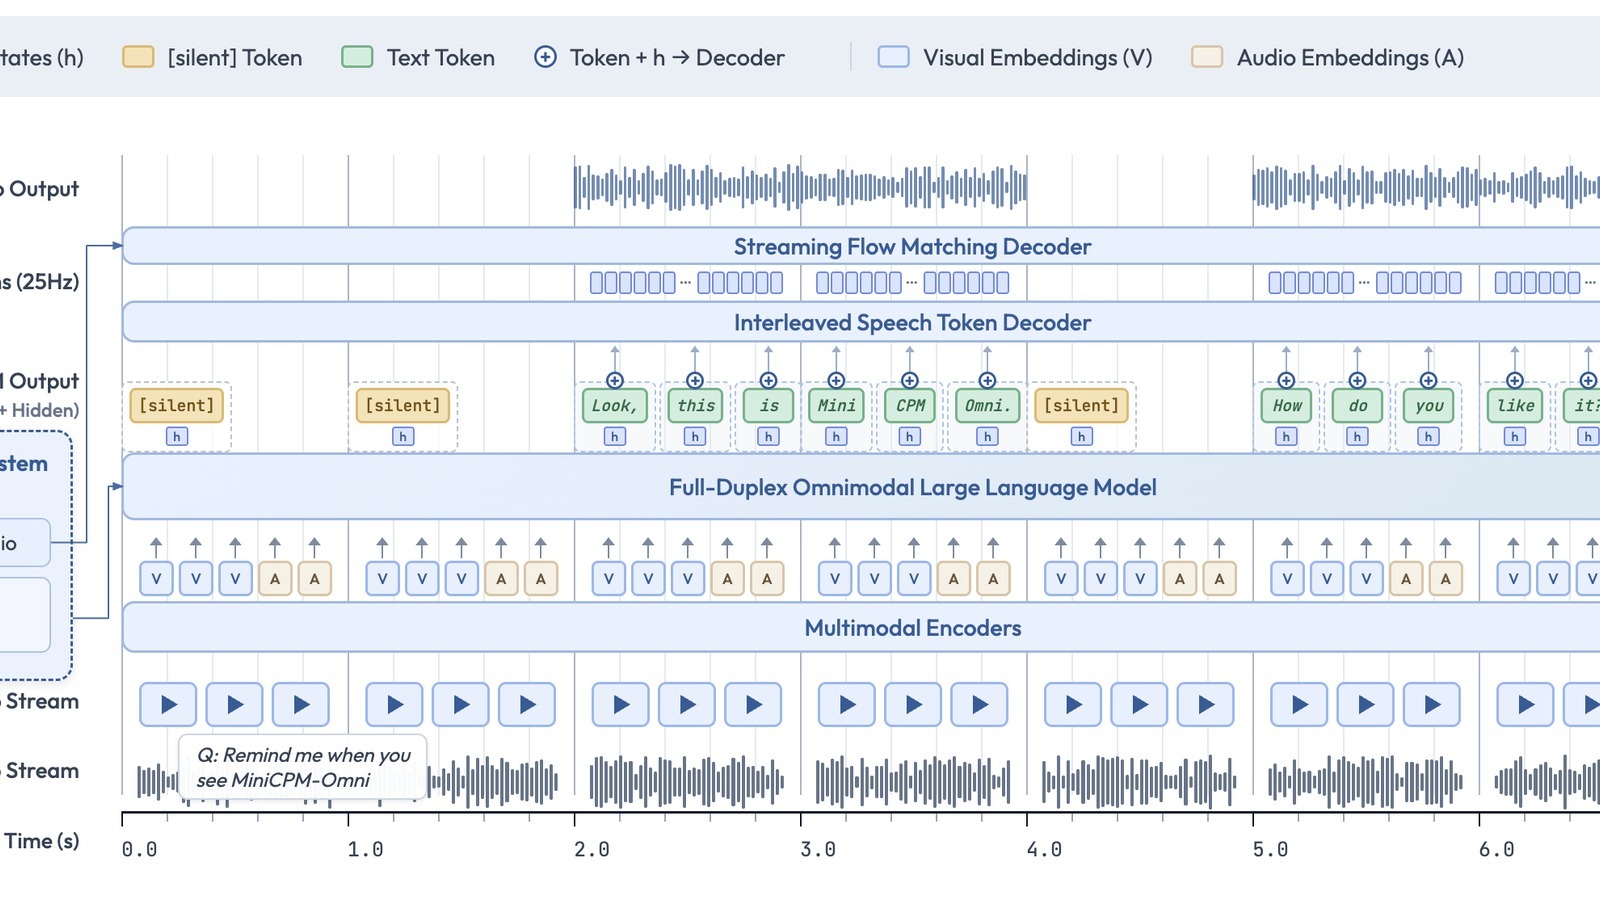
OpenBMB ha caricato su Hugging Face i pesi completi di MiniCPM-o 4.5, un modello omnimodale end-to-end da 9B parametri basato su Qwen3-8B, SigLip2, Whisper-medium e CosyVoice2. Il pacchetto permette inferenza locale su immagini, video, audio e voce, inclusa una modalità full-duplex che riceve flussi audio-video mentre genera testo e parlato.
Limiti da conoscere
Limite: Il modello richiede codice remoto personalizzato e, per il percorso Transformers documentato, transformers 4.51.0, PyTorch 2.3-2.8, FFmpeg e una GPU NVIDIA. Velocità, memoria e benchmark sono dichiarati dal progetto e non sono stati riprodotti in questo run. Voice cloning e interazione proattiva richiedono inoltre controlli espliciti su consenso, identità e uso dei campioni vocali.
Nous Research ha presentato Hermes Business, una versione organizzativa dello stack Hermes che condivide automaticamente le skill scoperte dai team, rende visibili costi e ritorno dei modelli e conserva skill, memoria e workflow come capacità aziendale. Per Enterprise sono dichiarati deployment on-prem o private cloud, SSO, SLA e onboarding dedicato.
Limiti da conoscere
Limite: La pagina pubblica non espone prezzi, tempi di disponibilità, matrice dei provider, dettagli tecnici su isolamento e sincronizzazione, né documentazione verificabile per SSO, audit e amministrazione. Le cifre di adozione e consumo token riportate nel post sul finanziamento sono stime interne di Nous e non sono state validate indipendentemente.
Reflection ha pubblicato i pesi instruction-tuned di Beam in BF16, FP8 e NVFP4 con licenza Apache 2.0. Il modello MoE conta 501,3 miliardi di parametri totali, 23,4 miliardi attivi per token e una finestra di contesto dichiarata da un milione di token. Il lancio include supporto per Transformers, vLLM, SGLang e diversi provider, oltre a percorsi self-hosted e on-prem.
Limiti da conoscere
Limite: I benchmark, l’efficienza e i risultati di sicurezza sono dichiarazioni del produttore e non equivalgono a una prova indipendente end-to-end. La dimensione complessiva resta impegnativa anche con 23,4B parametri attivi; nel controllo anonimo il repository dei pesi su Hugging Face ha restituito HTTP 401, quindi accesso e condizioni effettive vanno verificati con un account prima di pianificare il deployment.
La build b11700 di llama.cpp aggiunge conversione e serving per Granite Switch 4.1 8B come modello sia conversazionale sia decisionale. Il server espone chat tramite `/v1/chat/completions` e decisioni strutturate tramite `/v1/systemone`; la modifica è stata provata dal contributore in BF16 e Q4_K_M ed è distribuita nei binari della release per Linux, Windows, macOS, Android e iOS.
Limiti da conoscere
Limite: Il test pubblicato nel pull request è del contributore e non una verifica indipendente. Il supporto riguarda il checkpoint Granite Switch 4.1 8B con adapter `decision`; accuratezza, calibrazione delle probabilità, memoria e velocità vanno misurate sui propri casi. La componente speech documentata dal modello non è il delta verificato di questa build llama.cpp.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.