
IL PUNTO SULL’AI
19 ottobre 2026
MiniMax M3.1 Flash apre un confronto su API e costi senza pesi locali, mentre Cairn, MiniCPM-V, llama.cpp, Otari ed EN 18286 coprono sicurezza, edge, inferenza e governance.
In questa edizione 6 notizie
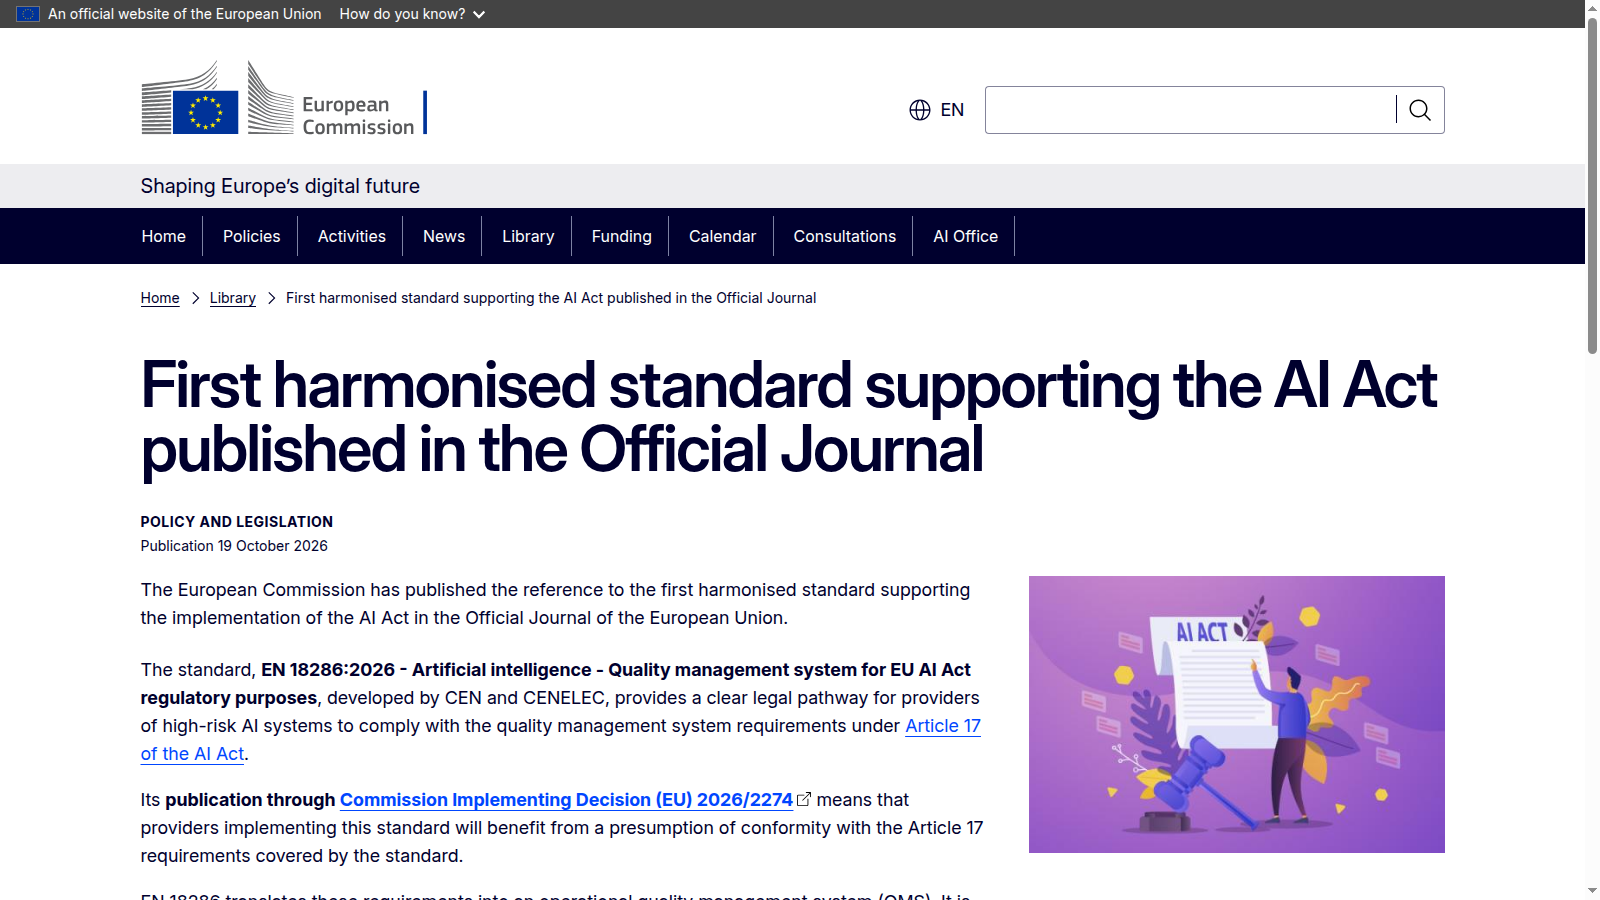
La Commissione europea ha pubblicato nella Gazzetta ufficiale il riferimento a EN 18286:2026, standard per il sistema di gestione della qualità dei provider di sistemi AI ad alto rischio. L’applicazione delle parti coperte attribuisce una presunzione di conformità ai requisiti dell’articolo 17 e consente di integrare il nuovo schema sopra ISO/IEC 42001, ISO 9001 o sistemi qualità settoriali esistenti.
Limiti da conoscere
Limite: La presunzione di conformità riguarda i requisiti dell’articolo 17 coperti dallo standard, non l’intero AI Act e non certifica automaticamente un sistema o un prodotto. Il testo completo di EN 18286 è distribuito dagli organismi di normazione e l’implementazione va adattata al ruolo, al rischio e al settore del provider.
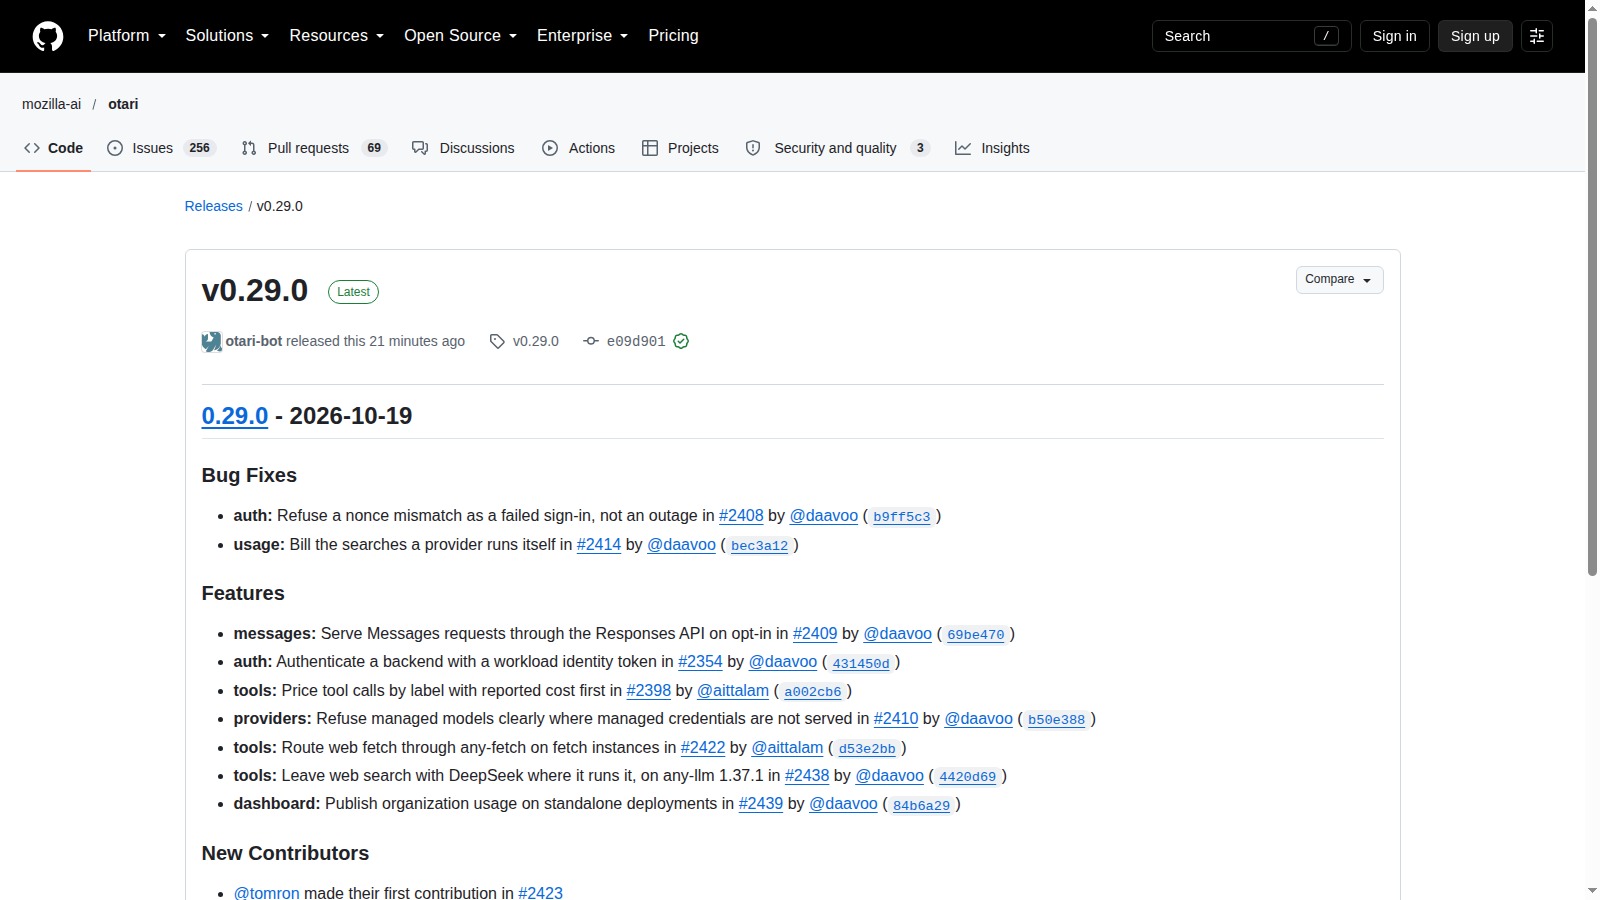
Mozilla AI ha pubblicato Otari 0.29.0, release del gateway LLM self-hostable che aggiunge autenticazione dei backend con token di workload identity, instradamento opt-in delle richieste Anthropic Messages verso la Responses API, prezzi dei tool distinti per etichetta e vista dell’uso dell’organizzazione anche nelle installazioni standalone.
Limiti da conoscere
Limite: Le funzioni sono configurabili e non equivalgono a compatibilità universale. La federazione e il bridge Messages-Responses restano opt-in; le credenziali gestite non coprono automaticamente embeddings, immagini, audio, rerank, moderazioni o batch. In questo ciclo sono stati verificati release e cambiamenti upstream, ma non è stato eseguito un test end-to-end con provider reali.
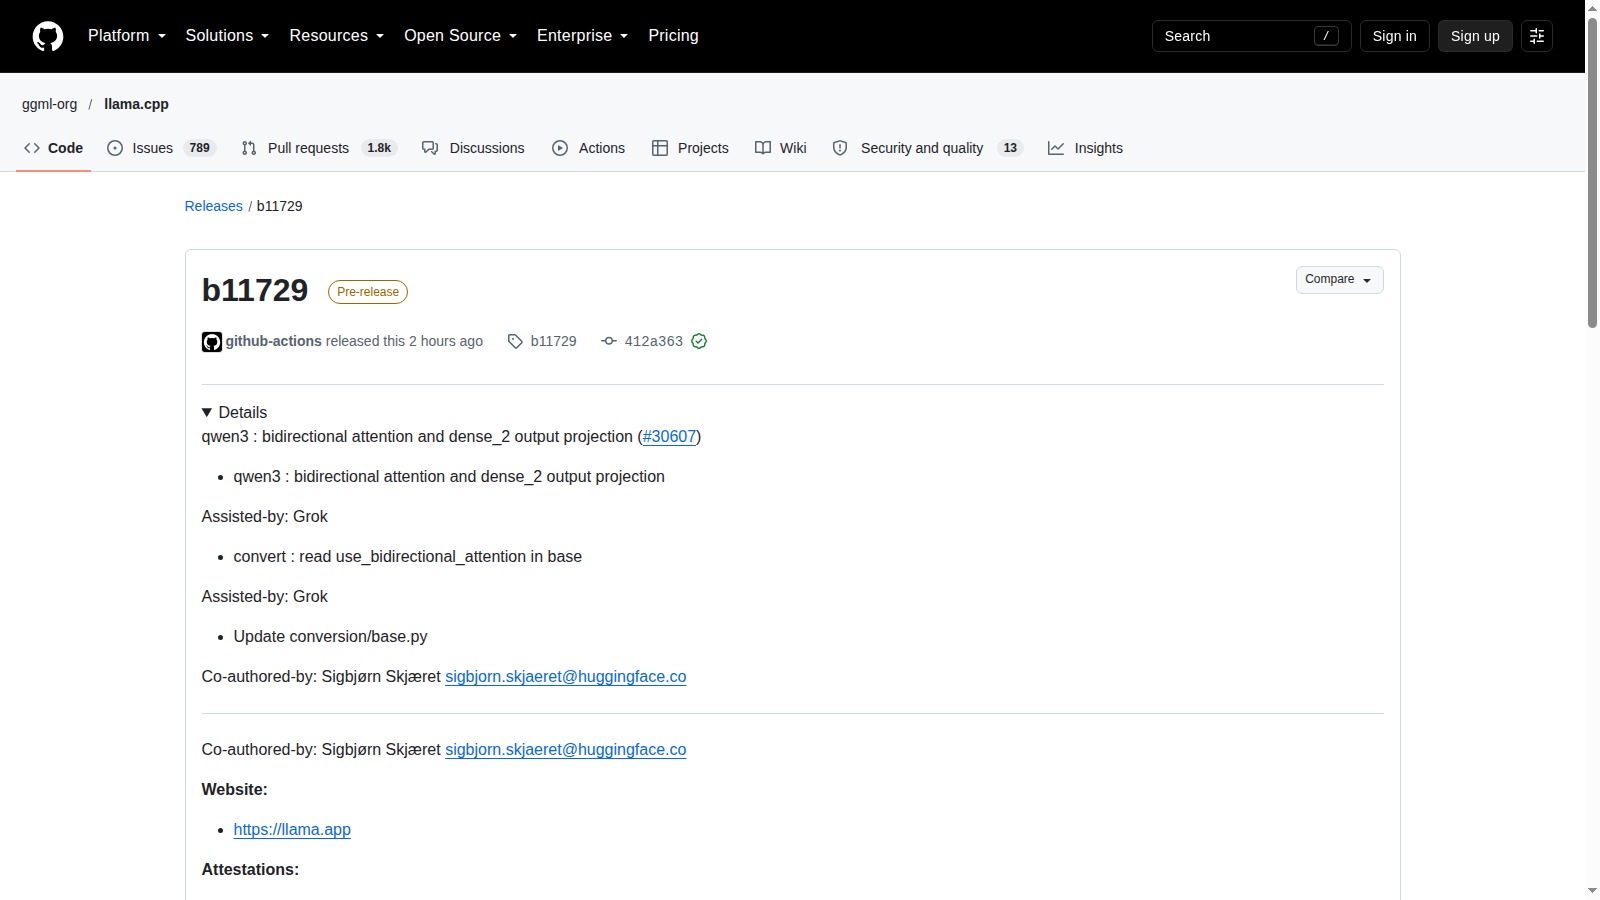
llama.cpp b11729 aggiunge il percorso necessario per Voyage 4 Nano, modello embedding basato su Qwen3: il convertitore ora legge il flag di attenzione bidirezionale e il runtime carica la proiezione finale dense_2 prima del pooling. I checkpoint Qwen3 che non usano questi campi continuano a essere caricati come prima.
Limiti da conoscere
Limite: La release corregge conversione e caricamento, ma non dimostra da sola la parità numerica con il runtime di riferimento né la qualità del retrieval dopo una quantizzazione. In questo ciclo sono stati verificati release, pull request e artefatti disponibili, senza eseguire un confronto end-to-end su un corpus locale.
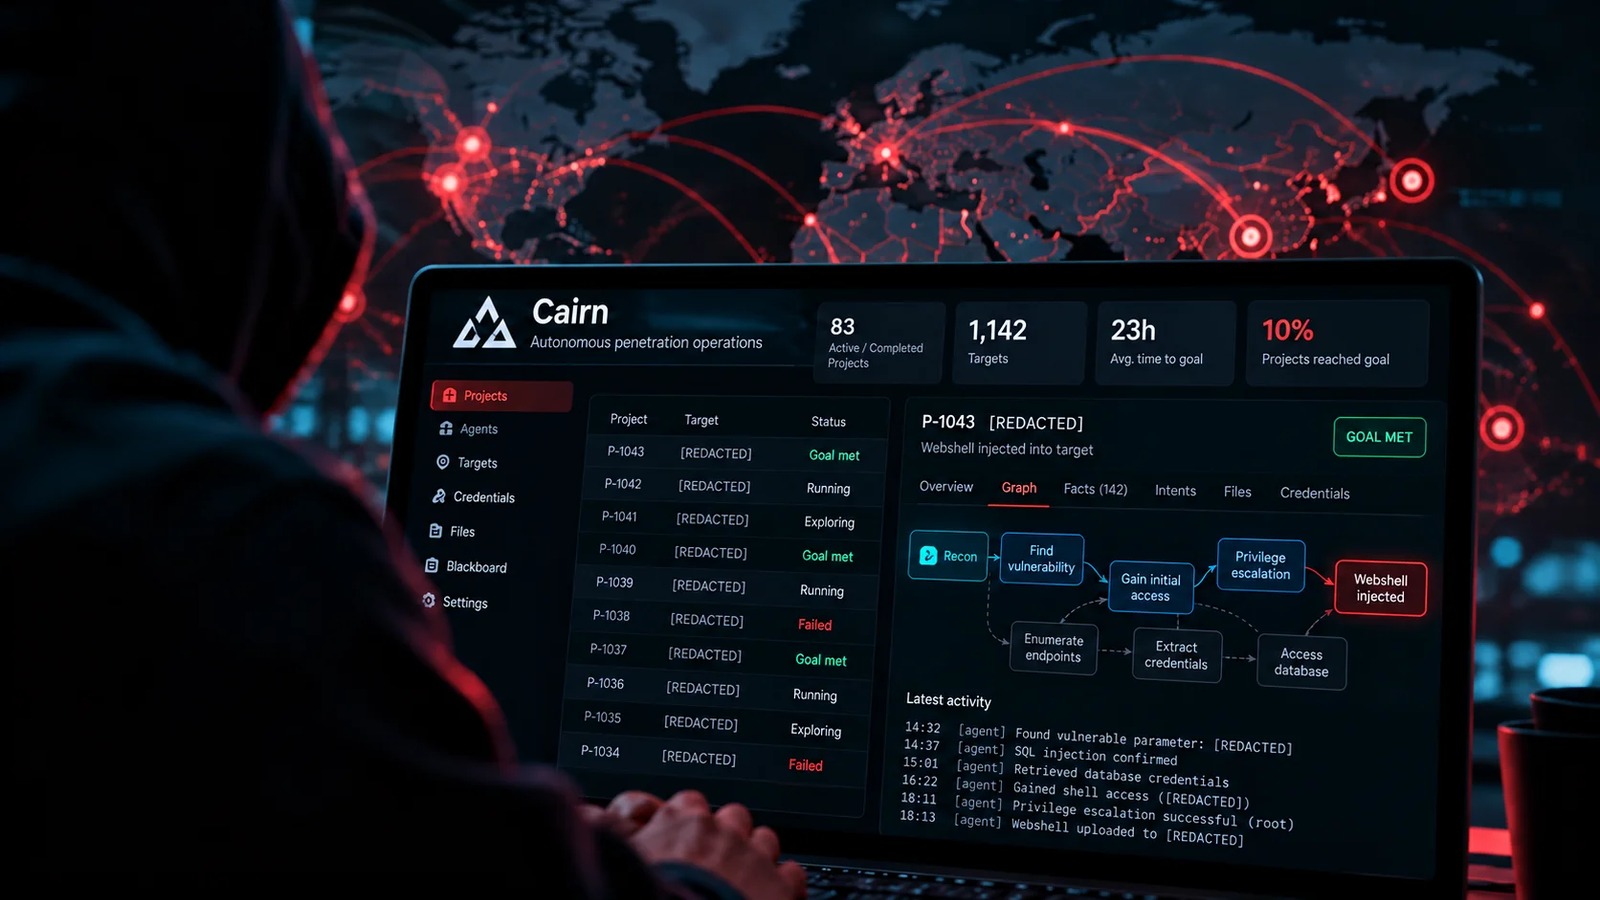
NorForge ha individuato oltre 20 pannelli Cairn probabilmente collegati ad attività malevole; il cluster più attivo comprendeva più di 1.100 progetti su 14 dashboard. Il dato utile non è il numero di agenti, ma ciò che i pannelli lasciavano visibile: target, istruzioni, segreti, API key, risultati e accessi persistenti.
Limiti da conoscere
Limite: Il rapporto è l’analisi dell’azienda che ha scoperto i pannelli e non costituisce un censimento completo. L’attribuzione resta per cluster operativi e linguistici, non identifica con certezza persone o organizzazioni; in questo ciclo non è stata riprodotta alcuna intrusione.
OpenBMB ha pubblicato MiniCPM-V 4.7 1B con pesi Safetensors e varianti AWQ, GPTQ e INT4, oltre alle guide per GGUF e FP8. La scheda dichiara supporto per iOS, Android e HarmonyOS e per backend come vLLM, SGLang, llama.cpp e Ollama: ora il modello può essere scaricato e confrontato su hardware reale.
Limiti da conoscere
Limite: Disponibilità e compatibilità dichiarata non dimostrano qualità, latenza o stabilità sul dispositivo di destinazione. I grafici sono del progetto e in questo ciclo non è stato eseguito un benchmark indipendente su telefono, AMD o altri sistemi locali.
MiniMax ha reso M3.1 Flash disponibile tramite API, M Plan e MiniMax Code con prezzi dichiarati di 0,15 dollari per milione di token in input, 0,60 in output e 0,015 per input in cache. Il modello è quindi acquistabile e misurabile come servizio cloud, ma i pesi non sono ancora stati pubblicati.
Limiti da conoscere
Limite: Velocità, risparmio del 70% e risultati su agenti, coding, computer use e cybersecurity sono misure dichiarate da MiniMax. In questo ciclo non sono stati replicati su task e budget controllati; senza pesi, licenza e runtime verificati M3.1 Flash non va descritto come modello locale o self-hosted.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.