
IL PUNTO SULL’AI
17 ottobre 2026
OpenCode gestisce una violazione di Console, LiteLLM corregge le tool call nel bridge Responses e llama.cpp integra i download da Hugging Face.
In questa edizione 9 notizie
La prerelease b11701 di llama.cpp aggiunge il supporto a Beam 1.0 501B-A23B: conversione in GGUF, grafo Mixture-of-Experts, chat template e parser delle tool call Harmony XML. Il contributore dichiara conversione del checkpoint reale, caricamento di GGUF quantizzati su CUDA e sessioni multi-turno con chiamate parallele agli strumenti; Unsloth pubblica varianti GGUF da BF16 fino a quantizzazioni IQ e Q-K.
Limiti da conoscere
Limite: b11701 è una prerelease e Beam resta un modello da 501B parametri totali, quindi il supporto software non lo rende automaticamente pratico su una singola workstation. Le prove sul checkpoint reale sono dichiarate nel pull request del contributore, non riprodotte in questo run; qualità, memoria, throughput e affidabilità delle tool call vanno misurati sul proprio hardware.
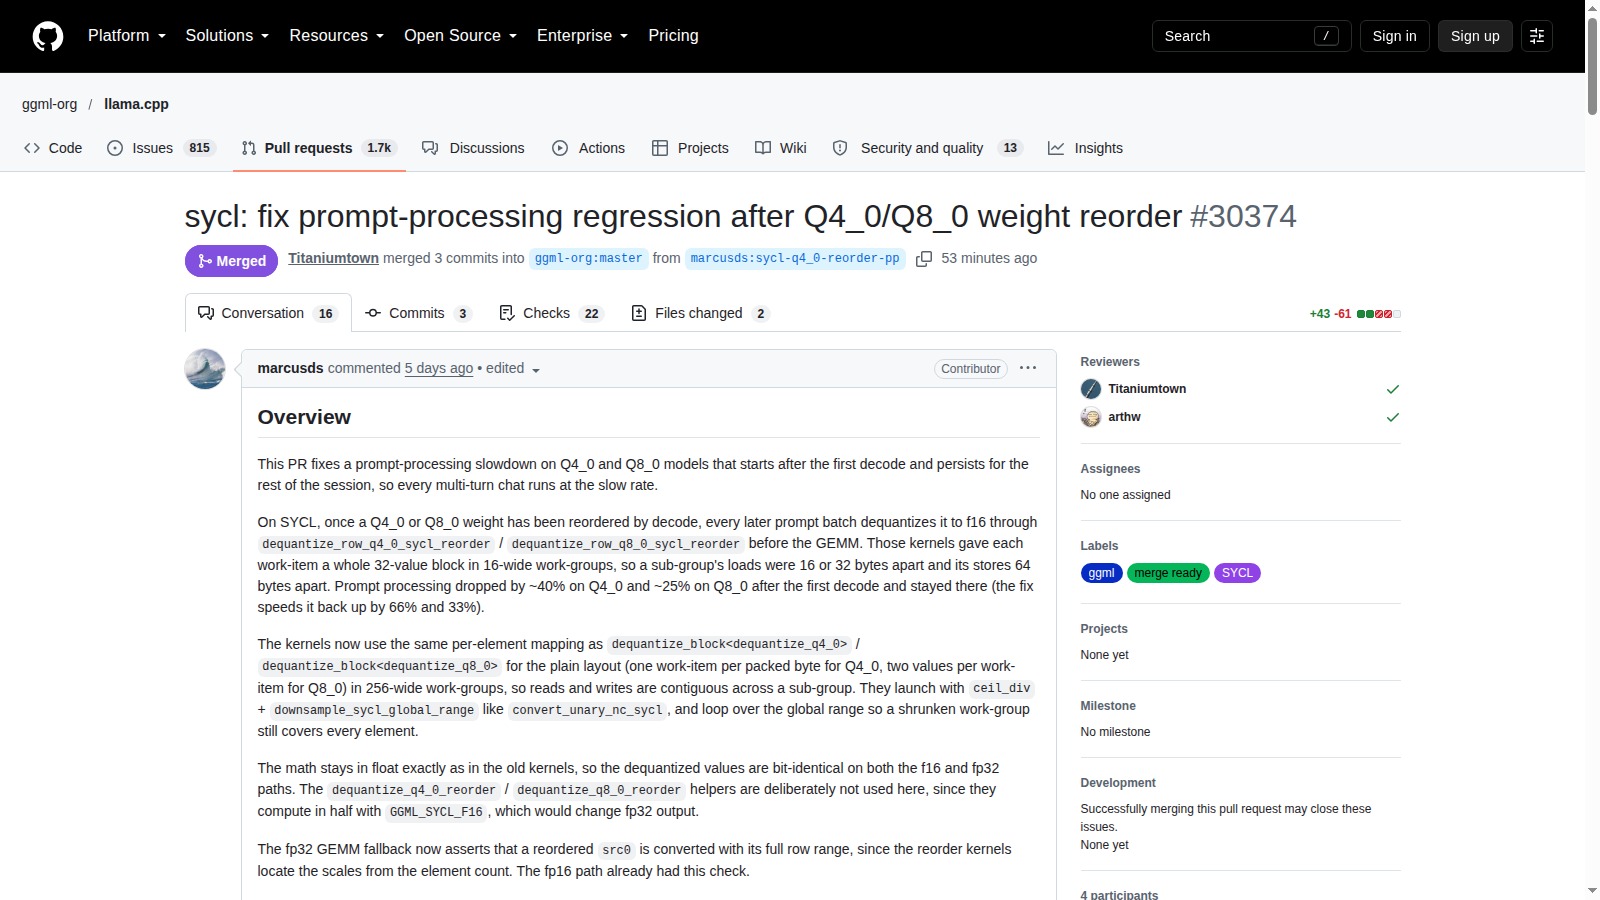
La prerelease b11706 corregge una regressione del backend SYCL che rallentava tutti i prompt successivi al primo decode nei modelli Q4_0 e Q8_0. Nei test del contributore su Intel Arc Pro B50, il prompt processing Q4_0 passa da 607 a 1005 token al secondo dopo il riordino dei pesi, mentre Q8_0 passa da 3117 a 4161; la generazione resta invariata e i controlli di correttezza producono risultati identici.
Limiti da conoscere
Limite: Le misure provengono dal contributore e coprono Intel Arc Pro B50 e UHD 730 con specifici modelli Qwen3.5, non ogni GPU SYCL o quantizzazione. b11706 è una prerelease: prima di aggiornare un servizio stabile vanno ripetuti benchmark, test multi-turno e controlli di output sul proprio hardware.
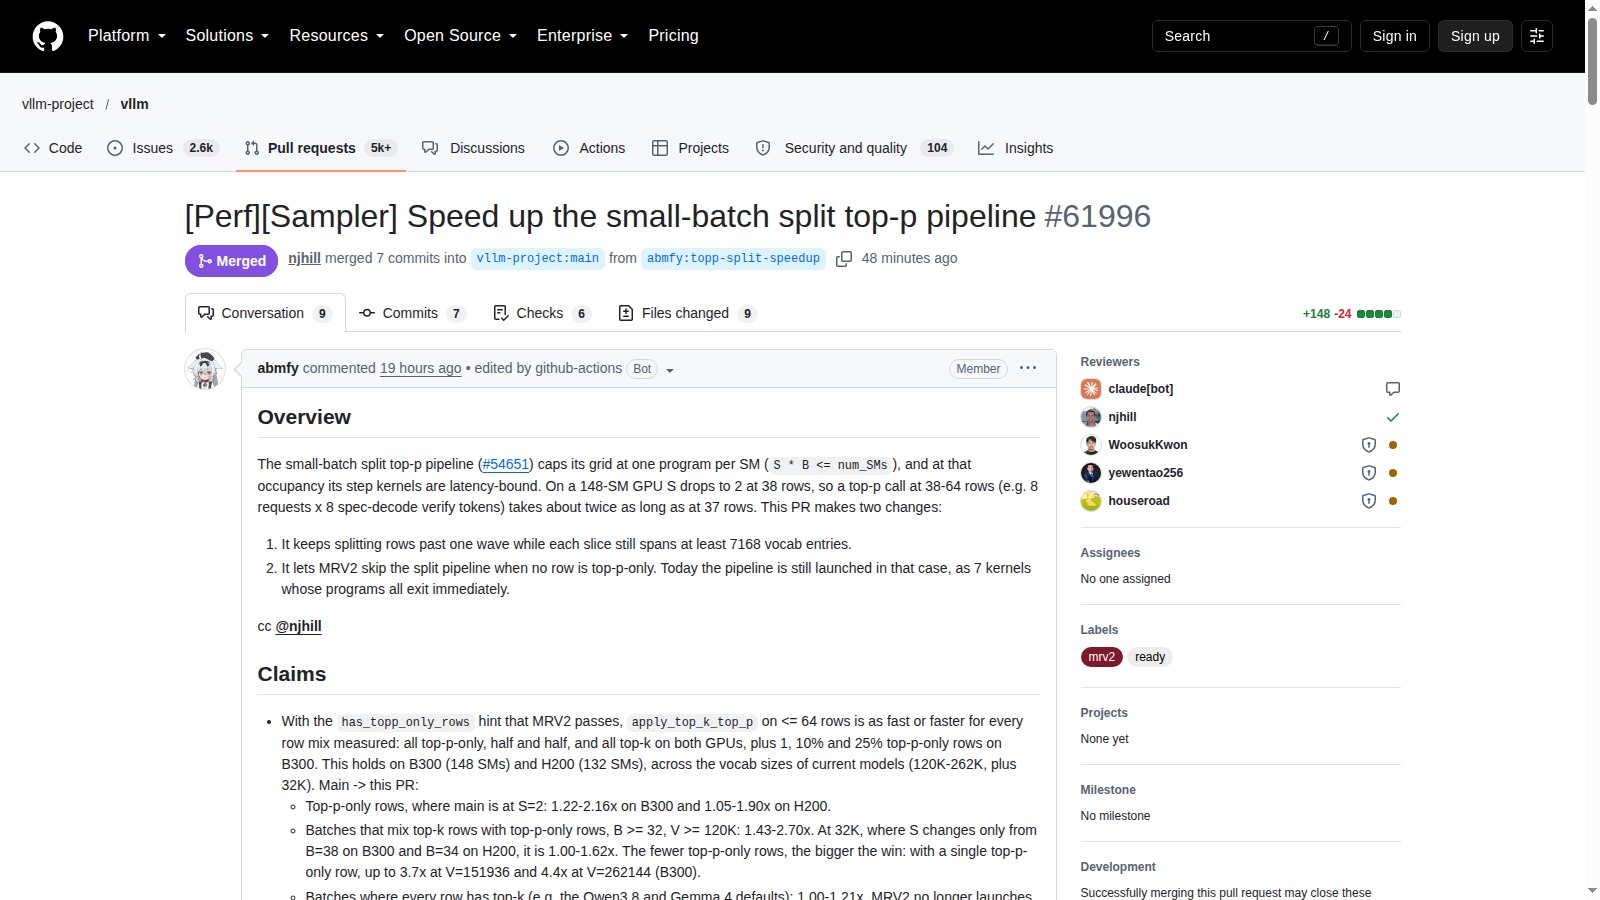
Il commit 7b6310c1 modifica la pipeline split top-p di vLLM per mantenere più parallelismo nei batch fino a 64 righe e saltare il percorso split quando tutte le righe usano top-k. Nei benchmark pubblicati dal contributore, i batch misti da almeno 32 righe e vocabolari da almeno 120K accelerano da 1,43 a 2,70 volte; sul caso MiMo-V2.6 con 38 righe il solo top-p scende da 561 a 219 microsecondi.
Limiti da conoscere
Limite: Il cambiamento è appena confluito nel ramo main e non appartiene ancora a una release stabile. Le misure provengono dal contributore su NVIDIA B300 e H200, con configurazioni specifiche di vocabolario, batch e sampling: il guadagno end-to-end pubblicato è più contenuto del microbenchmark e va misurato sul proprio modello.
Nel rapporto pubblicato il 16 ottobre, Anthropic presenta il primo quadro interno dettagliato dell’impatto degli agenti sul proprio lavoro: ad agosto le ore degli agenti interattivi risultavano sei volte quelle dei dipendenti, mentre la quota di junior tra le nuove assunzioni tecniche è scesa dal 27% al 9%. Il rapporto propone segnali misurabili su output, supervisione, attese per input umano e composizione dei ruoli, senza equiparare più codice a maggiore valore.
Limiti da conoscere
Limite: È un caso aziendale estremo, auto-riferito e prodotto dalla stessa organizzazione che sviluppa Claude. Le ore agentiche misurano runtime, inferenza e uso attivo degli strumenti, non ore umane equivalenti; l’aumento di codice non dimostra da solo migliore qualità o impatto e i risultati non sono generalizzabili automaticamente ad altre aziende.
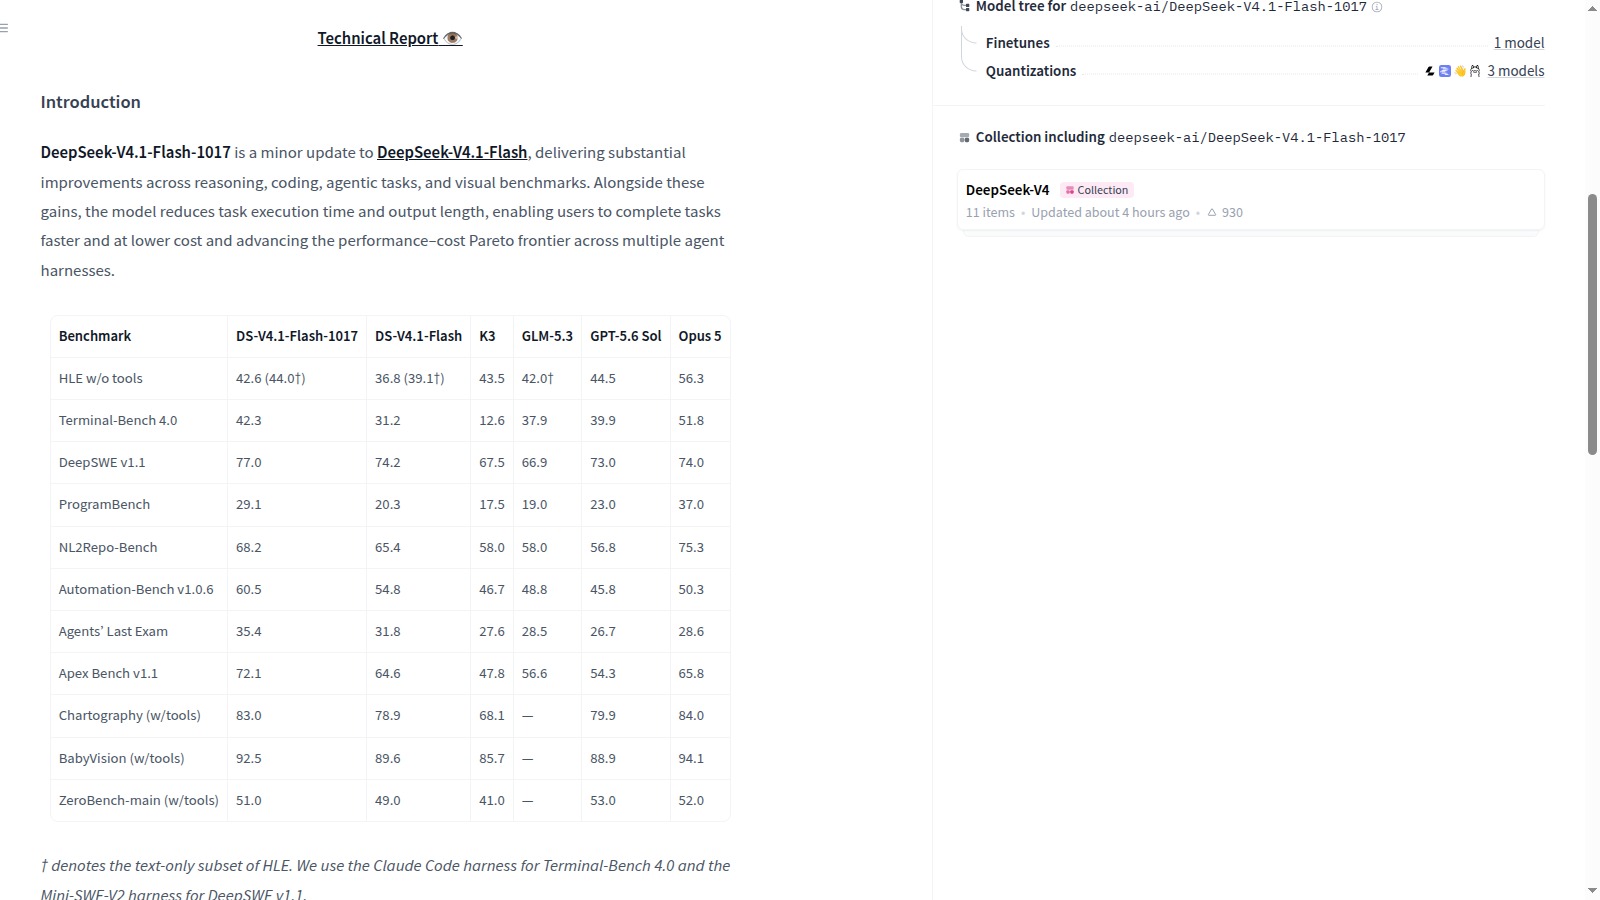
Il 17 ottobre DeepSeek ha aggiornato web, app e API a DeepSeek-V4.1-Flash-1017, mantenendo l’alias API deepseek-flash e il prezzo del modello. I pesi sono disponibili con licenza MIT e contesto raccomandato fino a un milione di token. Nello stesso rilascio, Search restituisce fino a 50 risultati web strutturati e Fetch recupera una pagina in Markdown, ciascuna API a 0,75 dollari ogni 1.000 richieste riuscite.
Limiti da conoscere
Limite: I miglioramenti di reasoning, coding, attività agentiche, velocità e lunghezza dell’output sono benchmark e misure dichiarati da DeepSeek, non una prova indipendente sul workflow reale. Il checkpoint completo è molto grande, il supporto nei runtime e nelle quantizzazioni locali va verificato e Search/Fetch non garantiscono da sole qualità, copertura o attendibilità delle fonti restituite.
La build b11709 del 17 ottobre aggiunge a llama.cpp il supporto nativo per Kolibri-1 e pubblica binari per CPU, CUDA, ROCm, Vulkan, OpenVINO, SYCL, Snapdragon e altre piattaforme. Il contributo documenta la conversione del checkpoint in un GGUF BF16 da 156 GiB e in un Q4_K_M da 45 GiB, trasformando il modello già rilasciato in un candidato concretamente testabile nell’ecosistema GGUF.
Limiti da conoscere
Limite: Il test riportato dal contributore usa quattro A800 e non dimostra caricamento, velocità o qualità sull’hardware di Francesco. Il Q4_K_M da 45 GiB resta grande, una quantizzazione non elimina il costo dei pesi residenti e i benchmark del model card non sono stati riprodotti in questo run.
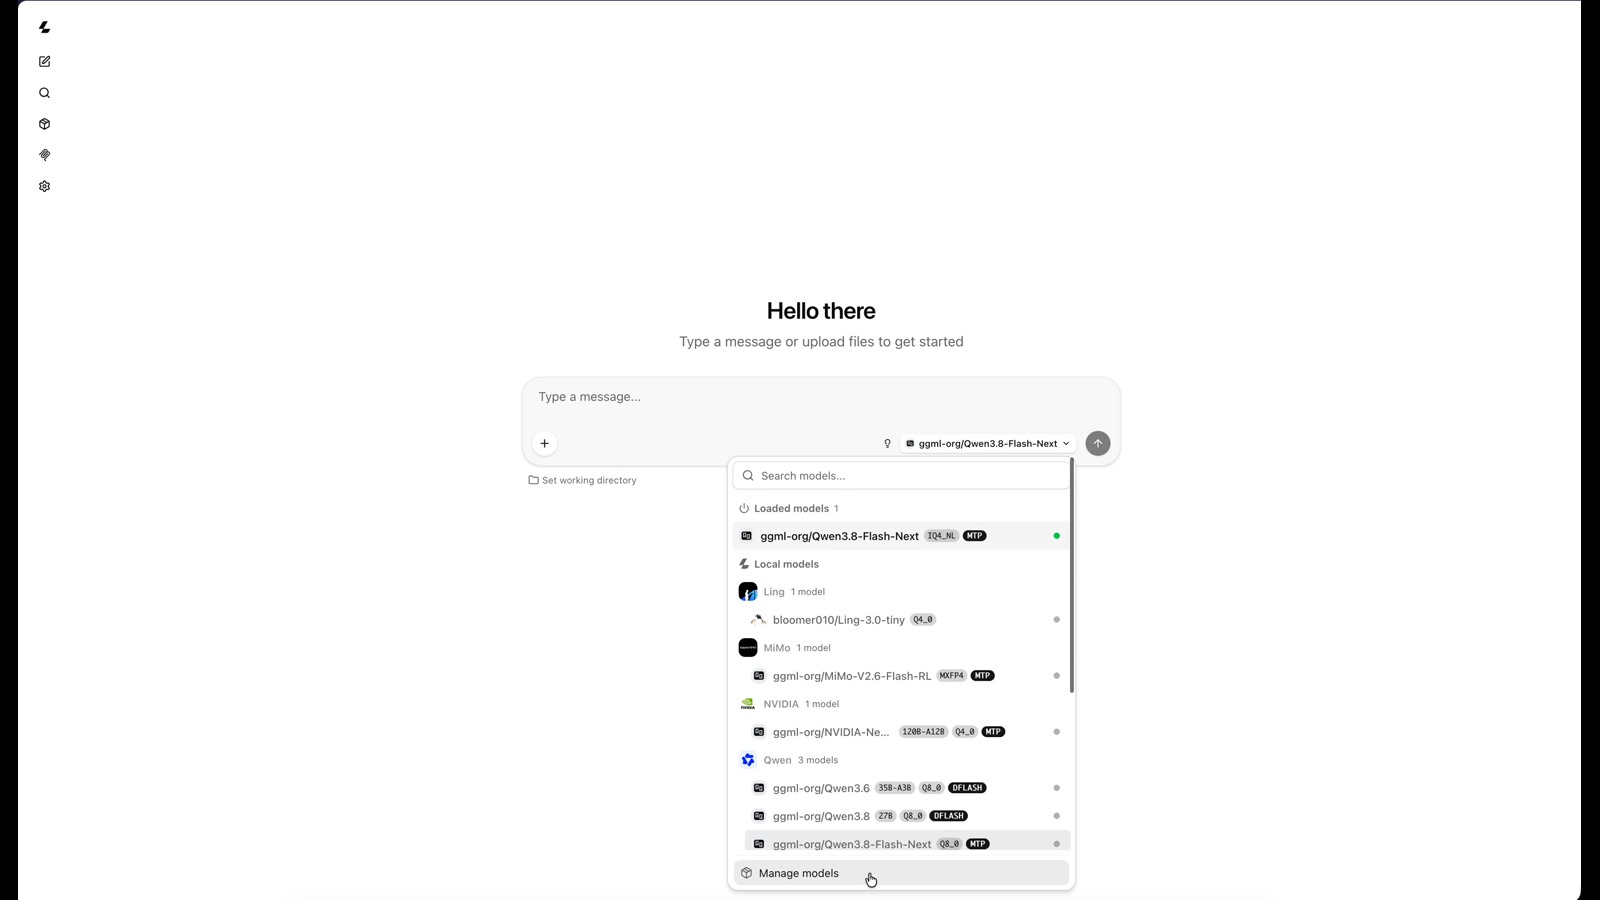
La build b11714 aggiunge alla UI di llama.cpp una vista opzionale per cercare modelli GGUF su Hugging Face, filtrare per dimensione e scegliere la quantizzazione con indicazioni di memoria. Il download può includere il draft sidecar compatibile, conserva i file parziali per la ripresa e ricorda le operazioni incompiute dopo un riavvio.
Limiti da conoscere
Limite: Discover Models è disattivato per impostazione predefinita e richiede accesso a Hugging Face. La UI semplifica acquisizione e ripresa dei file, ma non verifica qualità, licenza, provenienza o compatibilità hardware di ogni repository; dimensioni e note di memoria restano stime da controllare prima dell’esecuzione.
La patch stabile 1.103.5 corregge due regressioni nel percorso che converte risposte della Responses API nel formato Chat Completions. Testo, reasoning, citazioni e chiamate agli strumenti vengono ricomposti in `choices[0]`; quando il modello invoca più strumenti, gli indici tornano distinti invece di essere tutti zero.
Limiti da conoscere
Limite: La correzione riguarda il bridge non-streaming e soprattutto i client che leggono solo `choices[0]` o associano i risultati tramite l’indice della tool call. Il pull request di backport dichiara test unitari completati, ma segnala che la prova live contro un proxy stabile e un deployment reale non era ancora stata eseguita; prima dell’upgrade servono quindi test di compatibilità sul proprio harness.
OpenCode ha dichiarato una violazione di sicurezza collegata a un attacco di distillazione su larga scala, con impatto indicato sull’1,4% degli utenti Console. Gli utenti coinvolti sono stati avvisati via email; mentre l’incidente resta aperto, chi ha ricevuto la notifica deve trattare le credenziali collegate al workspace come potenzialmente esposte e ruotarle dai provider originari.
Limiti da conoscere
Limite: La comunicazione pubblica non specifica ancora quali dati o credenziali siano stati consultati, quale attore abbia condotto l’attacco, la finestra completa né le misure definitive di contenimento. Il valore 1,4% riguarda gli utenti OpenCode Console, non tutti gli utenti del client open source; la rotazione è una precauzione operativa, non la prova che ogni chiave collegata sia stata sottratta.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.