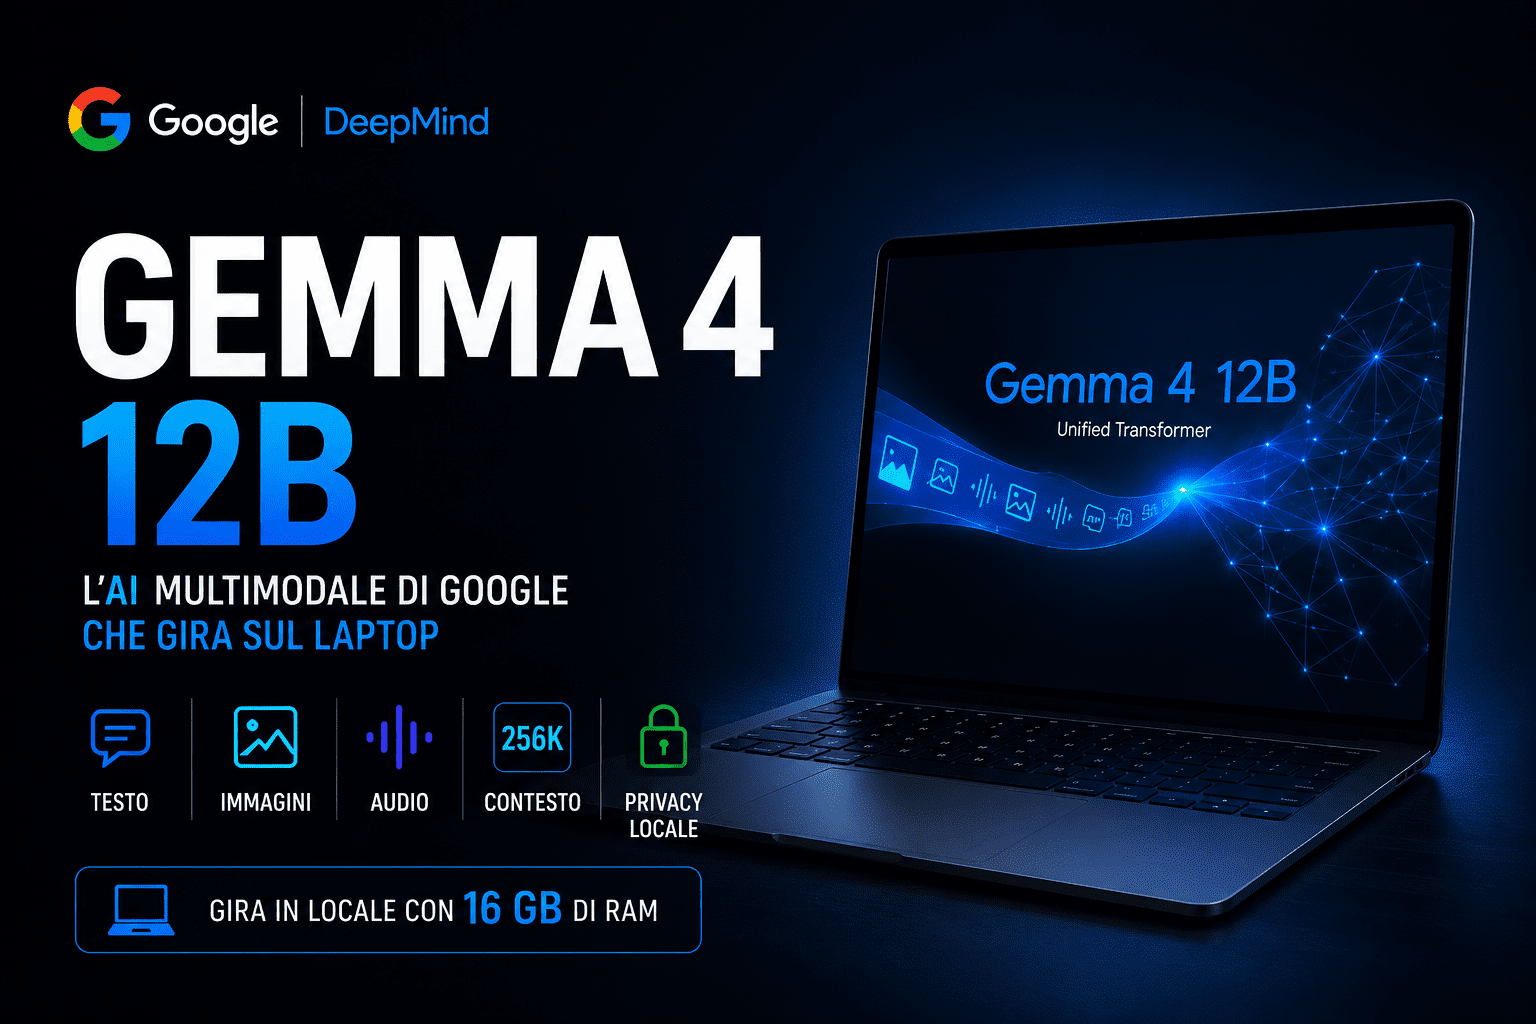
Gemma 4 12B è il modello “di mezzo” della famiglia Gemma 4 per chi vuole lavorare in locale su un laptop: accetta testo, immagini e audio, genera testo, usa un’architettura unificata senza encoder multimodali separati e offre una finestra di contesto da 256K token. Google lo distribuisce con licenza Apache 2.0 e lo indica per laptop, desktop e piccoli server.
ollama run gemma4:12b. Il tag è pubblicato nella libreria ufficiale Ollama. Prima del download controlla però lo spazio del file e la memoria disponibile: il fabbisogno reale cambia con runtime, precisione, contesto e altri processi. Questa guida non presenta benchmark o test hardware proprietari.Cos’è Gemma 4 12B e perché è diverso
Gemma 4 12B Unified è stato aggiunto alla famiglia il 3 giugno 2026. È un modello denso da circa 12 miliardi di parametri e usa un singolo transformer decoder-only: immagini e audio vengono proiettati direttamente nello spazio del modello invece di passare da encoder multimodali separati.
Il risultato pratico non è “un modello che fa tutto”, ma un’unica base per tre tipi di input. Puoi usarlo per chat e riassunti, analisi di immagini, OCR, trascrizione e traduzione del parlato. L’output resta testuale. Google documenta inoltre function calling, system prompt e modalità di reasoning configurabile.
Gemma 4: quale variante scegliere
Questa tabella usa solo proprietà dichiarate nella model card Google. Non trasforma i parametri in una promessa di velocità o qualità sul tuo computer. Per i dispositivi più piccoli, leggi anche la mia guida a Gemma 3n in locale: è una generazione diversa e non va confusa con Gemma 4.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Come eseguire Gemma 4 12B con Ollama
Ollama è il percorso più diretto perché gestisce download, formato e chat template. Installa il runtime dalla pagina ufficiale, poi verifica che il comando sia disponibile.
ollama --version
ollama pull gemma4:12b
ollama run gemma4:12b
Il comando esplicito ollama run gemma4:12b è pubblicato nella pagina ufficiale Ollama dedicata al tag 12B.
Per controllare cosa hai installato usa ollama list. Se vuoi inviare testo via API locale, Ollama espone il servizio sulla macchina; parti dalla documentazione ufficiale prima di collegarlo a un’app. Se stai valutando anche un servizio remoto, la mia guida a Ollama Cloud copre un intento diverso: lì l’inferenza non resta sul tuo hardware.
RAM, VRAM e quantizzazione: cosa è verificato
La documentazione tecnica Google stima, per il solo caricamento dei pesi con il 20% di overhead, 26,7 GB in BF16, 13,4 GB in SFP8 e 6,7 GB in Q4_0.
Non sono numeri intercambiabili. La tabella tecnica esclude memoria aggiuntiva per software e context window; il KV cache cresce con prompt e risposta. Per questo non prometto che una configurazione specifica “entra” né suggerisco una quantizzazione come scelta universale. Controlla il formato distribuito dal runtime, riduci il contesto se necessario e misura sulla macchina reale.
Cosa testare prima di usarlo davvero
- Italiano: prepara prompt rappresentativi del tuo lavoro e valuta accuratezza, tono e formati.
- Multimodalità: separa test di testo, immagine e audio; non dedurre il supporto del client dal supporto del modello.
- Contesto: aumenta la lunghezza gradualmente e osserva memoria e stabilità.
- Tool calling: valida schema e gestione degli errori prima di affidargli azioni.
- Privacy: conferma che modello, interfaccia e integrazioni usate restino locali; “modello locale” non rende automaticamente locale l’intera pipeline.
Per la panoramica generale della generazione, mantengo separato l’articolo Gemma 4: famiglia, architetture e scenari locali. Questa pagina resta invece il riferimento operativo sul 12B, così le due URL non devono competere sullo stesso intento.
Domande frequenti e fonti
Gemma 4 12B è open source?
È più preciso definirlo un modello open-weight. La model card ufficiale indica licenza Apache 2.0 e disponibilità dei pesi in varianti pre-trained e instruction-tuned.
Qual è il comando Ollama per Gemma 4 12B?
Il tag esplicito pubblicato da Ollama è ollama run gemma4:12b.
Gemma 4 12B accetta audio?
Sì. Google documenta input di testo, immagini e audio per E2B, E4B e 12B; l’output è testuale. Il supporto concreto dipende anche dal runtime o client usato.
Quale variante Gemma 4 scegliere per uso locale?
E2B ed E4B sono orientati a mobile ed edge; 12B a laptop e piccoli server; 26B A4B e 31B a sistemi più grandi. La scelta finale richiede un test sul proprio task e hardware.
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.