Ho usato 29 esecuzioni di subagenti dentro Hermes Agent per auditare, correggere e verificare francescogruner.it. Non erano 29 “dipendenti AI” diversi e permanenti: erano 29 incarichi separati, eseguiti in fasi diverse sullo stesso sistema. Il risultato più utile non è stato vedere gli agenti scrivere codice. È stato scoprire quante modifiche potevano superare un test tecnico e fallire comunque nel sito reale.
Un form poteva inviare correttamente un indirizzo a Brevo, ma senza un consenso marketing esplicito e verificabile. Una pagina Radar poteva avere contenuto e markup validi, ma mostrare due H1. Una sitemap poteva rispondere con HTTP 200 e restare incompleta. Un refresh editoriale poteva aggiornare titolo e testo lasciando descrizioni o riassunti AI non più coerenti. E una correzione perfetta su desktop poteva introdurre overflow o controlli scomodi a 390 pixel.
29 esecuzioni, non 29 agenti “assunti”
La distinzione conta. In questo lavoro “subagente” indica un’esecuzione delegata con uno scopo, un set di artefatti e un criterio di uscita. Lo stesso modello o lo stesso tipo di agente può essere avviato più volte. Non sto quindi sostenendo di avere creato una squadra di 29 identità autonome e persistenti.
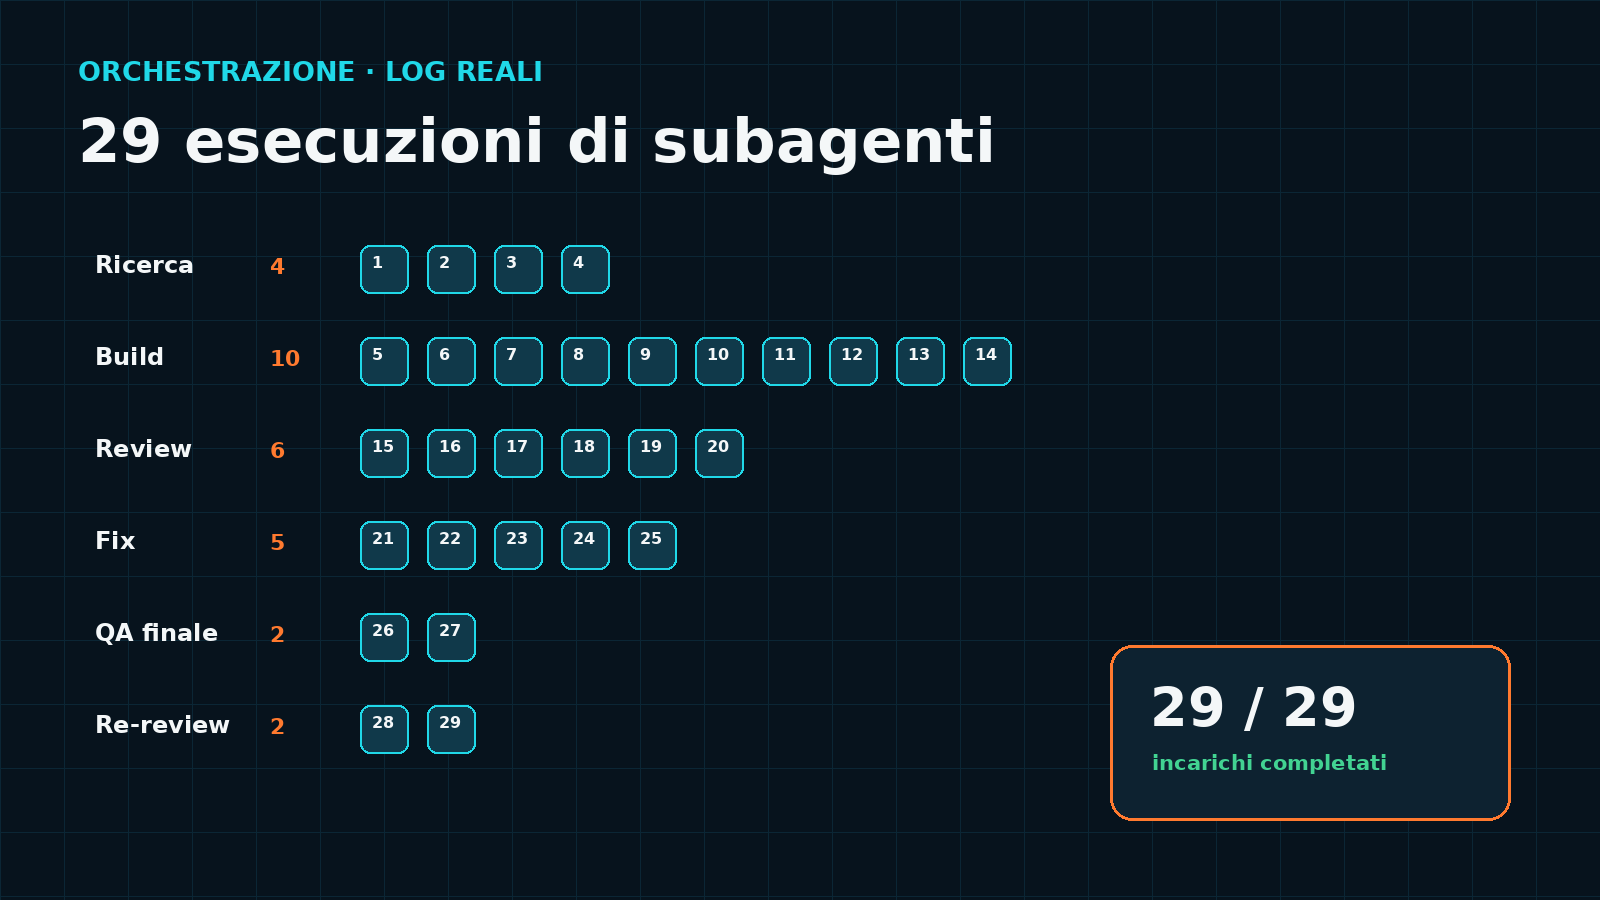
La somma è 4 + 10 + 6 + 5 + 2 + 2 = 29. Il numero descrive il processo, non il numero di personalità artificiali coinvolte.
Il punto di partenza: misurare prima di aggiungere
L’audit iniziale ha incrociato GA4, Search Console, statistiche aggregate Brevo, crawl pubblico e rendering dei template principali. Il crawl comprendeva 135 pagine sorgente e 700 destinazioni interne HTTPS uniche; il controllo sitemap rilevava 130 URL dichiarate. Le rotte Radar osservate erano indicizzabili, ma non comparivano nelle sitemap.
I dati non autorizzavano una storia trionfale. Nei 28 giorni analizzati le sessioni erano diminuite del 15,9% e gli utenti attivi del 22,1%, mentre le visualizzazioni erano aumentate del 48,3%. Alcune pagine Radar mostravano molte visualizzazioni attribuite a pochissimi utenti: un segnale compatibile anche con attività interna o automatizzata. Prima di ottimizzare le conversioni serviva quindi rendere attendibile la misura.
Il principio operativo è semplice: se il dato non distingue un lettore da un’automazione, o un invio del form da una conferma reale del provider, non è ancora una conversione.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Il form funzionava. Il confine di consenso no.
La parte più delicata riguardava la newsletter. La catena proposta era newsletter_view → newsletter_start → submit_success → provider_confirmed. Ma il candidato di misurazione ha fatto emergere un problema che un test “la richiesta HTTP va a buon fine” non avrebbe intercettato: i form acquisiti dal sito non contenevano un controllo di consenso marketing esplicito e selezionabile dall’utente.
Per questo l’integrazione è stata progettata per fallire in modo chiuso: accetta solo nomi e valori di consenso dichiarati, non deduce il consenso da una frase vicina al pulsante e non usa una casella preselezionata. Inoltre separa il consenso all’iscrizione dal consenso analytics. Senza consenso analytics, l’iscrizione può restare funzionale, ma gli eventi GA4 non devono partire.
Il rischio non era solo legale o reputazionale. Un endpoint di iscrizione pubblico senza protezioni adeguate può essere abusato per iscrivere indirizzi di terzi, sporcare la lista o generare traffico artificiale. La proposta includeva token HMAC a breve durata legato a cookie HttpOnly, honeypot, esclusione di bot e percorsi interni, rate limit e verifica lato server. Il nono tentativo in dieci minuti dallo stesso IP doveva ricevere 429.
Questo è un buon esempio di “test passato, realtà fallita”: ricevere un 200 non basta. Bisogna verificare consenso, abuso, stato nel provider, privacy dei log e corrispondenza dei conteggi.
Doppio H1, schema vecchio e sitemap vuota: tre livelli diversi
Radar AI aveva difetti che sembravano simili, ma appartenevano a livelli diversi. Una deep page mostrava due H1 perché il contenuto personalizzato e l’intestazione nativa del tema restavano entrambi idonei al rendering. La pagina giornaliera mostrava sei storie, mentre il suo ItemList ne dichiarava quattro e conservava la data del 31 agosto. La weekly mostrava correttamente 18 storie, ma lo schema ne dichiarava otto.
Infine, page-sitemap.xml non includeva alcuna rotta /radar-ai/. Il fatto che una sitemap risponda con successo non dimostra che contenga ciò che deve contenere. Dopo gli interventi, la verifica pubblica ha registrato una sola H1 nelle pagine controllate, sei storie coerenti con lo schema giornaliero, tutte le 18 storie nella weekly e la presenza di tutte le sei pagine profonde collegate dall’edizione del 2 settembre nella sitemap Radar dedicata.
La lezione è separare almeno quattro domande: la pagina risponde? Il DOM è corretto? I dati strutturati descrivono davvero ciò che vede il lettore? La sitemap include l’inventario pubblicato e indicizzabile?
I riassunti AI diventano debito editoriale
Nei refresh SEO, cambiare il corpo dell’articolo senza controllare titolo, excerpt, meta description e riassunti generati crea versioni parallele della stessa pagina. Il caso più evidente era una descrizione di Claude Opus 5 che prometteva universalmente un costo per task dimezzato: la revisione indipendente l’ha rimossa perché il claim non reggeva come affermazione generale.
Altri controlli hanno eliminato dettagli non confermati, ristretto stime RAM/VRAM prive di modello, quantizzazione e contesto, e distinto fonti del produttore da prove dell’autore. Il problema non è usare l’AI per riassumere. È trattare quel riassunto come un campo “scrivi una volta e dimentica”. Ogni modifica sostanziale dovrebbe invalidare anche snippet, excerpt e summary derivati.
Il mobile non è una riduzione del desktop
Il render mobile a 390 × 844 ha mostrato un sito con troppe scelte prima del contenuto: form ripetuti, strumenti, ricerca, voto, archivio e call to action. In home erano presenti cinque form newsletter nel DOM, tre visibili; su Radar tre form newsletter più la ricerca. La home arrivava a circa 12.634 pixel di altezza su mobile.
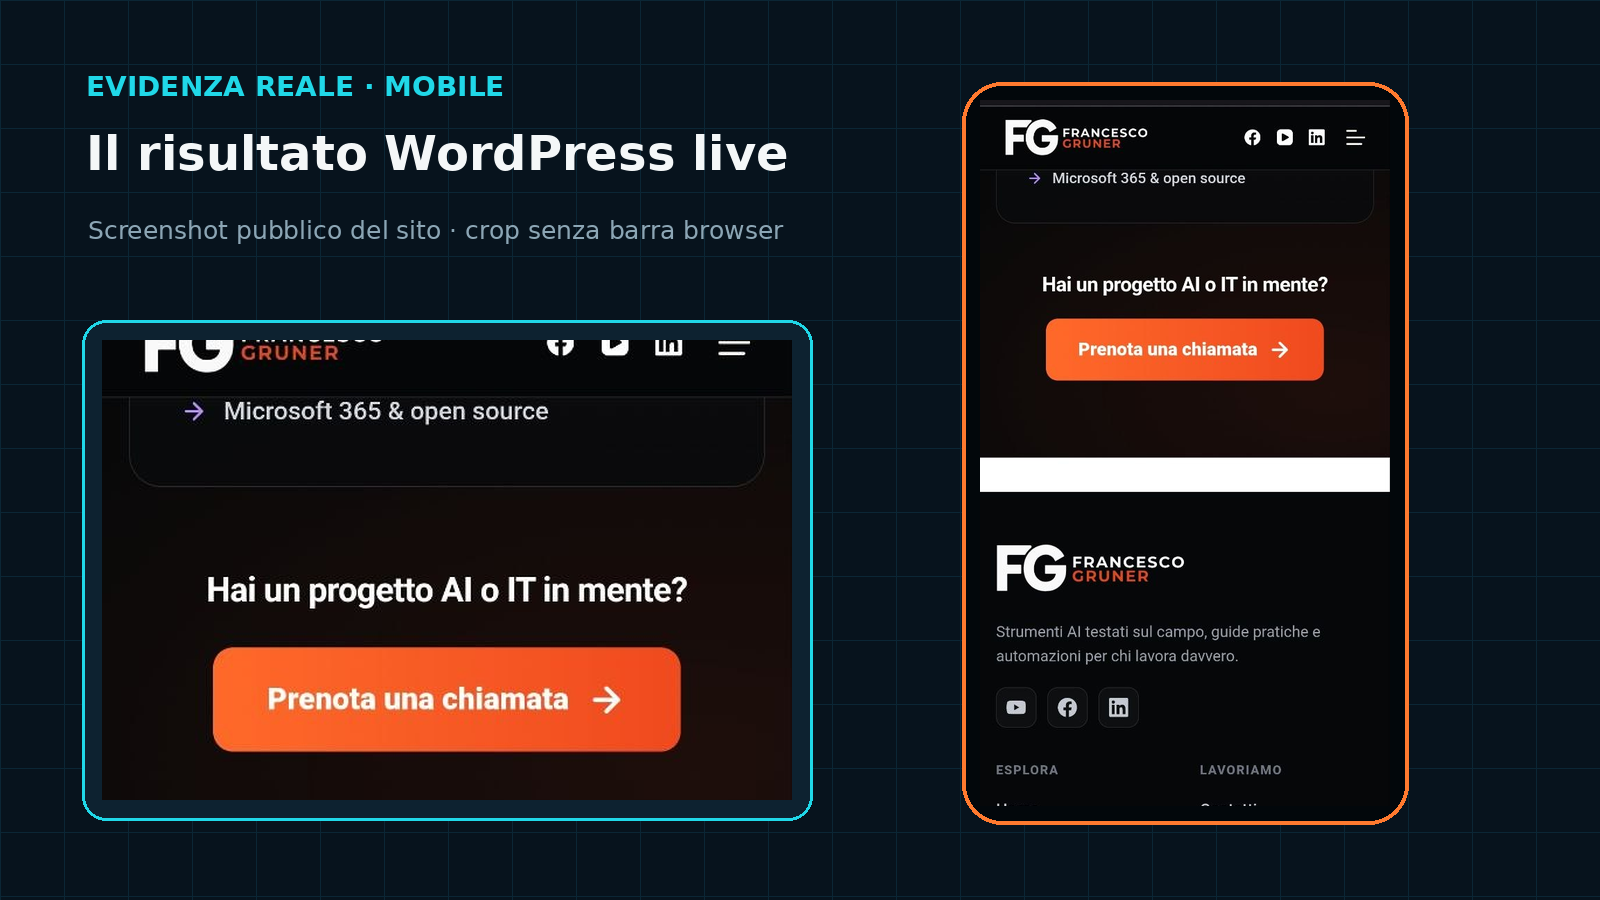
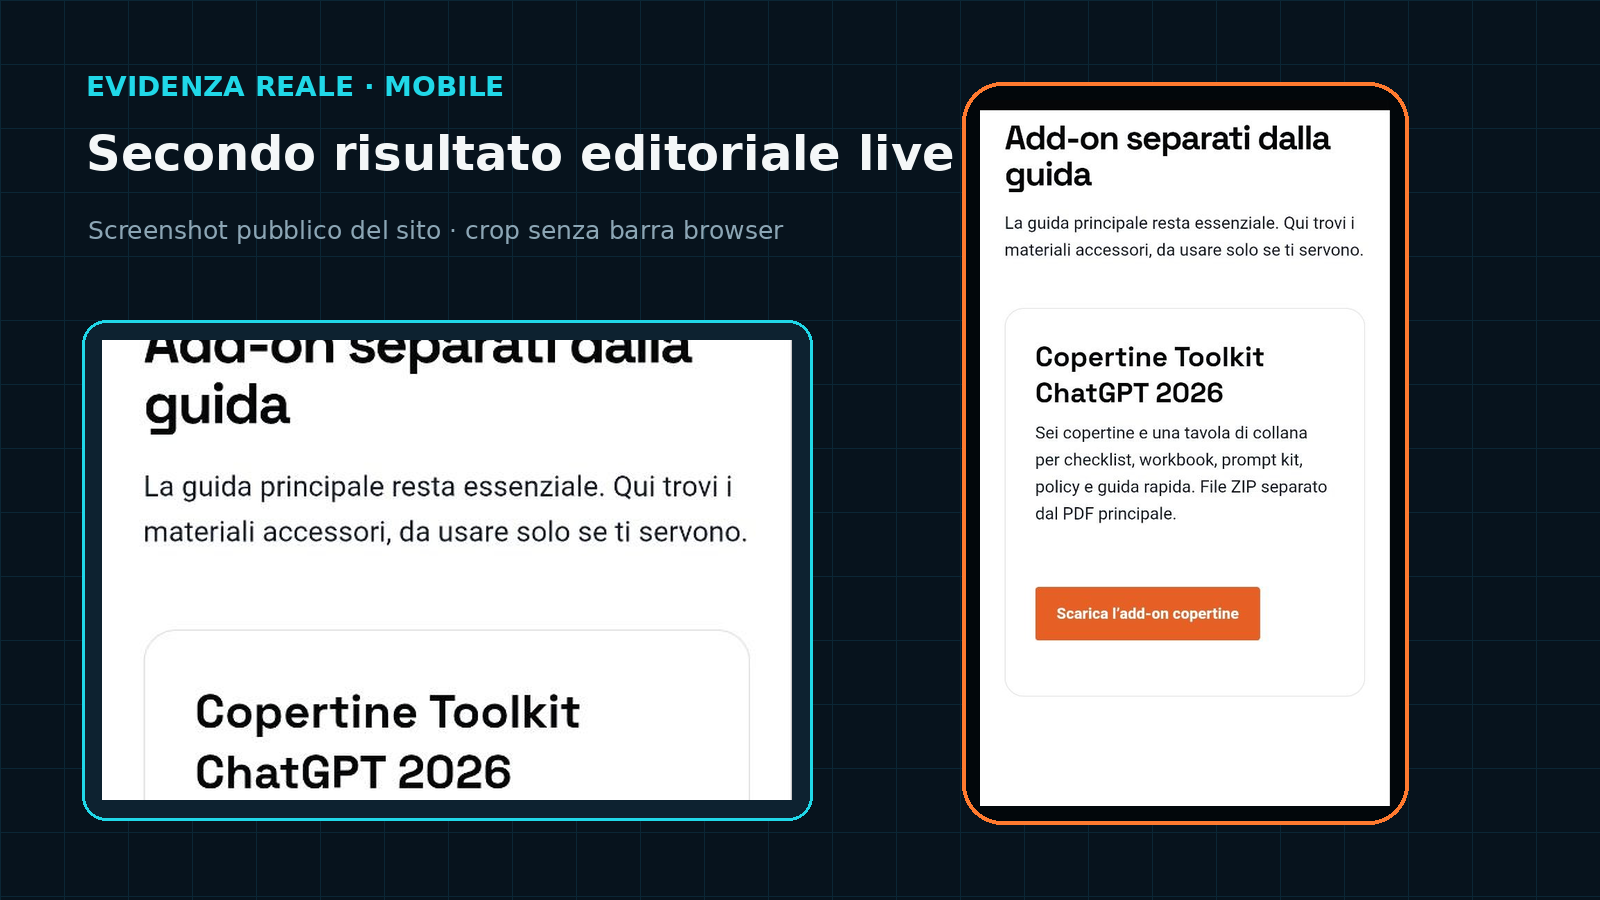
La correzione non è stata “nascondi tutto con CSS”. Nel controllo pubblico finale ogni pagina campionata mostrava una sola iscrizione visibile e nessun overflow documentale a 390 pixel; i controlli principali sono stati portati ad almeno 44 pixel. Per confronti e dati ho evitato tabelle orizzontali: su telefono le card semantiche sono più robuste e non intrappolano il gesto verticale.
Orchestratore, revisore e correttore non devono coincidere
La separazione dei ruoli è stata più importante del numero di esecuzioni.
- L’orchestratore divide il lavoro, assegna confini, conserva la baseline e decide l’ordine delle dipendenze. Non dovrebbe approvare una modifica solo perché un subagente dichiara “pass”.
- L’implementatore produce una modifica circoscritta, test, backup e rollback. Deve evitare di toccare campi o pagine fuori ambito.
- Il revisore indipendente parte dall’ipotesi che qualcosa sia sbagliato. Confronta intento, artefatto, stato autenticato e comportamento pubblico.
- Il correttore riceve difetti specifici, non un generico “migliora”. Corregge senza riaprire tutto il perimetro.
- Il verificatore finale legge il risultato pubblico. Un payload corretto o una risposta API 200 non sono la conclusione.
Questa struttura riduce due errori frequenti nei workflow agentici: l’autovalutazione indulgente e la deriva di perimetro.
La verifica che ha fatto la differenza: il readback pubblico
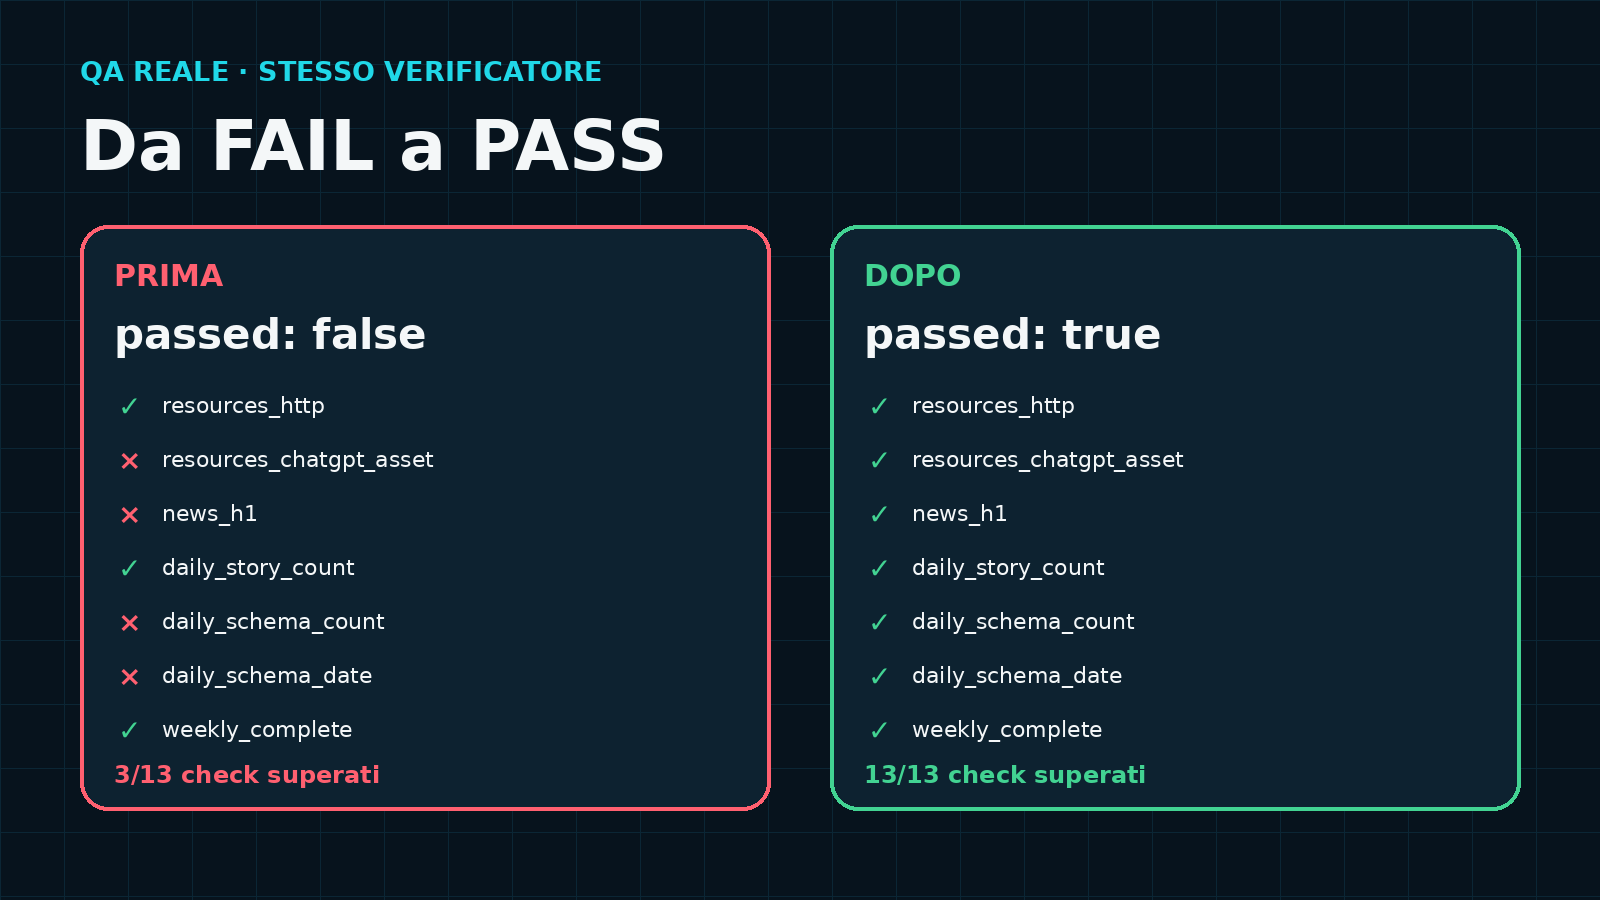
La baseline automatizzata falliva su link alla risorsa ChatGPT, H1 di News, schema giornaliero, data obsoleta, doppio H1, URL contatti e sitemap Radar. Una verifica intermedia mostrava ancora il doppio H1, i link non canonici e la sitemap senza rotte Radar. Solo la verifica finale pubblica ha restituito tutti i controlli verdi.
Questo passaggio evita una confusione pericolosa: “la mutazione è riuscita” non significa “il sito è corretto”. Cache, tema, hook globali, dati strutturati e plugin SEO possono trasformare il risultato dopo il salvataggio. Servono almeno tre letture: backup precedente, readback autenticato dell’oggetto modificato e pagina pubblica renderizzata.
Checklist riutilizzabile per lavori agentici su WordPress
- Definisci il confine: URL, ID WordPress, campi modificabili, campi da preservare e azioni vietate.
- Acquisisci una baseline: contenuto autenticato, HTML pubblico, sitemap, schema, screenshot desktop/mobile e misure rilevanti.
- Separa diagnosi e modifica: il primo agente produce evidenza; il secondo prepara il candidato.
- Richiedi un rollback reale: non “possiamo tornare indietro”, ma file, ID e procedura esatta.
- Controlla il consenso: checkbox esplicita, non preselezionata, validazione server-side e separazione fra marketing e analytics.
- Prova l’abuso: indirizzo non valido, honeypot, bot, rate limit, endpoint interni e assenza di PII nei log.
- Proteggi ciò che funziona: immagini, link interni, codice, FAQ, media, slug, data, status, categoria e commenti Gutenberg.
- Verifica la semantica: una H1 utile, gerarchia heading, canonical, JSON-LD coerente con il DOM.
- Verifica la discovery: URL pubblicate e indicizzabili presenti nella sitemap corretta.
- Invalida i derivati: titolo SEO, description, excerpt e riassunti AI vanno ricontrollati dopo ogni refresh.
- Testa il mobile reale: 390 e 360 pixel, nessun overflow, scroll verticale, focus visibile e target da 44 pixel.
- Usa un revisore indipendente: deve poter bocciare il candidato senza dover salvare il lavoro dell’implementatore.
- Leggi il pubblico: controlla DOM, schema, link, sitemap, form e console dopo cache e rendering.
- Non inventare l’impatto: misura il post-intervento su una finestra completa; non promettere crescita da un test tecnico.
Cosa hanno migliorato davvero i 29 incarichi
Il risultato non è “29 agenti hanno rifatto il sito”. Gli interventi verificati hanno corretto difetti puntuali: una risorsa reale nella pagina Risorse, una H1 per News, coerenza fra contenuto e schema Radar, una sola H1 nelle deep page, sitemap Radar popolata, link contatti canonici e refresh SEO circoscritti senza distruggere media o struttura.
La parte newsletter ha mantenuto un confine importante: il codice di misura non è stato considerato sufficiente finché consenso esplicito e stato provider_confirmed non fossero verificabili sul flusso reale. Fermarsi davanti a un requisito non soddisfatto è una funzione del sistema, non un fallimento dell’automazione.
Se c’è una conclusione utile è questa: più agenti non compensano una verifica debole. Un workflow agentico diventa affidabile quando ogni ruolo lascia evidenza, qualcun altro prova a smentirla e il risultato viene riletto nel sistema reale.
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.