
L’ANALISI
Roboflow Inference 1.7.2: ispezione sicura dei workflow e nuovo piano RF-DETR
Analisi di Roboflow Inference 1.7.2: endpoint describe_workload, piano RF-DETR condiviso, metadati dei fallback, limiti e checklist per aggiornare un server locale.
In breve: La release permette di stimare requisiti e vincoli di un workflow senza eseguirne i blocchi e rende osservabile quale implementazione RF-DETR viene usata in ogni fase. È utile per scheduler, controlli preventivi e deployment locali, ma l’endpoint è ancora sperimentale e il guadagno prestazionale pubblicato va ripetuto sul proprio hardware.
Cosa descrive il nuovo endpoint
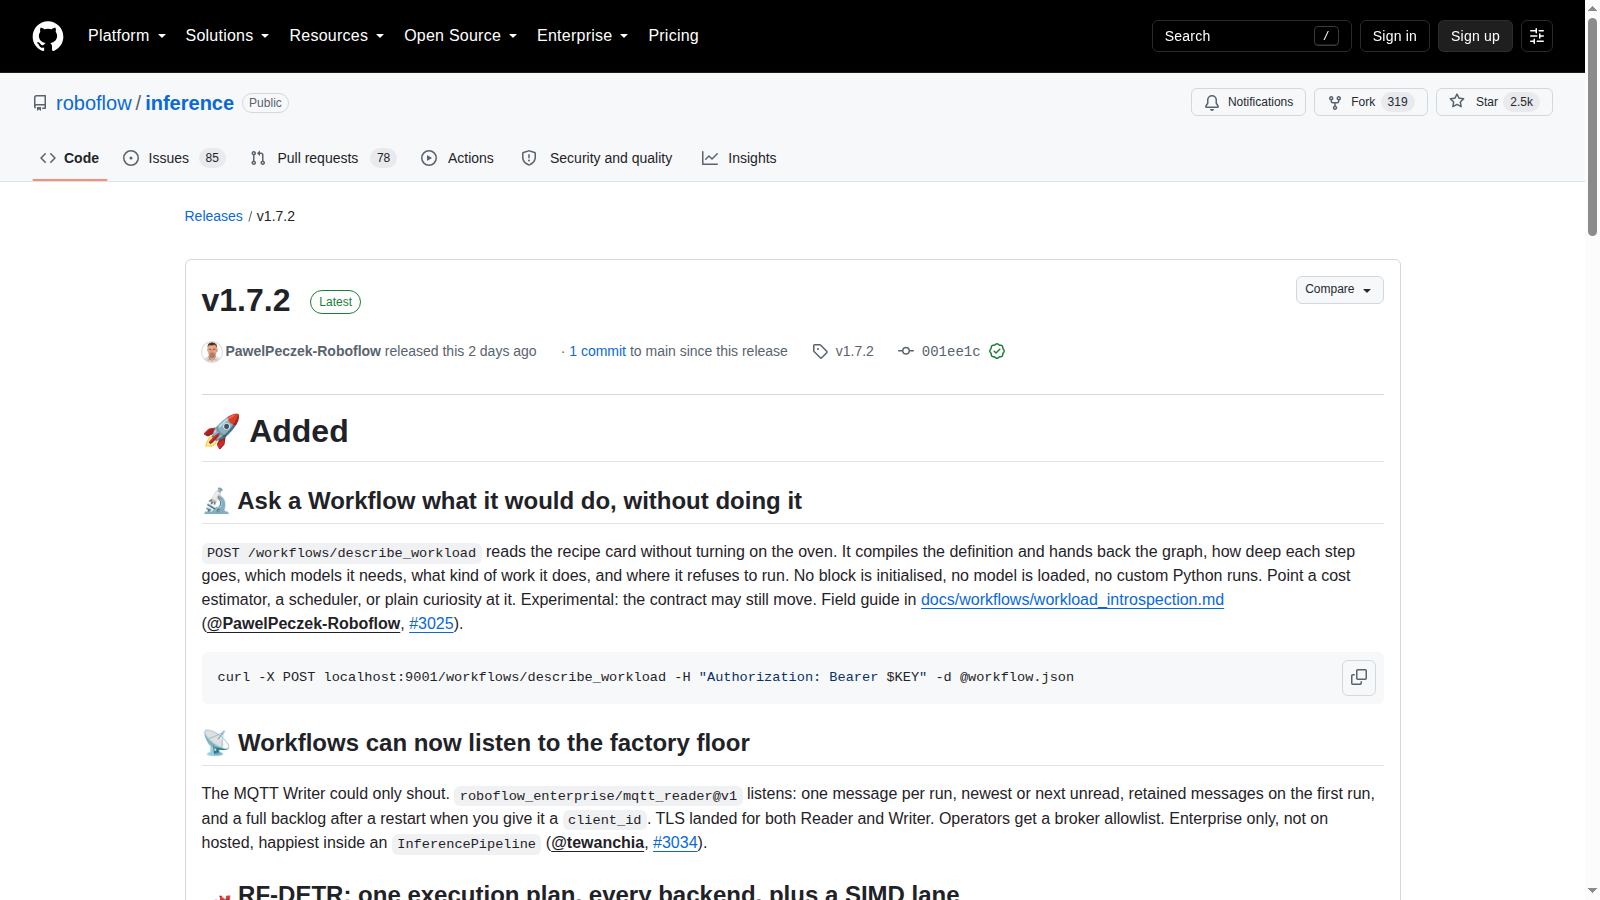
POST /workflows/describe_workload compila la definizione e restituisce struttura del grafo, profondità, modelli richiesti, tipo di carico e motivi di rifiuto. La release specifica che nessun blocco viene inizializzato, nessun modello viene caricato e il codice Python personalizzato non viene eseguito.
Perché è utile prima dell’esecuzione
Un controllo statico consente a scheduler e sistemi di costo di verificare il carico prima di assegnare GPU o avviare componenti potenzialmente costosi. Non è però una sandbox né una prova che il workflow finirà correttamente: dipendenze, dati reali e servizi esterni entrano in gioco soltanto durante l’esecuzione.
Cosa cambia nel percorso RF-DETR
Torch e ONNX adottano lo stesso piano a cinque fasi già usato da TensorRT. Il preprocessore pillow-simd-v1 è incluso nelle immagini CPU, GPU e CUDA 13; la modalità auto sceglie Triton su CUDA, SIMD altrove e conserva base come ripiego. Ogni modello espone optimization_runtime_metadata per mostrare implementazione e fallback effettivi.
Il dato prestazionale da leggere con cautela
Gli autori riportano su NVIDIA T4 e input 4K un passaggio da 101 a 31 ms per infer(). È un confronto utile per formulare un test, ma non dimostra lo stesso rapporto su schede diverse, batch differenti o pipeline che includono acquisizione, post-processing e rete.
Altri vincoli operativi della release
Il runtime limita a 8K i buffer di staging Triton. I workflow ricorsivi ora ricevono HTTP 400 e scattano limiti di profondità 4 e conteggio 32 prima del fetch. L’Execution Engine 1.16.0 tratta la versione richiesta come minimo e rifiuta in compilazione una versione più nuova di quella installata.
Condizioni e limiti
describe_workload è sperimentale. MQTT Reader è enterprise e non disponibile sul servizio hosted. Podman non copre tunnel e Jetson. Le immagini Docker restano su Python 3.11 o 3.12, mentre il pacchetto pip dichiara supporto a Python 3.13 con pybase64 compilato da sorgente.
Checklist di aggiornamento
- Bloccare immagine o pacchetto alla versione 1.7.2 e conservare la configurazione precedente.
- Inviare i workflow a describe_workload e archiviare grafo, modelli, vincoli e versione del motore.
- Confermare che il controllo non inizializzi blocchi né esegua Custom Python.
- Leggere optimization_runtime_metadata per verificare backend e fallback realmente scelti.
- Ripetere il benchmark RF-DETR con risoluzione, batch e hardware di produzione.
- Provare workflow ricorsivi e incompatibilità di versione aspettandosi un errore prima dell’esecuzione.
- Controllare autenticazione, TLS e esposizione di rete del server locale.
- Eseguire un rollback testato se output, latenza o consumo GPU peggiorano.