
L’ANALISI
CLM-8B classifica le azioni degli agenti senza generare testo
Analisi di CLM-8B, modello aperto di Stanford e NVIDIA Research per classificare azioni, scegliere tool e verificare traiettorie con embedding riutilizzabili.
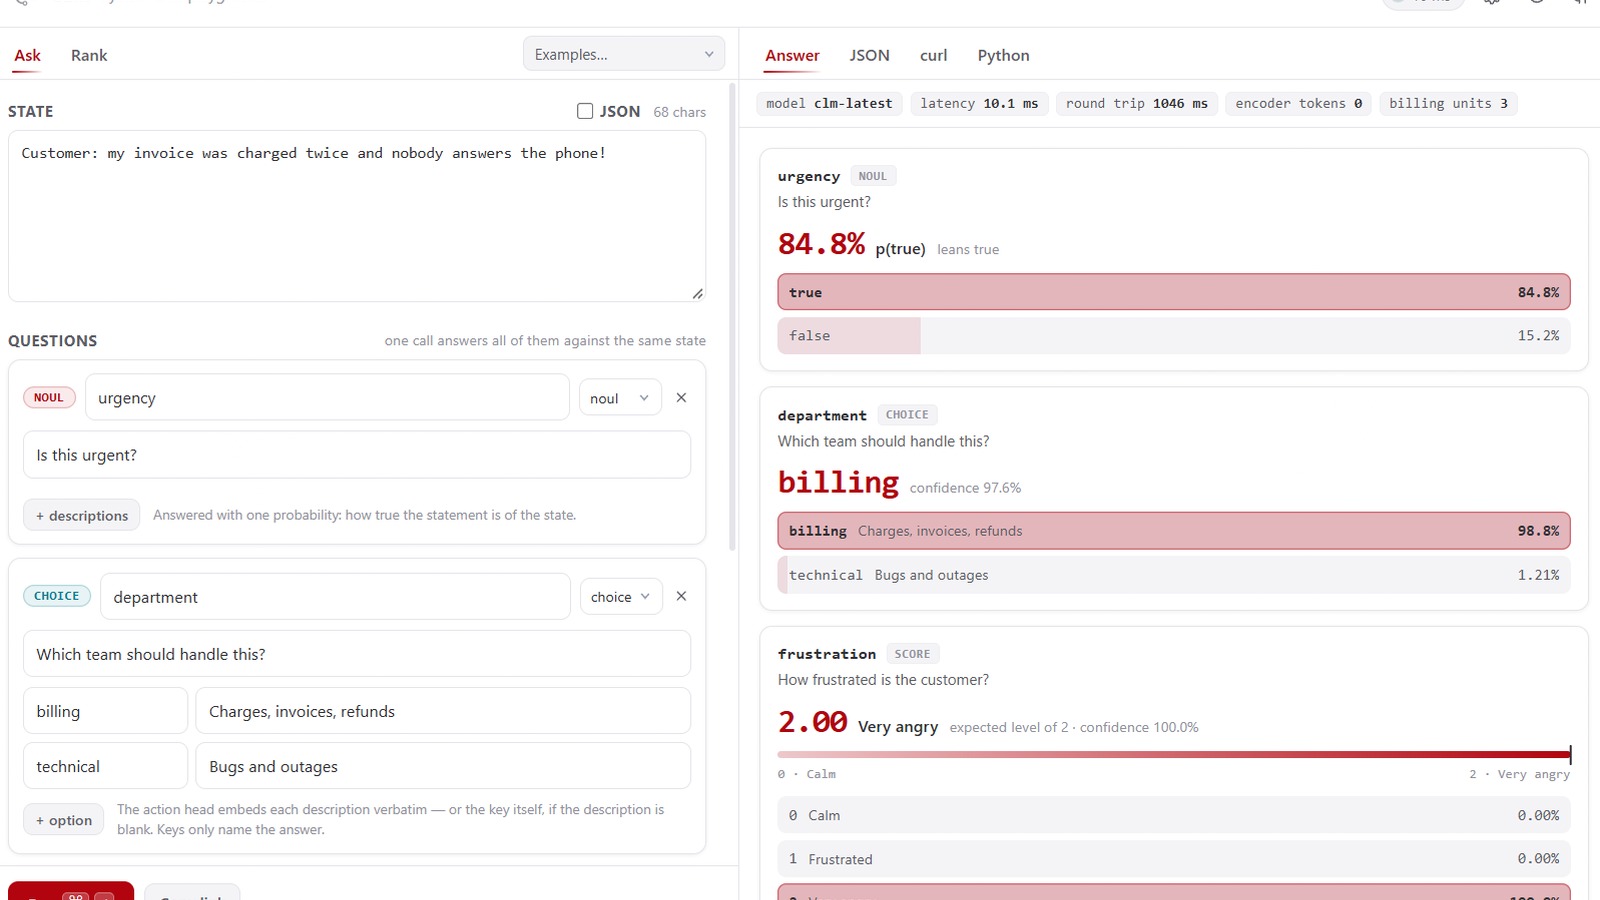
In breve: CLM-8B è un classificatore di decisioni per agenti: codifica separatamente lo stato corrente e le azioni candidate, poi le ordina con un prodotto scalare. Codice e testa di proiezione sono pubblici con licenza Apache 2.0, ma per eseguirlo serve anche Qwen3-8B come encoder. È utile quando le opzioni sono note e riutilizzabili; non sostituisce un modello generativo quando l’azione deve essere inventata.
Che cosa è stato pubblicato
Il progetto rilascia il server CLM, il client, una testa di proiezione da circa 75 MB e il checkpoint CLM-v0.1-8B. La licenza dichiarata per codice e pesi è Apache 2.0. Il sistema usa Qwen3-8B congelato come encoder e due teste addestrabili da circa 20 milioni di parametri, una per gli stati e una per le azioni.
Come decide senza generare
Ogni stato e ogni azione vengono trasformati in vettori nello stesso spazio. Il punteggio nasce dal prodotto scalare tra i due embedding e una softmax produce la distribuzione tra le opzioni. L’API espone domande booleane, scelte chiuse e scale ordinate, oltre al ranking diretto di candidati.
Dove la cache cambia il costo
Le azioni possono essere codificate una volta e riutilizzate mentre lo stato evolve. Questo elimina lavoro ripetuto nei loop con tool, rubriche o insiemi di mosse stabili. Gli autori dichiarano fino a nove volte meno latenza rispetto a Jev nei loro test e un vantaggio maggiore con molti candidati, ma hardware, set di azioni e cache determinano il risultato reale.
Cosa significano i benchmark
Il repository riporta prestazioni zero-shot confrontate con Jev su gaming, computer use e tool calling. I risultati 81,6% su DeepSWE e 87,6% su Terminal-Bench 2.1 riguardano invece teste sottoposte a fine-tuning, su 38 e 30 task tenuti fuori dall’addestramento, con soluzioni candidate generate da altri modelli. Non sono quindi il risultato zero-shot del checkpoint generale.
Condizioni e limiti
CLM sceglie soltanto tra candidati forniti e le probabilità sono relative a quell’insieme. La testa è vincolata agli embedding last-token di Qwen3-8B. Il setup di riferimento richiede Python 3.10 o successivo, Linux, GPU NVIDIA e vLLM; il limite configurato nel quickstart è 2.048 token. Nessuna verifica end-to-end indipendente è stata eseguita in questo Radar.
Checklist per provarlo
- Definire un insieme chiuso di azioni o tool prima di scegliere CLM.
- Avviare Qwen3-8B in modalità pooling con la stessa configurazione usata dal checkpoint.
- Bloccare revisioni di repository, modello e dipendenze per rendere il test ripetibile.
- Misurare separatamente cache fredda, cache calda e numero di candidati realistico.
- Confrontare accuratezza, latenza e consumo GPU con il router già in uso.
- Verificare la calibrazione delle probabilità: una distribuzione relativa non garantisce che una scelta sia sicura.
- Usare un fallback quando nessuna azione candidata è adeguata.
- Ripetere il test sui propri task prima di adottare i risultati dichiarati dagli autori.