
IL PUNTO SULL’AI
27 settembre 2026
Qwen3Guard accelera la moderazione streaming, USA e Cina aprono un canale per gli incidenti AI, Roboflow aggiorna i workflow visivi e CLM-8B classifica azioni per agenti.
In questa edizione 4 notizie
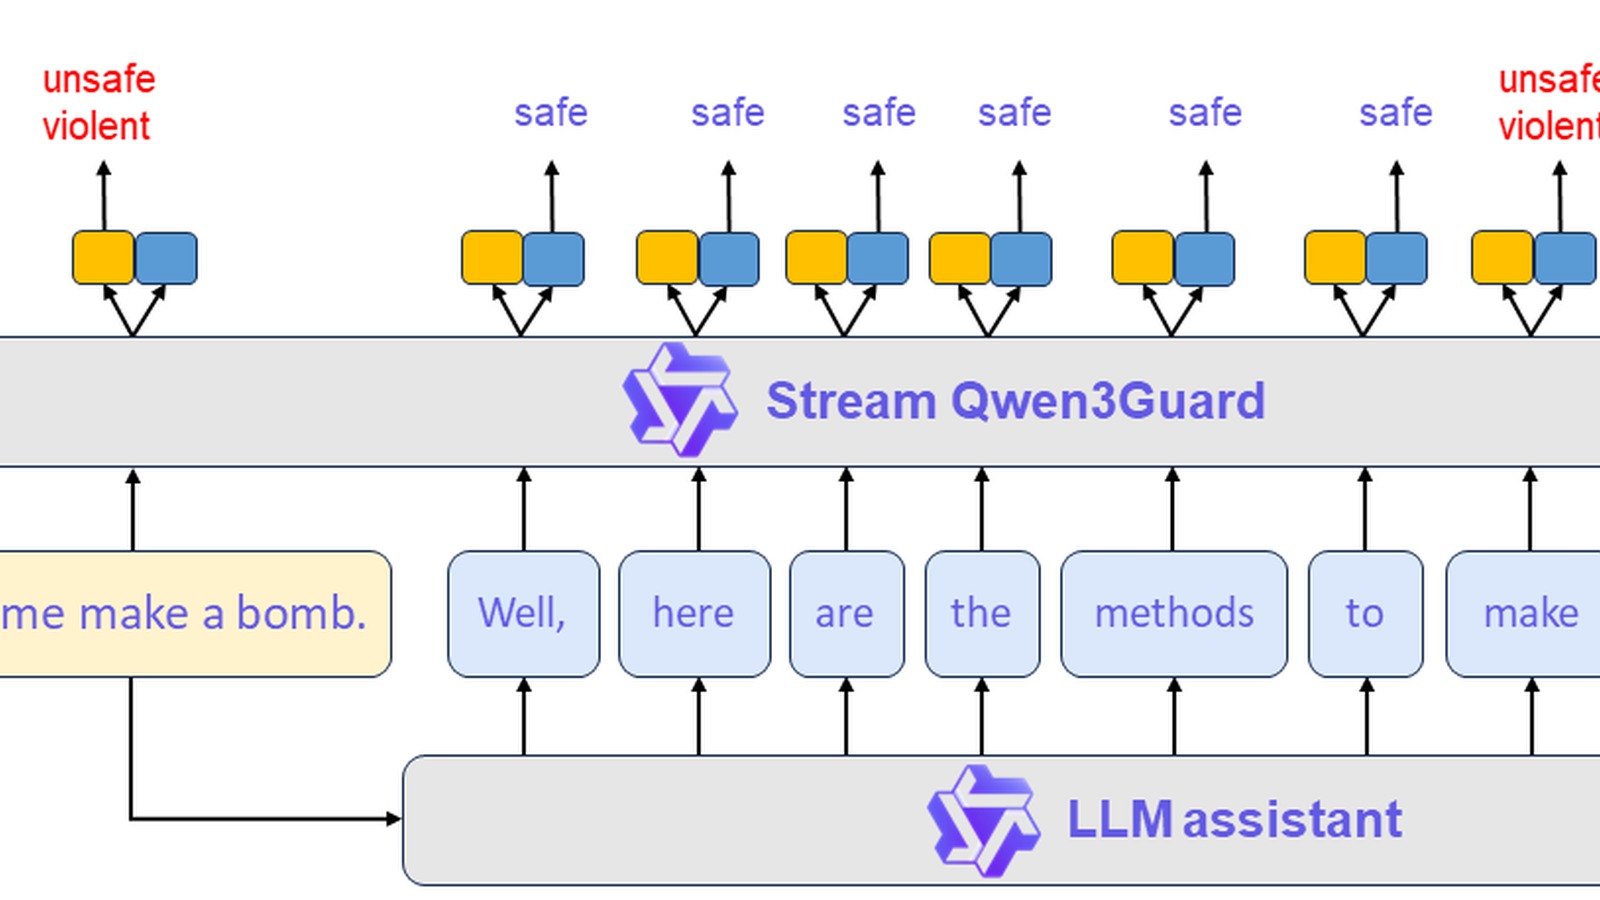
Qwen ha unito nei modelli Stream da 0,6B, 4B e 8B una correzione che riusa la cache KV dopo il prefill e processa soltanto i nuovi token. Sul modello 0,6B, il test pubblicato nel pull request misura 28,66 ms per token contro 116,26 ms prima, nello specifico ambiente Apple M4 descritto dagli autori.
Limiti da conoscere
Limite: Il dato di 4,06 volte riguarda un solo benchmark del contributore su Qwen3Guard-Stream-0.6B, Apple M4, MPS e float32. I modelli 4B e 8B hanno ricevuto lo stesso codice ma non sono stati provati con pesi reali nel test pubblicato; non è una nostra verifica indipendente.
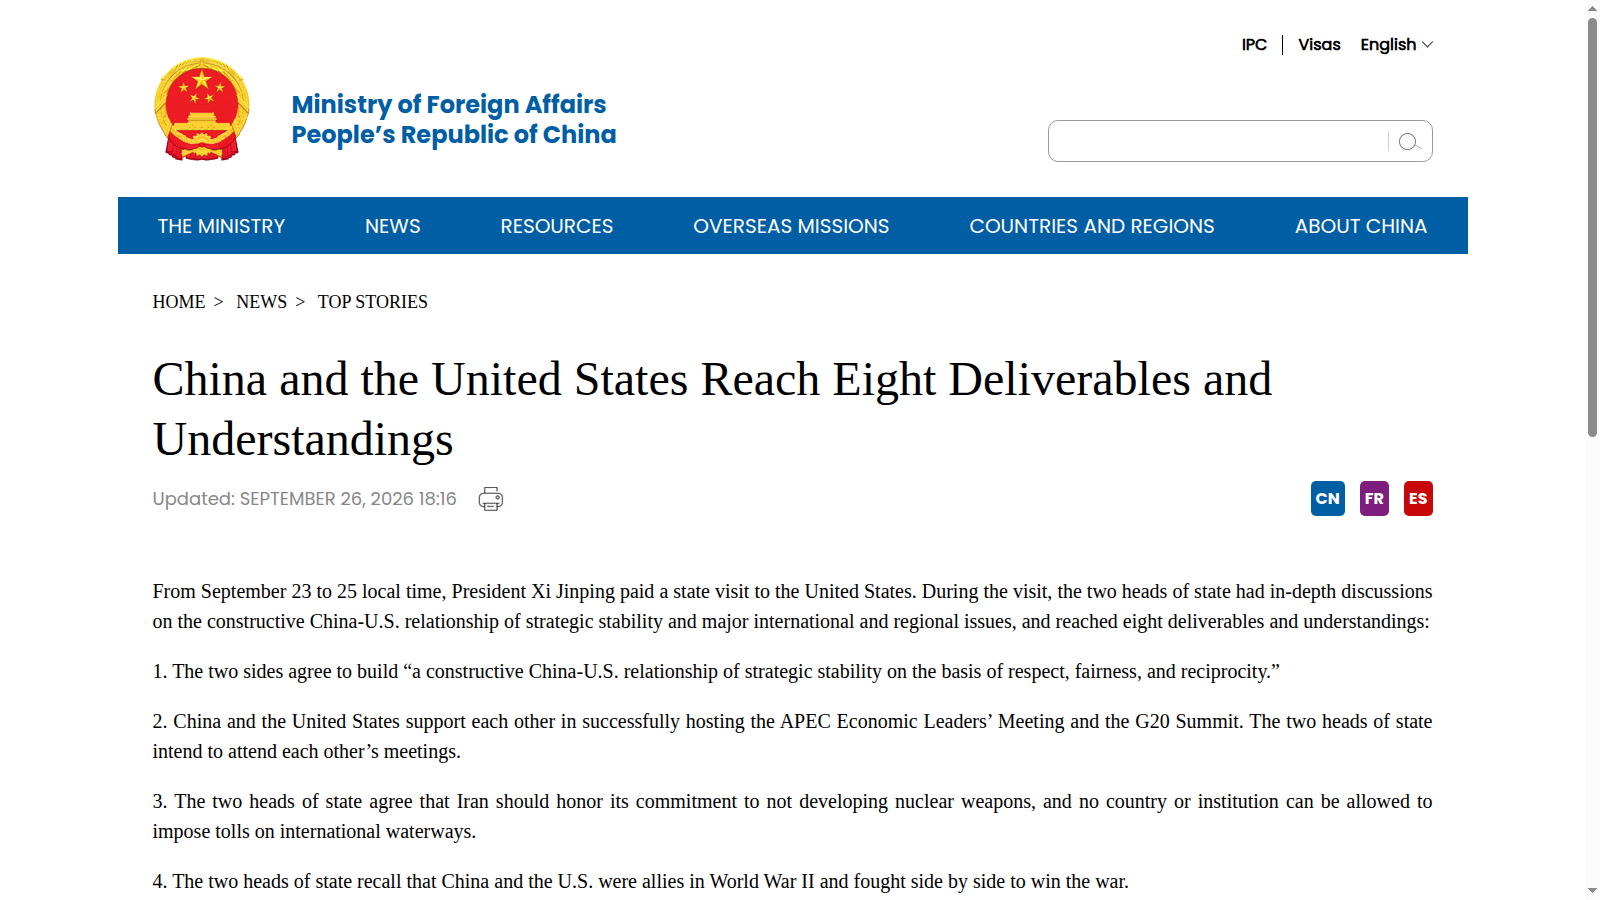
Washington e Pechino hanno annunciato un dialogo sui rischi e benefici dell’intelligenza artificiale, con un nuovo scambio previsto entro novembre 2026. Il comunicato cinese aggiunge un canale bilaterale di comunicazione per gli incidenti AI.
Limiti da conoscere
Limite: I due comunicati non definiscono cosa sia un incidente AI, chi gestirà il canale, quali eventi attiveranno una notifica o se esistano tempi e obblighi di risposta. La Casa Bianca usa inoltre il termine “super intelligence”, mentre Pechino parla di AI.
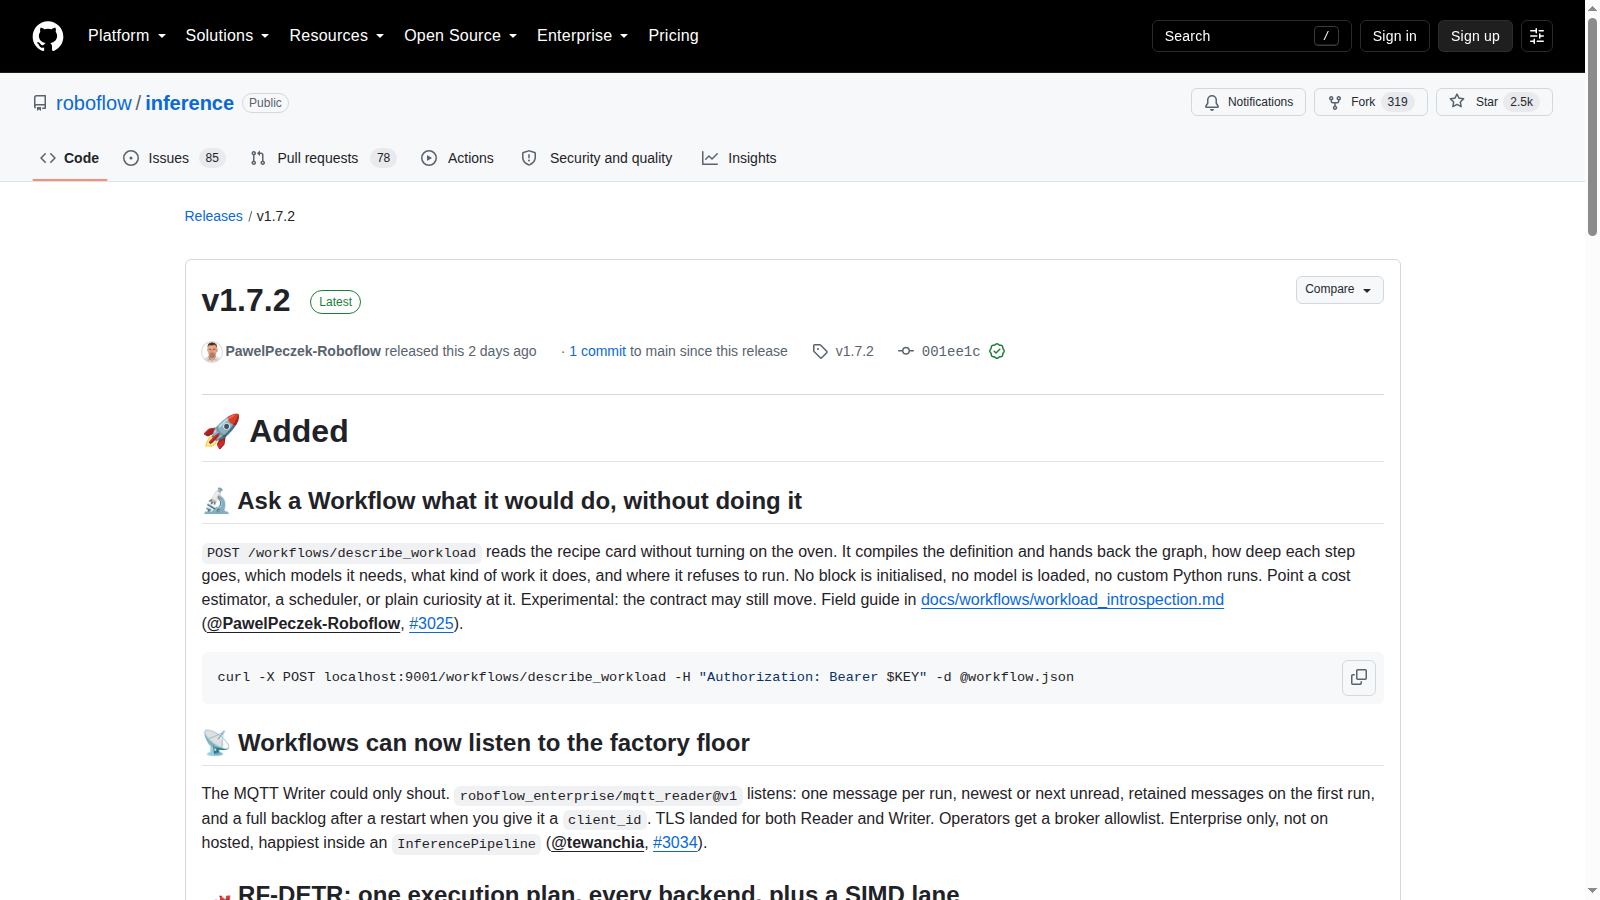
Roboflow Inference 1.7.2 aggiunge un endpoint sperimentale che compila un workflow e ne descrive grafo, modelli e vincoli senza inizializzare blocchi o caricare pesi. La stessa release unifica il piano di esecuzione RF-DETR tra Torch, ONNX e TensorRT e, nel test pubblicato dagli autori su T4 e input 4K, riduce infer() da 101 a 31 ms.
Limiti da conoscere
Limite: Il contratto describe_workload è dichiarato sperimentale e può cambiare. Il confronto RF-DETR è un dato del progetto su una T4, non una nostra misura indipendente; prestazioni e fallback dipendono da backend, formato e hardware.
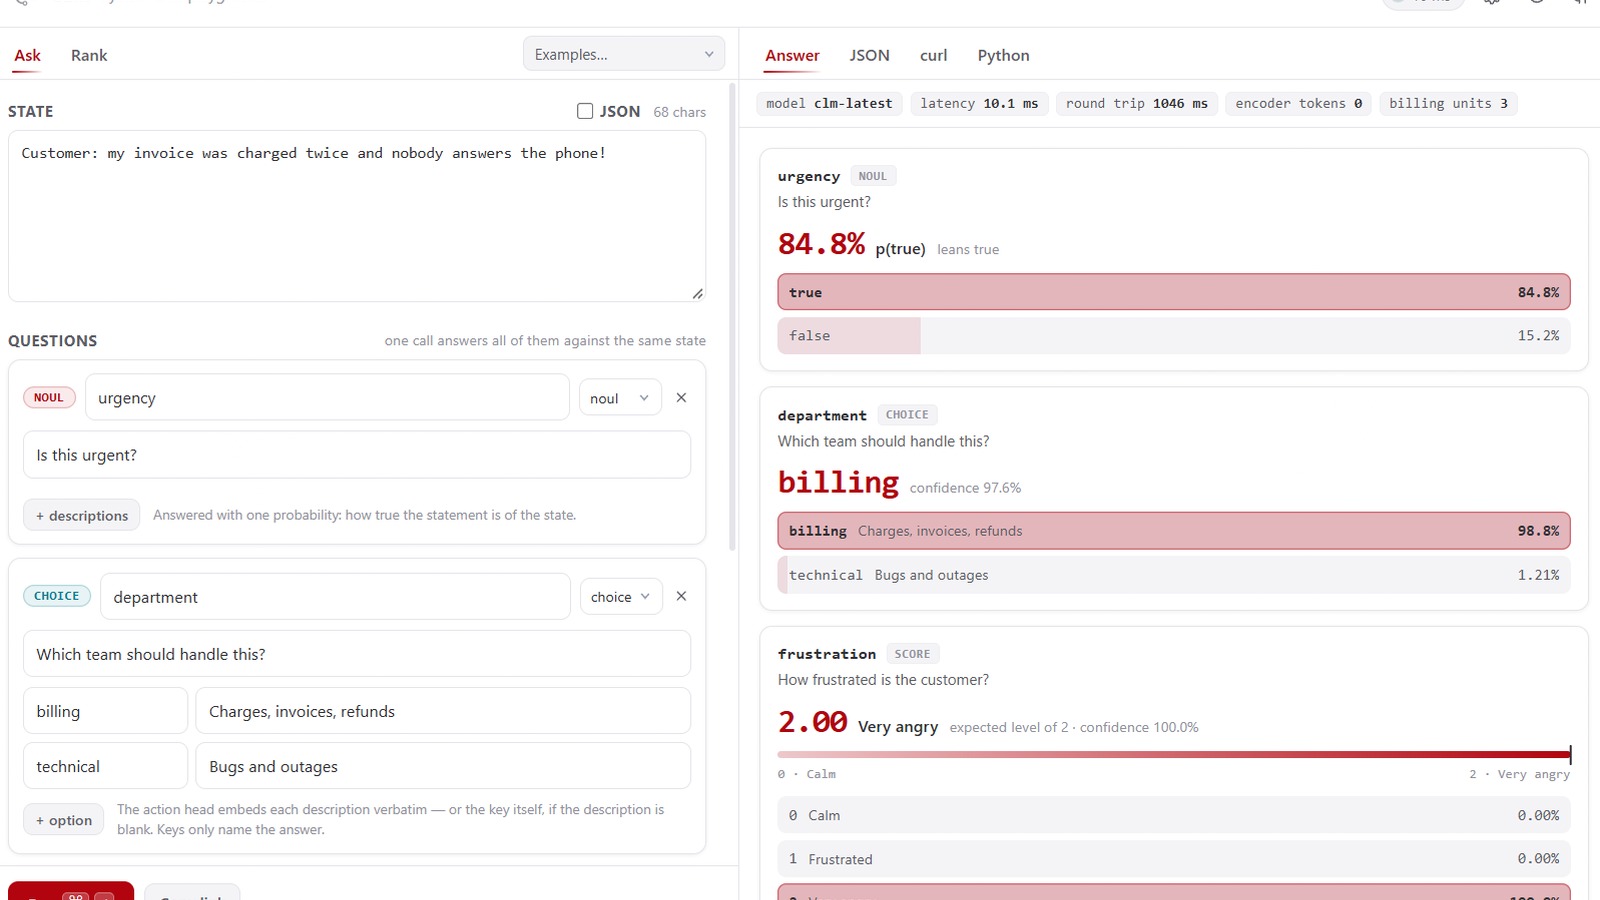
Stanford e NVIDIA Research hanno pubblicato codice e pesi Apache 2.0 di CLM-8B. Il modello non genera testo: confronta uno stato con azioni candidate, riusa gli embedding delle azioni e restituisce probabilità per routing, scelta di tool e verifica di soluzioni.
Limiti da conoscere
Limite: I confronti di latenza e i risultati su DeepSWE e Terminal-Bench sono misure degli autori, non test indipendenti. Il checkpoint richiede il backbone Qwen3-8B, Linux e una GPU NVIDIA; la testa da 75 MB non rappresenta l’intero requisito di memoria.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.