
L’ANALISI
Qwen3Guard-Stream riusa la cache KV: cosa cambia nella moderazione in tempo reale
Qwen corregge il percorso streaming di Qwen3Guard nei modelli 0,6B, 4B e 8B. Analisi del fix alla cache KV, benchmark dichiarato, limiti e checklist di aggiornamento.
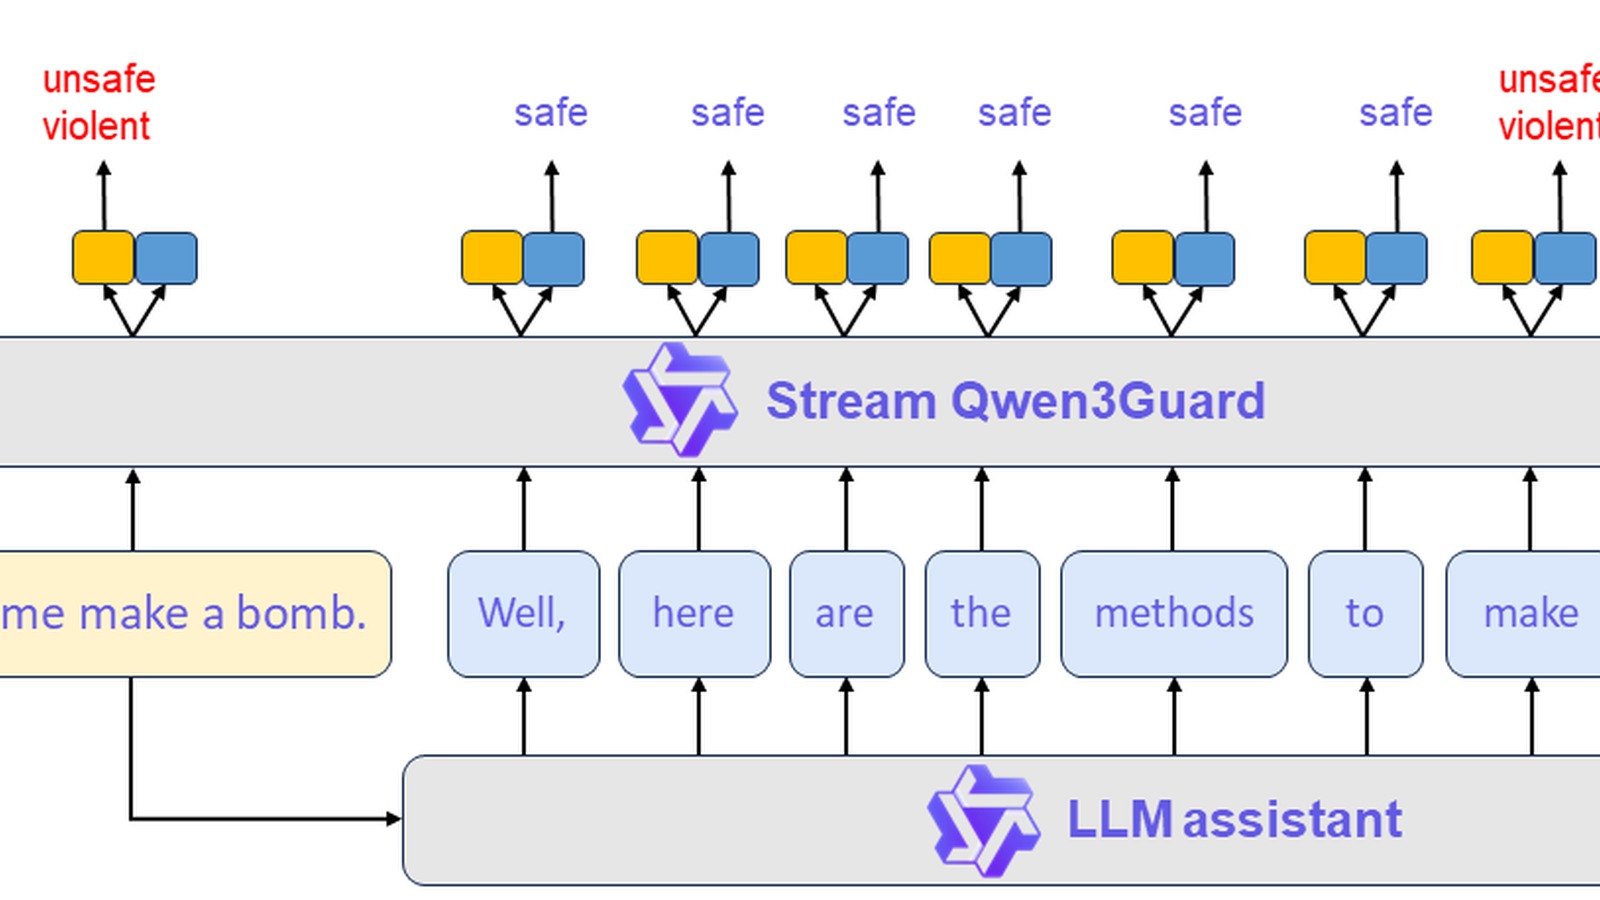
In breve: La correzione evita di ricalcolare a ogni passo l’intero prefisso crescente: dopo il prefill, Qwen3Guard-Stream conserva la cache KV e passa al modello solo il nuovo token. Nel test pubblicato sul modello 0,6B questo riduce la latenza incrementale mediana da 116,26 a 28,66 ms per token. Il vantaggio è concreto per la moderazione durante la generazione, ma resta da misurare sulle macchine e sui modelli 4B e 8B usati in produzione.
Il difetto corretto
L’helper streaming ricalcolava il prefisso che continuava a crescere e non sfruttava la cache KV. Il commit modifica il generatore interno per eseguire il prefill una volta, conservare past_key_values e processare nelle chiamate successive soltanto il token incrementale.
Risultato misurato sul modello 0,6B
Nel test allegato al pull request, con prompt di 64 token e 16 token nuovi, la latenza incrementale mediana passa da 116,26 a 28,66 ms per token. Il tempo totale, prefill incluso, passa da 1.958,92 a 516,25 ms. Sono tre prove dopo warmup su Apple M4 con MPS, float32, PyTorch 2.8.0 e Transformers 4.55.4.
Compatibilità e comportamento dell’API
La modifica è stata applicata ai repository 0,6B, 4B e 8B perché il file di modellazione era identico. Gli output streaming ora contengono solo il risultato dell’ultimo token, come indicato dalla docstring, invece dell’intero prefisso; i campi della risposta restano liste con un elemento.
Perché conta in un guardrail locale
Un controllo token per token deve restare vicino alla velocità del modello generativo: se rilegge tutta la cronologia a ogni passo, il costo cresce durante la risposta. Il riuso della cache rende più credibile l’impiego del modello come filtro locale in linea, senza trasformare però un classificatore in una policy di sicurezza completa.
Condizioni e limiti
I dodici test CPU usano un modello ridotto. Il confronto con pesi reali e il benchmark riguardano solo la variante 0,6B; 4B e 8B non hanno misure pubblicate nella modifica. Il test è del contributore, non indipendente, e non copre CUDA, CPU, Metal su altre macchine o tokenizer diversi da Qwen3.
Checklist per aggiornare senza perdere controllo
- Bloccare la revisione esatta del repository prima dell’aggiornamento e registrare il commit.
- Verificare Transformers 4.55 o successivo e rieseguire i test dell’integrazione.
- Controllare che dopo il prefill ogni chiamata passi soltanto il nuovo token.
- Confrontare le etichette prima e dopo il fix su un set locale con casi sicuri, controversi e non sicuri.
- Misurare prefill, latenza per token, RAM e VRAM sul proprio hardware.
- Provare separatamente 0,6B, 4B o 8B: non estendere automaticamente il dato misurato sul modello più piccolo.
- Rivedere la logica che consumava l’intero prefisso, perché l’output ora rappresenta solo l’ultimo token.
- Mantenere soglie, audit e fallback applicativi: il guardrail non sostituisce la policy del sistema.