Nel video condiviso da Google Developers, una persona costruisce un cyberdeck senza conoscere bene l’hardware. Punta la videocamera sul banco, parla con Gemini, gli fornisce documentazione e librerie dei componenti e riceve istruzioni mentre collega display e Raspberry Pi. È una demo efficace, ma il punto tecnico non è che «l’AI sa montare un computer». La novità è il modo in cui il modello mantiene il dialogo mentre osserva immagini, consulta contesto e porta avanti lavoro asincrono.
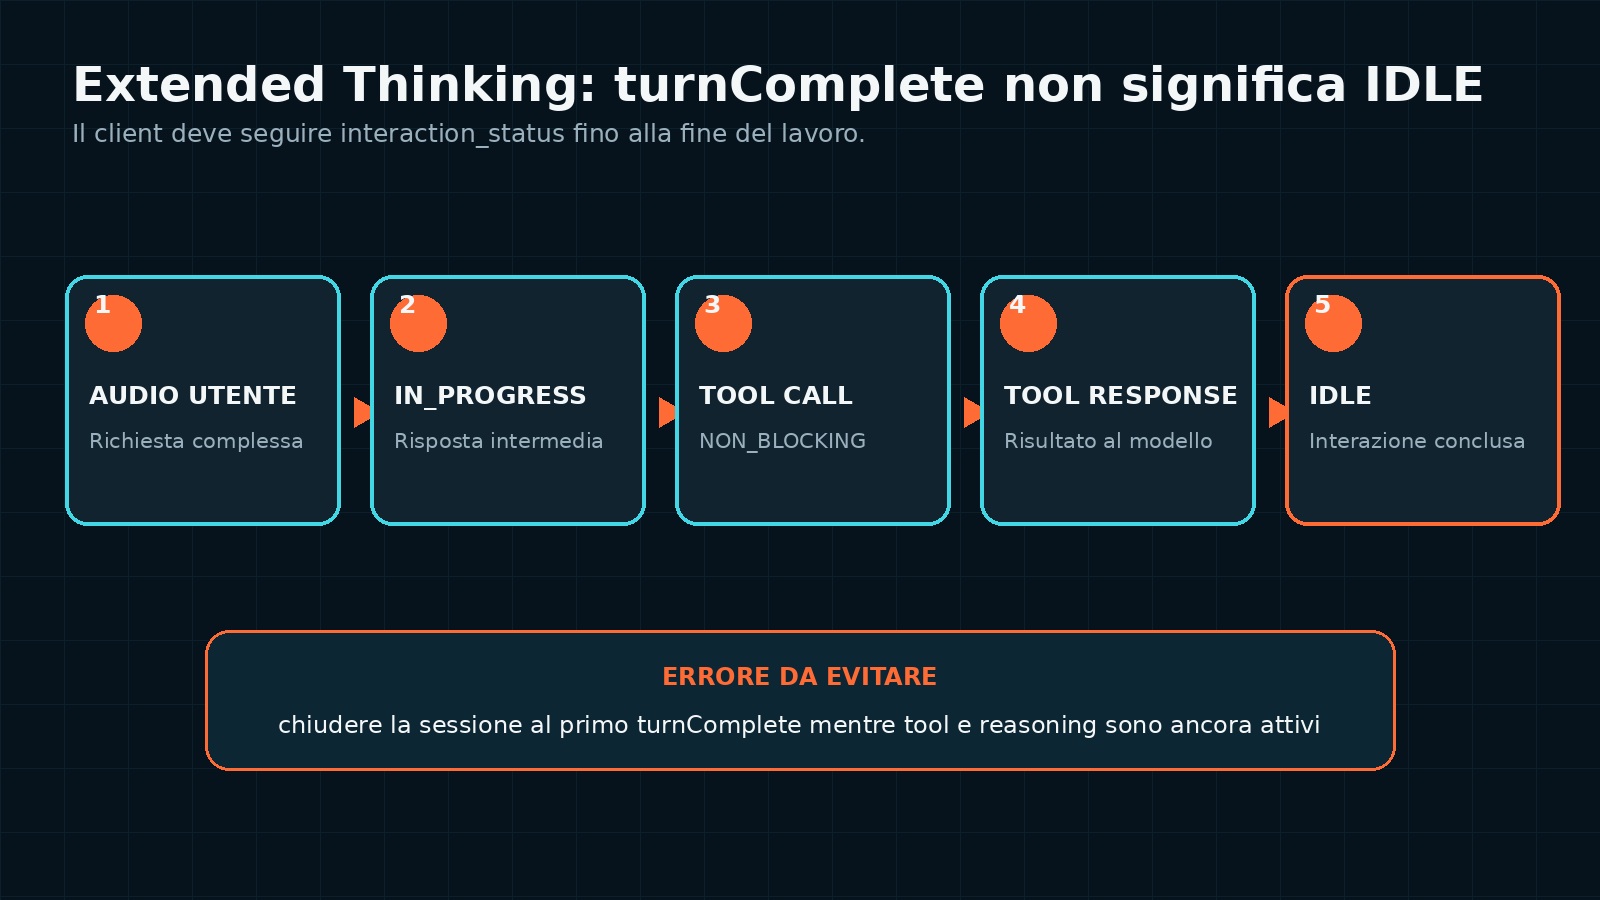
interaction_status passa a IDLE. La demo mostra la fattibilità dell’esperienza, non la sua affidabilità in produzione.Cosa mostra davvero la demo del cyberdeck
Ho analizzato il video pubblico, i sottotitoli e le due versioni disponibili nel post. Il filmato dura 67,88 secondi. Nella sequenza vediamo il modello riconoscere il banco di lavoro, ricevere un piano di costruzione con documenti e dettagli di cablaggio, spiegare come aprire il fermo del connettore DSI e guidare l’accensione del prototipo.
Quello che possiamo osservare è un’interazione vocale collegata al contesto visivo. Il filmato suggerisce anche l’uso della documentazione in background. Non vediamo però log, prompt completi, tempi grezzi, errori, ripetizioni o collegamenti sbagliati. I tagli di montaggio impediscono di misurare latenza, continuità reale e tasso di riuscita. Va quindi trattato come una dimostrazione scelta dal produttore, non come un benchmark indipendente.
Gemini 3.8 Live ed Extended Thinking non sono lo stesso modello
Gemini 3.8 Live
gemini-3.8-liveBLOCKING o NON_BLOCKINGturnComplete riporta il client in idleGemini 3.8 Live Extended Thinking
gemini-3.8-live-extended-thinkinglow, medium o highNON_BLOCKINGinteraction_status = IDLE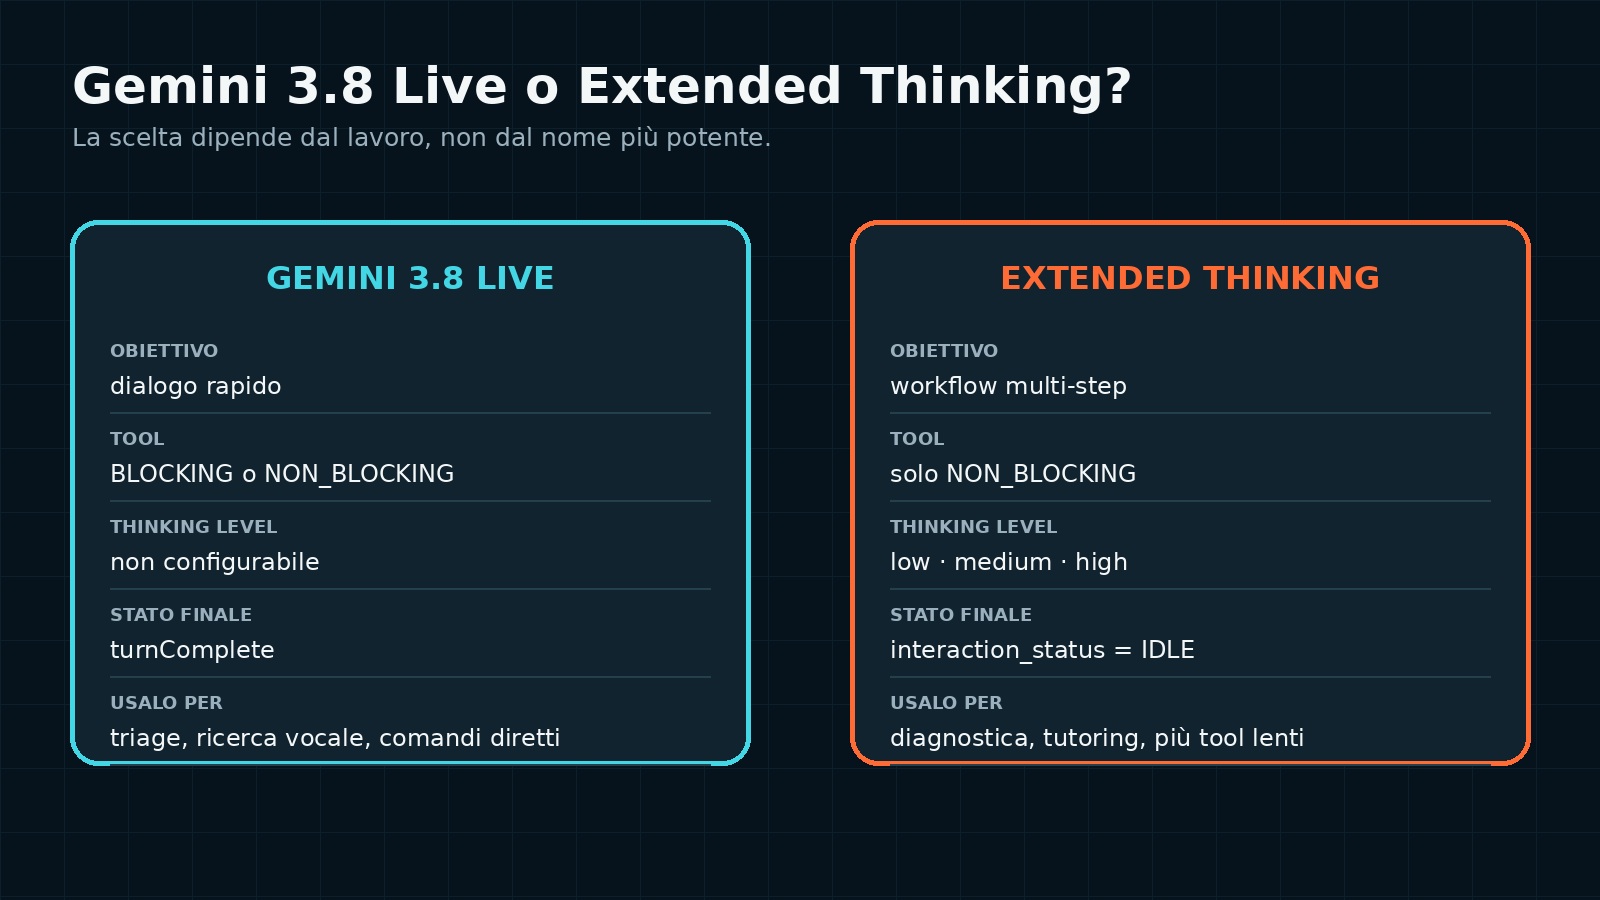
La differenza importante: turnComplete non significa più “finito”
Con Extended Thinking il modello può emettere una frase intermedia, marcare quel segmento audio come completato e continuare a ragionare o aspettare il risultato di uno strumento. Se il client chiude la sessione al primo turnComplete: true, rischia di interrompere il lavoro prima della risposta finale.
Il ciclo corretto segue interaction_status. Durante il ragionamento e le chiamate agli strumenti lo stato resta IN_PROGRESS. Il client torna in ascolto soltanto quando riceve IDLE. Inoltre, tutte le funzioni dichiarate per Extended Thinking devono avere comportamento NON_BLOCKING: una funzione bloccante produce un errore.
Cosa entra ed esce dalla Live API
La Live API usa una connessione WebSocket stateful. Accetta testo, audio, immagini e video. L’audio in ingresso è PCM 16 bit a 16 kHz, quello in uscita PCM 16 bit a 24 kHz. I due modelli dichiarano 131.072 token di input e 65.536 di output.
Il supporto alle immagini significa comprensione visuale, non generazione. Per il flusso visuale, la Live API riceve il video come sequenza di immagini, per esempio JPEG o PNG, fino a un frame al secondo. Non sono indicati come disponibili caching, code execution, file search, structured output, URL context o Batch API. Le sessioni native audio hanno inoltre limiti operativi: fino a 15 minuti per solo audio e fino a 2 minuti quando entra anche il video, salvo gestione e ripresa della sessione.
Il prezzo nominale non è il costo dell’agente
Google pubblica per Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking un prezzo di 0,005 dollari al minuto per l’audio in ingresso e 0,018 dollari al minuto per l’audio in uscita. La pagina generale dei prezzi raggruppa invece le tariffe sotto la voce generica dei modelli native audio della Live API; prima di costruire un conto economico verificherei comunque lo SKU e la tariffa effettivamente applicati nella console del progetto. Dati verificati il 15 settembre 2026.
Anche quando il prezzo del modello è confermato, mancano trasporto realtime, WebRTC o media server, telefonia, tool esterni, storage, osservabilità, retry e supervisione. Un confronto “costa X all’ora” è poco utile se non dichiara quanta parte della sessione contiene audio in ingresso, audio generato, silenzio e attese degli strumenti.
Benchmark: numeri interessanti, ma del produttore
Google riporta per Extended Thinking il primo posto nello Speech-to-Speech Quality Index di Artificial Analysis con 82,6, il 68,6% su τ-Voice, il 35,1% su τ-Voice-banking e il 97,7% su Big Bench Audio. Questi numeri descrivono test diversi: preferenza o qualità conversazionale, completamento di compiti agentici e ragionamento audio non sono la stessa cosa.
La pagina di lancio non fornisce log grezzi, varianza o una prova italiana controllata. La model card, invece, dichiara anche i limiti: possibili allucinazioni, rallentamenti o timeout e knowledge cutoff gennaio 2025. Il verdetto corretto è quindi “promettente da testare”, non “migliore in assoluto”.
Privacy: gratuito e a pagamento non hanno lo stesso trattamento
Nei servizi gratuiti del Gemini Developer API Google può usare prompt, file e risposte per migliorare i prodotti, anche tramite revisori umani, e invita a non inviare informazioni sensibili o riservate. Nei servizi a pagamento dichiara di non utilizzare prompt e risposte per il miglioramento dei prodotti, pur potendo conservarli temporaneamente per sicurezza e obblighi normativi.
La zero data retention non è automatica: richiede approvazione per il progetto. Nella Live API bisogna inoltre evitare la session resumption se si vuole restare nel perimetro ZDR; un session handle può comportare conservazione per 24 ore. Il Search grounding conserva prompt, contesto e output per 30 giorni. Per un agente che vede un banco di lavoro, uno schermo o documenti aziendali, questi dettagli contano più dell’effetto wow della demo.
Come lo testerei prima di usarlo davvero
- Stesso script in italiano per almeno tre run, con rete e regione annotate.
- Misura del time-to-first-audio e della latenza dopo un’interruzione.
- Tool artificialmente lenti da 2, 5 e 10 secondi, inclusi timeout ed errori.
- Codici alfanumerici, accenti, rumore e cambio lingua italiano/inglese.
- Azioni irreversibili protette da conferma esplicita e chiave di idempotenza.
- Log separati per audio, tool call, stato dell’interazione e costo.
È lo stesso principio che ho usato quando ho creato un prototipo Android con Google AI Studio: una demo ha valore quando rende visibili anche condizioni, limiti e passaggi riproducibili. Per l’architettura generale rimando anche alla mia guida ai documenti ufficiali sugli agenti Google. Il confronto più vicino sul versante concorrente è la pagina Radar dedicata a GPT-Live-1 nelle API.
Il mio verdetto
La demo del cyberdeck funziona perché trasforma il modello in un compagno di banco: vede, ascolta e mantiene il filo mentre l’utente usa entrambe le mani. La parte davvero nuova, però, è meno cinematografica: Extended Thinking cambia il contratto del client, obbliga a gestire strumenti non bloccanti e separa la fine di un segmento audio dalla fine dell’interazione.
Sceglierei Gemini 3.8 Live per assistenza vocale rapida, triage e comandi diretti. Proverei Extended Thinking per diagnostica, tutoring e workflow con più strumenti, ma solo con timeout, conferme e osservabilità. Terrei ancora una pipeline a cascata quando servono componenti sostituibili, trascrizioni auditabili o controllo separato su riconoscimento, ragionamento e sintesi vocale.
Domande frequenti
Gemini 3.8 Live Extended Thinking ragiona davvero mentre parla?
Può emettere aggiornamenti vocali mentre ragionamento e tool asincroni restano attivi. Non significa che esponga una catena di pensiero interna completa: il client riceve audio, eventi, tool call e stato dell’interazione.
Posso usare function calling bloccante?
Sul modello base sì, anche se NON_BLOCKING è il comportamento predefinito. Su Extended Thinking le funzioni devono essere NON_BLOCKING; quelle bloccanti producono errore.
Il video del cyberdeck è un test indipendente?
No. È una demo ufficiale montata da Google Developers. Mostra un caso d’uso plausibile, ma non documenta failure rate, latenza grezza o accuratezza su più prove.
Si può usare con dati aziendali riservati?
Va progettato sul tier e sul contratto corretti. I servizi gratuiti hanno condizioni di data use diverse dai servizi a pagamento; ZDR richiede approvazione e configurazioni compatibili.
Quanto costa Gemini 3.8 Live?
Google indicava al lancio 0,005 dollari al minuto per l’audio in ingresso e 0,018 dollari al minuto per l’audio in uscita. La tariffa effettiva va verificata nella console e nella pagina ufficiale dei prezzi. Non coincide con il costo completo dell’agente, che può includere telefonia, trasporto realtime, strumenti esterni, storage, osservabilità e retry.
Quanto può durare una sessione Live?
La documentazione indica fino a 15 minuti per sessioni solo audio e fino a 2 minuti per sessioni con video. Le conversazioni più lunghe richiedono una gestione esplicita della sessione e della ripresa, da valutare anche rispetto ai requisiti di conservazione dei dati.
Fonti e riferimenti
Fonti primarie Google verificate il 15 settembre 2026. Il video è conservato localmente per analisi; la sua accessibilità pubblica non implica diritti di ripubblicazione.
Gemini 3.8 Live e Live Extended Thinking
Disponibilità, capacità dichiarate e benchmark riportati da Google.
Apri fonteThinking nella Live API
Stati IN_PROGRESS/IDLE, tool NON_BLOCKING e configurazione del thinking.
Apri fonteNew Gemini Audio models for developers
Tariffe di lancio, capacità per sviluppatori e integrazioni della Live API.
Apri fonteAggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.