
L’ANALISI
llama.cpp: Q6_K su Adreno X1, requisiti e limiti
llama.cpp b12408 aggiunge un kernel Q6_K per Adreno X1 non-MoE: requisiti del backend OpenCL, limiti del dispatch e checklist di confronto.
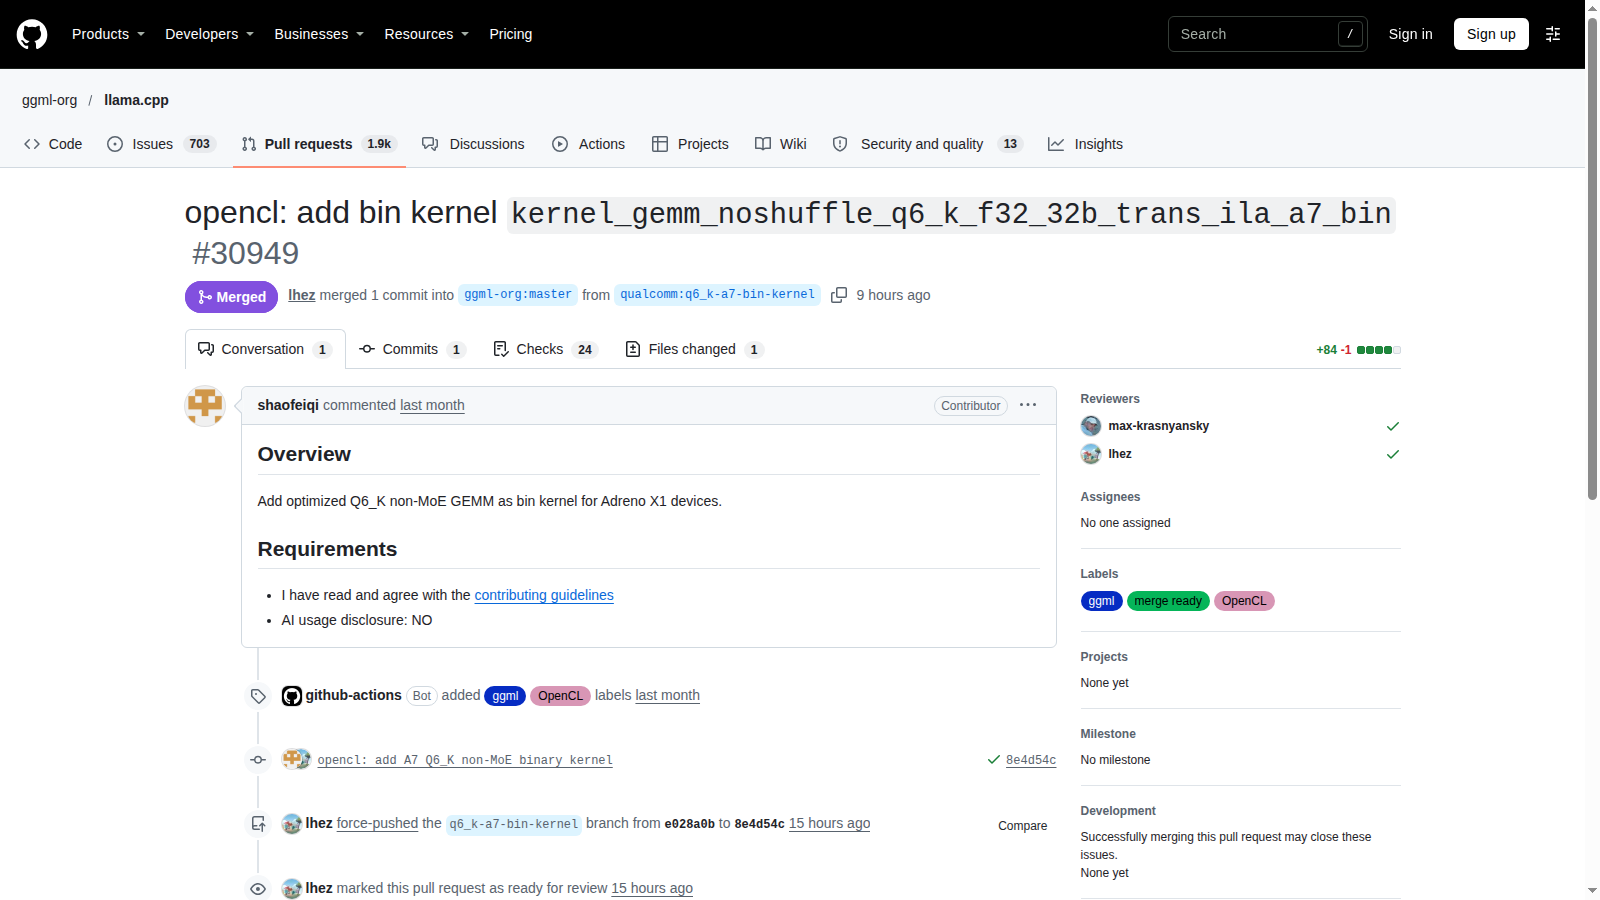
In breve: llama.cpp b12408 aggiunge un kernel binario Q6_K non-MoE per Adreno X1 nel backend OpenCL. Il nuovo ramo deve essere disponibile nella build e superare i controlli sui tensori; non equivale a un’accelerazione garantita di ogni modello Q6_K o di qualsiasi dispositivo Snapdragon. PR 30949: kernel Q6_K per Adreno X1.
Verifica documentale del 15 novembre 2026: release REST, PR 30949 unita e backend OpenCL al commit 6d3568e31d4e4b1e4db4acb8f6ceaad0084932f3. Nessuna compilazione, esecuzione su Adreno X1 o misura prestazionale: la checklist seguente è un protocollo proposto, non un test eseguito.
Che cosa cambia con b12408?
La PR era stata aperta il 21 ottobre, ma il delta distribuibile è del 15 novembre: unione alle 06:49 e pubblicazione della prerelease REST alle 11:43, ora italiana. Il cambiamento aggiunge al backend OpenCL il caricamento e l’esecuzione del kernel binario A7 per GEMM Q6_K non-MoE. Non è un nuovo modello né un cambio del formato dei pesi. Per chi mantiene una build o un’app basata su llama.cpp, la prima decisione è verificare se quel backend e quel tipo di calcolo fanno parte del proprio percorso d’inferenza.
PR 30949: kernel Q6_K per Adreno X1 · Prerelease b12408: stato e data REST · PR 30949: stato e commit di unione.
Vale per tutti gli Snapdragon o per tutti i modelli MoE?
No: la descrizione della PR delimita il nuovo kernel ai dispositivi Adreno X1 e al calcolo non-MoE. Il suffisso A7 nel nome interno non dimostra, da solo, compatibilità con ogni GPU mobile o con ogni generazione Snapdragon. Anche un modello che usa tensori Q6_K non prova che tutte le sue operazioni passino da questo kernel. Questa è una distinzione pratica per valutare un aggiornamento: confrontare dispositivo, backend, quantizzazione e operazioni effettive, invece di trasformare una modifica mirata in una promessa per l’intera famiglia hardware.
PR 30949: stato e commit di unione · Backend OpenCL al commit dell’integrazione.
Quali controlli decide il backend prima di usarlo?
Nel codice verificato, use_q6_k_bin_kernels è protetta dalla macro GGML_OPENCL_USE_ADRENO_KERNELS. Richiede un kernel GEMV e almeno uno dei kernel GEMM A7 o A8 caricati. Per quel dispatch impone inoltre terza e quarta dimensione uguali a 1, prima dimensione multipla di 256 e seconda multipla di 64, escludendo altri due percorsi specializzati. Queste sono condizioni del ramo osservato al commit della PR, non requisiti universali di ogni file GGUF. Il caricamento di un modello e l’uso del nuovo kernel restano perciò due fatti da verificare separatamente.
Modifiche al backend nella PR 30949 · Backend OpenCL al commit dell’integrazione.
Come fare un confronto utile senza inventare un benchmark?
La pagina della PR consultata non offre un benchmark numerico da riprodurre. Proporrei quindi due build fissate, prima e dopo l’integrazione, con lo stesso modello, la stessa quantizzazione, gli stessi parametri e lo stesso driver. Registrerei prima avvio, backend e correttezza dell’output; solo dopo confronterei elaborazione del prompt e generazione, tenendole separate. Conserverei anche gli errori o il mancato uso del percorso atteso. Questo protocollo serve a decidere se l’aggiornamento cambia il proprio lavoro, non a dichiarare una velocità o un risparmio energetico che qui non sono stati misurati.
PR 30949: kernel Q6_K per Adreno X1 · Prerelease b12408: stato e data REST · Backend OpenCL al commit dell’integrazione.
Checklist pratica proposta
- Identificare il dispositivo Adreno X1 e annotare sistema operativo e driver OpenCL.
- Fissare le revisioni delle due build, evitando un confronto tra rami mobili.
- Usare lo stesso file GGUF Q6_K e conservare il suo checksum nel verbale del test.
- Verificare backend, caricamento dei kernel e operazioni effettivamente eseguite; non dedurli dal solo avvio.
- Controllare la correttezza su input ripetibili prima di misurare prompt e generazione separatamente.
- Ripetere nelle stesse condizioni e documentare eventuali fallback, errori o assenza di beneficio.
Condizioni e limitazioni
È una prerelease e il delta è specifico: Adreno X1, backend OpenCL e GEMM Q6_K non-MoE. Nessun test hardware indipendente, benchmark numerico o miglioramento garantito è stato verificato in questa analisi.
Modelli AI locali: come scegliere LLM, hardware e runtime