
L’ANALISI
llama.cpp: SIMD Q4 e Q5 su s390x, come leggere i test
llama.cpp b12401 estende SIMD a Q4_0, Q4_1, Q5_0 e Q5_1 su s390x: il benchmark della PR distingue prompt e generazione, con repack disattivato.
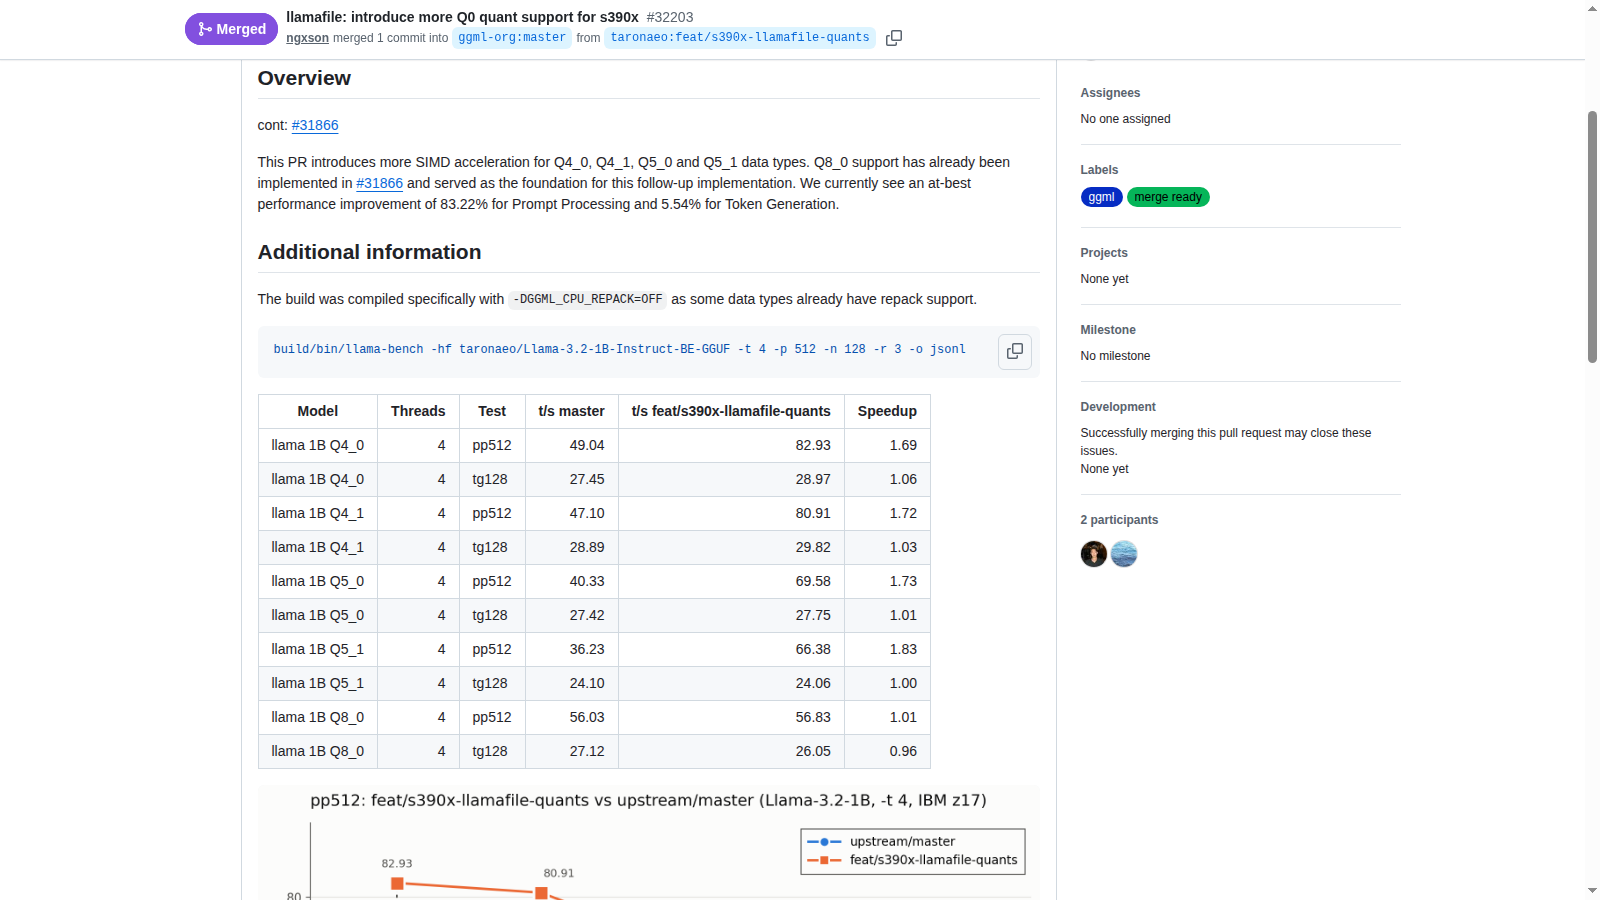
In breve: llama.cpp b12401 aggiunge accelerazione SIMD su s390x per quattro formati Q4/Q5. La PR pubblica un confronto circoscritto con repack disattivato: il guadagno sul prompt non va presentato come uguale velocità aggiuntiva durante la generazione. llama.cpp, PR 32203: formati SIMD e protocollo del benchmark.
Verifica documentale del 15 novembre 2026: PR 32203, differenza del codice, commit acf5d545620203068a87772ee546eb2490de0453 e prerelease REST b12401. Il benchmark è dell’autore della PR, non un test indipendente di Francesco. Nessuna compilazione o esecuzione su s390x in questo controllo.
Quali quantizzazioni e quale architettura cambiano?
La modifica riguarda il percorso llamafile in ggml-cpu per s390x e aggiunge i formati Q4_0, Q4_1, Q5_0 e Q5_1 al lavoro SIMD precedente su Q8_0. Il file modificato è sgemm.cpp, con selezione tramite le macro VXE e VXE2. Questa è un’estensione di un backend specifico: non documenta un’accelerazione equivalente su x86, ARM, CUDA o Metal. La PR è stata unita il 14 novembre alle 23:38 ora italiana, mentre la prerelease b12401 è stata pubblicata il 15 alle 07:59.
llama.cpp, PR 32203: formati SIMD e protocollo del benchmark · PR 32203: differenza del codice sgemm.cpp · GitHub REST: prerelease b12401 e binari s390x.
Perché prompt e generazione vanno letti separatamente?
Il protocollo pubblicato usa Llama 3.2 1B in formato BE-GGUF, quattro thread, prompt da 512 token, generazione da 128 token e tre ripetizioni. Sono due misure con carichi diversi, non un unico punteggio del modello. La conseguenza pratica è semplice: prima di promettere una chat più rapida bisogna osservare la fase che limita il proprio impiego. Il tempo per elaborare il prompt non può sostituire il dato sulla produzione della risposta.
llama.cpp, PR 32203: formati SIMD e protocollo del benchmark.
Che cosa non dimostra la configurazione del benchmark?
L’autore specifica GGML_CPU_REPACK=OFF perché alcuni formati hanno già un percorso repack. Il confronto isola quindi una configurazione intenzionale e non prova che le stesse differenze si mantengano con il repack attivo. Il patch mostra la nuova implementazione, ma non misura il servizio che un lettore ha già in esercizio. L’indicazione operativa è verificare compilazione, formato e opzioni effettive prima di confrontare i risultati, mantenendo una baseline riproducibile.
llama.cpp, PR 32203: formati SIMD e protocollo del benchmark · sgemm.cpp al commit dell’estensione SIMD.
Come impostare un confronto utile sul proprio sistema?
Propongo due build in un ambiente di prova: una revisione precedente nota e il commit che introduce il delta, con stesso modello e stessa quantizzazione. Registrerei separatamente prompt processing e generazione, ripetendo la prova con thread, lunghezze e opzioni costanti. Un secondo confronto con repack attivo risponderebbe a una domanda diversa, cioè quale percorso convenga nella configurazione reale. Queste sono prove proposte: non sono state eseguite da questa redazione.
llama.cpp, PR 32203: formati SIMD e protocollo del benchmark · sgemm.cpp al commit dell’estensione SIMD.
Quando conviene aggiornare e quando no?
Il candidato concreto è chi sta già valutando inferenza su s390x con uno dei quattro formati coinvolti. Per chi usa un’altra architettura, questo delta non giustifica da solo una migrazione o una spesa. Prima di cambiare un servizio verificherei anche correttezza delle risposte, errori, consumi di memoria e possibilità di tornare alla build precedente. La presenza dei binari s390x nella release è verificabile; affidabilità e beneficio del proprio carico richiedono invece un collaudo dedicato.
llama.cpp, PR 32203: formati SIMD e protocollo del benchmark · GitHub REST: prerelease b12401 e binari s390x.
Checklist pratica proposta
- Controllare che la destinazione sia s390x e che la quantizzazione rientri nei quattro formati citati.
- Fissare b12401 o il commit acf5d545620203068a87772ee546eb2490de0453 e annotare la baseline precedente.
- Conservare il modello e gli stessi parametri: quattro thread, prompt 512, generazione 128, tre ripetizioni se si replica il protocollo della PR.
- Registrare esplicitamente se GGML_CPU_REPACK è OFF; valutare l’opzione ON solo come esperimento separato.
- Confrontare correttezza, prompt e generazione separatamente, prima di aggiornare un servizio reale.
Condizioni e limitazioni
Benchmark dell’autore della PR, non replica indipendente. Risultati circoscritti a s390x, al modello e alle opzioni dichiarate; repack disattivato. Nessun beneficio equivalente dimostrato per altri backend.