
L’ANALISI
llama.cpp: corretto effort nelle richieste Messages
llama.cpp b12415 inoltra output_config.effort a reasoning_effort nel percorso /v1/messages. Il diff aggiunge un test, non un benchmark di velocità.
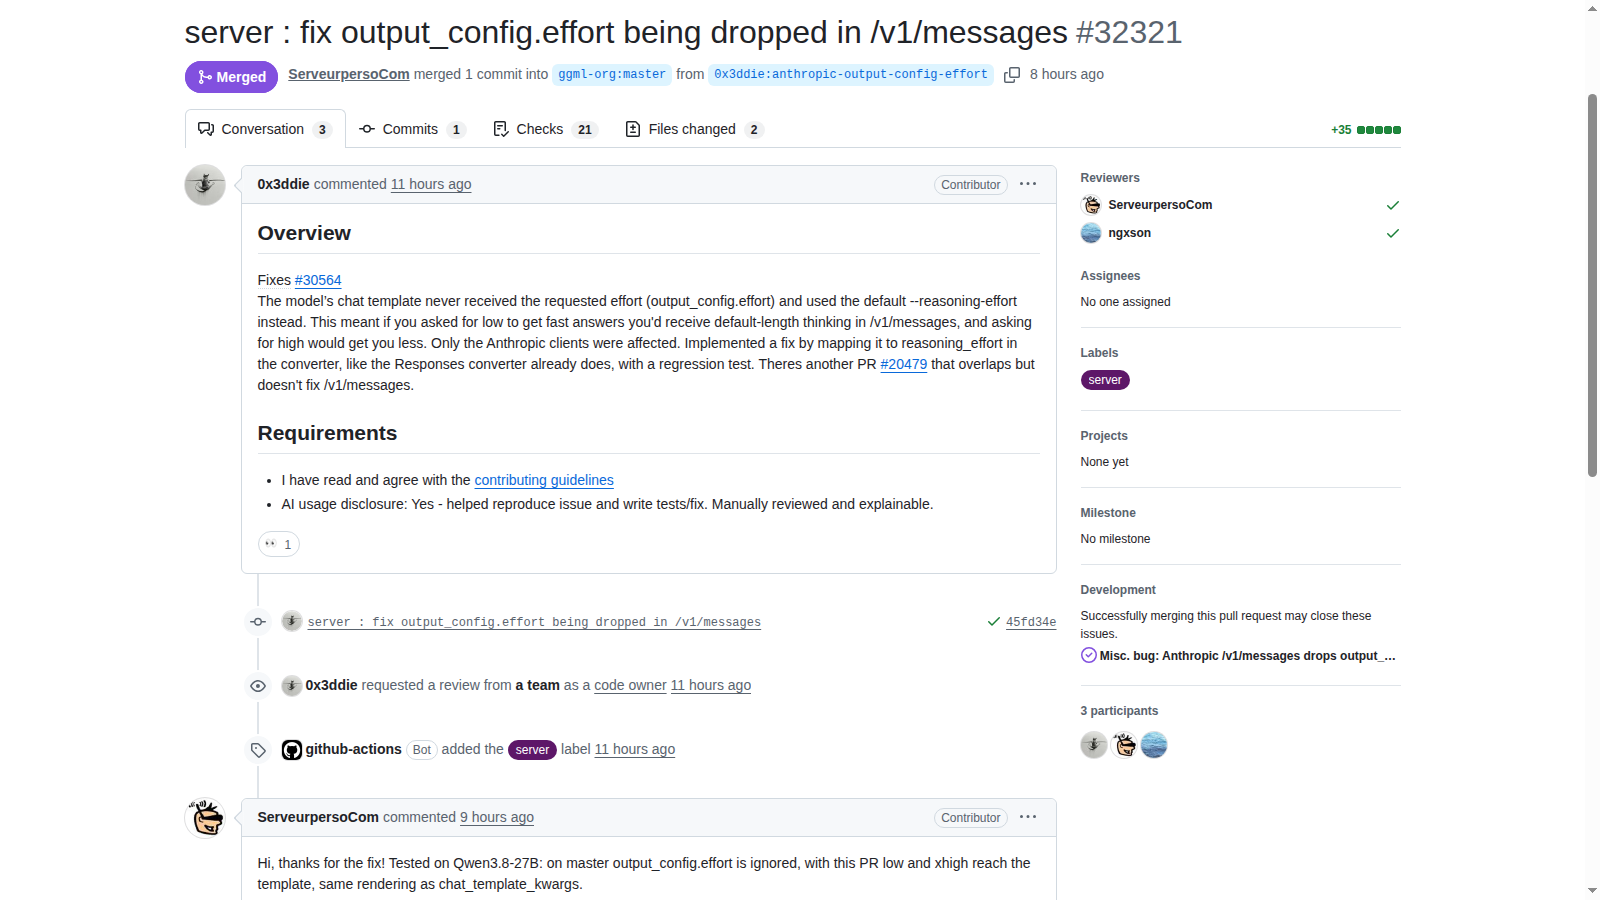
In breve: llama.cpp b12415 corregge il percorso /v1/messages: il convertitore inoltra output_config.effort al campo interno reasoning_effort. Prima il parametro poteva non raggiungere il template chat. Il cambiamento riguarda la compatibilità del server, non un nuovo modello Anthropic o una riduzione di latenza misurata. PR 32321: fix del parametro effort in Messages.
Verifica documentale del 15 novembre 2026 sulla prerelease REST b12415 e sulla PR 32321, unita al commit 4e5116f47619dac4180c3007ef02a383f347554c. Sono stati letti il diff C++ e il test Python. Nessun server, inferenza, suite upstream o confronto di latenza eseguito per questa notizia.
Quale parametro veniva perso?
La PR 32321 descrive un problema nel convertitore delle richieste compatibili Anthropic. Il client inviava output_config.effort, ma quel valore non arrivava al template chat, che continuava a usare il livello di ragionamento predefinito. Il diff aggiunge la lettura dell’oggetto output_config, ne estrae effort e, quando la stringa non è vuota, la copia in reasoning_effort nel corpo interno. La distinzione è importante per diagnosticare risultati inattesi: vedere un parametro nel JSON inviato dal client non dimostra che il modello lo abbia ricevuto. Il fix rende esplicito quel passaggio, senza misurare la qualità finale delle risposte.
PR 32321: fix del parametro effort in Messages · Diff del convertitore e test di regressione parametrizzato.
Riguarda Claude o il server locale?
Il perimetro verificato è llama.cpp e il suo percorso /v1/messages compatibile con il protocollo Anthropic. La PR dice che il problema colpiva i client di quel percorso e distingue il convertitore Responses, che già gestiva la mappatura. Non è quindi l’annuncio di un nuovo modello Anthropic, una modifica dei prezzi o una correzione del servizio cloud Claude. Non dimostra neppure che qualsiasi modello locale interpreti effort allo stesso modo. Protocollo del client, conversione del server e capacità del template restano livelli diversi da registrare quando si costruisce una prova.
PR 32321: descrizione e commit di unione · Diff del convertitore e test di regressione parametrizzato.
Che cosa controlla il test aggiunto al codice?
Il test Python è parametrizzato sui valori low e high e usa il template openai-gpt-oss-120b.jinja. Interroga /v1/messages/count_tokens in tre condizioni: configurazione predefinita, chat_template_kwargs.reasoning_effort e output_config.effort con thinking adaptive. Le asserzioni chiedono che il conteggio ottenuto dalla configurazione esplicita differisca dal default e coincida fra le due forme del parametro. È una verifica del prompt costruito nel caso di test, non una valutazione delle risposte generate. La presenza delle asserzioni nel repository non significa che questa redazione abbia eseguito la suite o riprodotto il risultato.
Diff del convertitore e test di regressione parametrizzato.
Come confrontare i livelli senza attribuire al modello un errore del client?
La procedura proposta parte da una revisione fissata che includa la correzione. Annotare client, endpoint, template e modello; usare un input sintetico uguale nelle prove. Verificare prima il percorso del parametro con un controllo del prompt o dei token coerente con il proprio template, poi valutare separatamente le risposte. Se si misura la latenza, ripetere nelle stesse condizioni e registrare token generati, impostazioni e fallimenti. Low e high non sono promesse universali di velocità o accuratezza: descrivono una configurazione che il template deve effettivamente riconoscere. Qui resta un protocollo da eseguire, non un benchmark già disponibile.
Prerelease b12415: stato e data di pubblicazione · Diff del convertitore e test di regressione parametrizzato.
Checklist pratica proposta
- Fissare una revisione che includa la PR 32321, distribuita nella prerelease b12415.
- Registrare client, endpoint /v1/messages, modello e template realmente usati.
- Controllare il campo output_config.effort e distinguere il suo invio dalla mappatura interna.
- Usare un input sintetico e confrontare default, low e high a condizioni costanti.
- Verificare prima il prompt o il conteggio token, poi l’output generato e infine eventuali tempi.
- Non presentare il test upstream letto nel diff come una suite o un benchmark eseguiti in proprio.
Condizioni e limitazioni
È una prerelease. Il diff controllato riguarda il convertitore e un caso di test con un template specifico; non sono stati eseguiti inferenza, test upstream o misure di qualità e latenza.