
L’ANALISI
llama.cpp: fix SYCL, Metal, WebGPU e slot server
llama.cpp aggiunge F16 a SWIGLU_OAI e corregge GROUP_NORM e slot server: tre build prerelease e un tag, senza benchmark indipendenti.
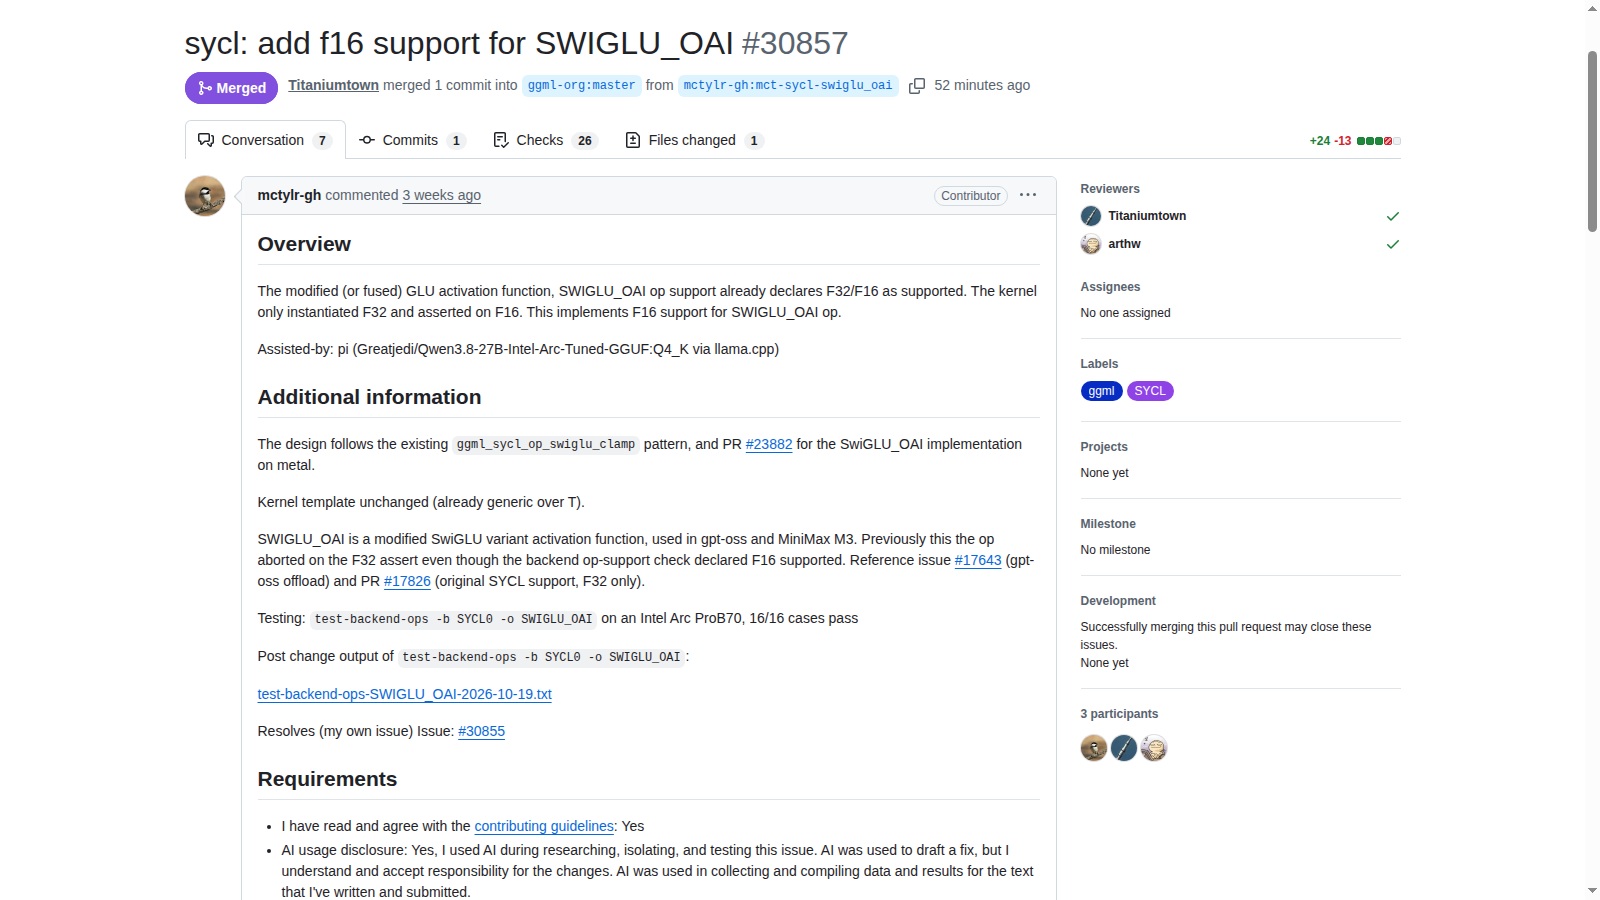
In breve: llama.cpp ha integrato quattro cambiamenti distinti il 7 novembre: supporto F16 per SWIGLU_OAI su SYCL, una correzione GROUP_NORM su Metal, lo stesso operatore aggiunto a WebGPU e un ordine degli slot server che evita un batch aggiuntivo nel caso descritto dalla pull request. Servono a scegliere quale verifica di regressione eseguire sul proprio backend, non dimostrano un aumento generale delle prestazioni. llama.cpp: supporto F16 per SWIGLU_OAI su SYCL.
Metodo: lettura delle quattro pull request ufficiali, confronto del diff SYCL, risoluzione del tag b12190 e verifica delle release GitHub. Il confronto b12187...b12190 contiene i tre commit successivi al kernel WebGPU. Nessuna build è stata compilata o provata qui; i risultati degli autori restano attribuiti alle loro condizioni di test. La data della notizia è il merge del 7 novembre, non l'apertura originaria delle pull request o la data degli allegati.
Che cosa corregge F16 su SYCL?
La pull request 30857 distingue la compatibilità dichiarata dall'implementazione: SWIGLU_OAI risultava supportato in F32 e F16, ma il kernel istanziava soltanto il percorso F32 e si fermava su un'asserzione con F16. Il diff aggiunge il percorso sycl::half e mantiene il controllo che ingresso e uscita abbiano lo stesso tipo. L'autore dichiara 16 casi superati su 16 con test-backend-ops -b SYCL0 -o SWIGLU_OAI su Intel Arc ProB70. È una prova dell'operatore nelle sue condizioni, non un test end-to-end di tutti i modelli o delle GPU Intel.
llama.cpp: supporto F16 per SWIGLU_OAI su SYCL · Diff SYCL: percorsi F16 e F32.
Perché GROUP_NORM su Metal richiede un test di correttezza?
Il merge associato a b12189 corregge un kernel che ignorava la dimensione di batch ne03 e assumeva input completamente contigui. Con più batch una parte dell'output poteva restare non scritta; padding e stride richiedevano un indirizzamento diverso. Le note descrivono statistiche per batch, gestione dell'ultimo gruppo e percorsi specializzati per dati contigui o con stride. Il supporto viene inoltre vincolato a ingresso e uscita F32. Non è l'equivalente del nuovo percorso F16 su SYCL: sono operatori e condizioni differenti, da verificare separatamente.
llama.cpp b12189: GROUP_NORM su Metal, batch e stride.
Che cosa abilita il kernel WebGPU?
La pull request 31490 aggiunge GROUP_NORM al runtime WebGPU ed è inclusa nella prerelease b12187. L'autore cita come motivazione i progetti downstream di diffusione di immagini che richiedono quell'operatore e allega schermate di test e misure su M4 Pro. Questo documenta un tassello di compatibilità a livello di kernel. Non prova che un'applicazione downstream abbia già aggiornato la propria dipendenza, che un intero modello funzioni nel browser o che i risultati siano trasferibili a ogni dispositivo. Prima di aggiornare un'applicazione serve identificare quale revisione del runtime usa davvero.
llama.cpp: implementazione GROUP_NORM su WebGPU · llama.cpp b12187: kernel GROUP_NORM WebGPU.
Quando cambia il batching degli slot server?
La pull request 30779 riguarda richieste /v1/systemone con un prefisso condiviso. Lo slot padre risveglia i figli dopo aver valutato il prefisso; se un figlio con ID più basso veniva visitato prima del padre, perdeva quel batch e rimandava il proprio suffisso. Il nuovo ordine visita gli slot non figli prima dei figli attivi. L'autore riporta 430 test superati e 4 saltati, oltre a una regressione con due richieste successive. È un caso specifico di scheduling: non permette di assegnare una percentuale di riduzione della latenza al proprio servizio.
llama.cpp server: visitare gli slot padre prima dei figli · llama.cpp b12188: ordine degli slot e prefisso condiviso.
Il tag b12190 è già una release scaricabile?
Il tag b12190 punta a f7591a6a01f9273de03331732bdc0b39721168be, lo stesso commit del merge SYCL. Nella verifica delle 15:54 italiane del 7 novembre, l'endpoint ufficiale releases/tags/b12190 rispondeva HTTP 404; b12187, b12188 e b12189 risultavano invece release con prerelease=true. Un tag risolvibile non certifica quindi la presenza di un oggetto release o di tutti i binari. Chi prova dal sorgente deve registrare lo SHA completo; chi usa un pacchetto deve verificare artefatto, piattaforma e contenuto della release scelta, senza scambiare il feed per una certificazione di stabilità.
Riferimento ufficiale del tag b12190 e SHA del commit · Endpoint ufficiale della release b12190, verifica datata · Confronto ufficiale dei commit da b12187 a b12190.
Quale prova fare prima di aggiornare il runtime?
La prima decisione è capire se il proprio problema coincide con uno dei quattro percorsi. Per SYCL è pertinente un input F16 a SWIGLU_OAI; per Metal servono casi GROUP_NORM con batch multipli e stride; per WebGPU conta l'effettiva invocazione dell'operatore; per il server bisogna ripetere richieste con prefisso condiviso e riutilizzo degli slot. Conservare revisione precedente, modello, quantizzazione, driver, flag e output di riferimento rende il confronto interpretabile. Il comando riportato dall'autore SYCL è un punto di partenza, non una procedura da considerare già eseguita o sufficiente per il rilascio in produzione.
llama.cpp: supporto F16 per SWIGLU_OAI su SYCL · llama.cpp server: visitare gli slot padre prima dei figli.
Condizioni e limitazioni
Verifica documentale di merge, tag, diff e release API, senza compilazione o inferenza propria. I test citati sono dichiarazioni dei contributori; nessun guadagno di velocità, supporto completo a un modello o disponibilità di binari b12190 è dimostrato.
Checklist pratica
- Individuare backend e operatore effettivamente usati dal proprio workload; non aggiornare solo perché il tag è più recente.
- Fissare commit completo o release e verificare la presenza dell'artefatto per la propria piattaforma; conservare la versione precedente.
- Per la verifica SYCL proposta, partire dal test dichiarato dall'autore: test-backend-ops -b SYCL0 -o SWIGLU_OAI, dopo una build compatibile.
- Su Metal confrontare il risultato con un riferimento per batch multipli e input con stride; non estendere il supporto F32 a F16 per analogia.
- Ripetere almeno due richieste con prefisso condiviso nel caso server, registrando scheduling, output e condizioni; non trasformare il numero di test upstream in una misura di latenza.
- Separare esito numerico, compatibilità dell'applicazione e prestazioni; riportare come non eseguita ogni prova che manca.
Per scegliere hardware e runtime: Modelli AI locali: come scegliere LLM, hardware e runtime.